完整深入材料 · 保留原页与全部停点。回到相关主讲
工具改进之外,网络本身也会影响观察
本页问题
现在才切换网络与训练条件;不把相邻的多个比较冒充一次因果分解。
GF08/b0 · 旧晚层的困难仍然存在
先看这幅原文保留的 InceptionV1 晚层例子。左边是优化图,右边几张是自然强响应局部:车的格栅、衣服领口、器物等。即使比早期纹理图更清楚,仍然不容易一句话说完。这里不把它偷偷换成现代网络,也不假装我们已经知道所有响应为什么聚在一起。
教师备课:指图与模拟问答
指图与推进 · 不朗读先区分优化图与自然例,保留“仍待解释”的状态。
本态来源与条件
Goodfire · Cammarata 2026 · #inception-last-layer, #ladybug-figure
GF08/b1 · 参数量相当,换成现代架构
现在换到作者自训的 ConvNeXt medium,约七百零六万参数,参数量与前述 InceptionV1相当,数据相同;但是架构和训练条件并不完全相同。图中是末层第一百二十七号单元。从五万张图里取响应最强的二十张,几乎都能沿瓢虫或近似甲虫的视觉结构读下去。标出叶甲的三张不是漏掉的异常,它们帮助我们分清数据集类名与模型实际共享的模式。
教师备课:指图与模拟问答
指图与推进 · 不朗读读模型身份与分母,再依次看20张图,指出第5/14/17张leaf beetle。
本态来源与条件
Goodfire · Cammarata 2026 · #inception-last-layer, #ladybug-figure
GF08/b2 · 把三种比较分清
现在回顾我们做过的三种动作:相同模型换工具;相同架构重新训练;参数量与数据相当但更换架构。这些动作回答不同问题。作者的历史百分比是帮助定位研究状态的粗评,我们不拿它们画精确进步曲线。下一步保留一个具体对象,沿训练 checkpoint看它怎样从田野长到别的东西。
教师备课:指图与模拟问答
指图与推进 · 不朗读三个比较横向列出,明确固定项与变化项。
本态来源与条件
Goodfire · Cammarata 2026 · #inception-last-layer, #ladybug-figure
接下来
如果旧网络里仍有混合,沿训练过程能看到它如何形成吗?
补充推导、边界与来源
左侧保留原文 InceptionV1 晚层单元的优化图与自然例;自然图包含车栅格、衣领、器物等,说明旧网络的晚层确有不容易立即解释的响应。右侧采用作者自训的7.06M ConvNeXt、末层单元127:从50,000张图中按响应排出的前20例,三例原标签是leaf beetle,其余为ladybug。它们视觉相近,不能把类标差异直接视为任意混杂,也不能把20个选例当全分布。
正文有三个不同层次的比较:同一旧 checkpoint 换工具;相同 InceptionV1架构重新训练并采用更合理的现代正则;参数量与数据相当、但引入残差、LayerNorm等改进的 ConvNeXt。作者粗估旧工具约0–5%、改工具约50%、重新训练约70%、相当规模ConvNeXt约99%,这不是统一抽样与评审协议下的可复算进步曲线。本页不把这些数画成柱状图,更不把差值当作某项架构改动的独立因果效应。
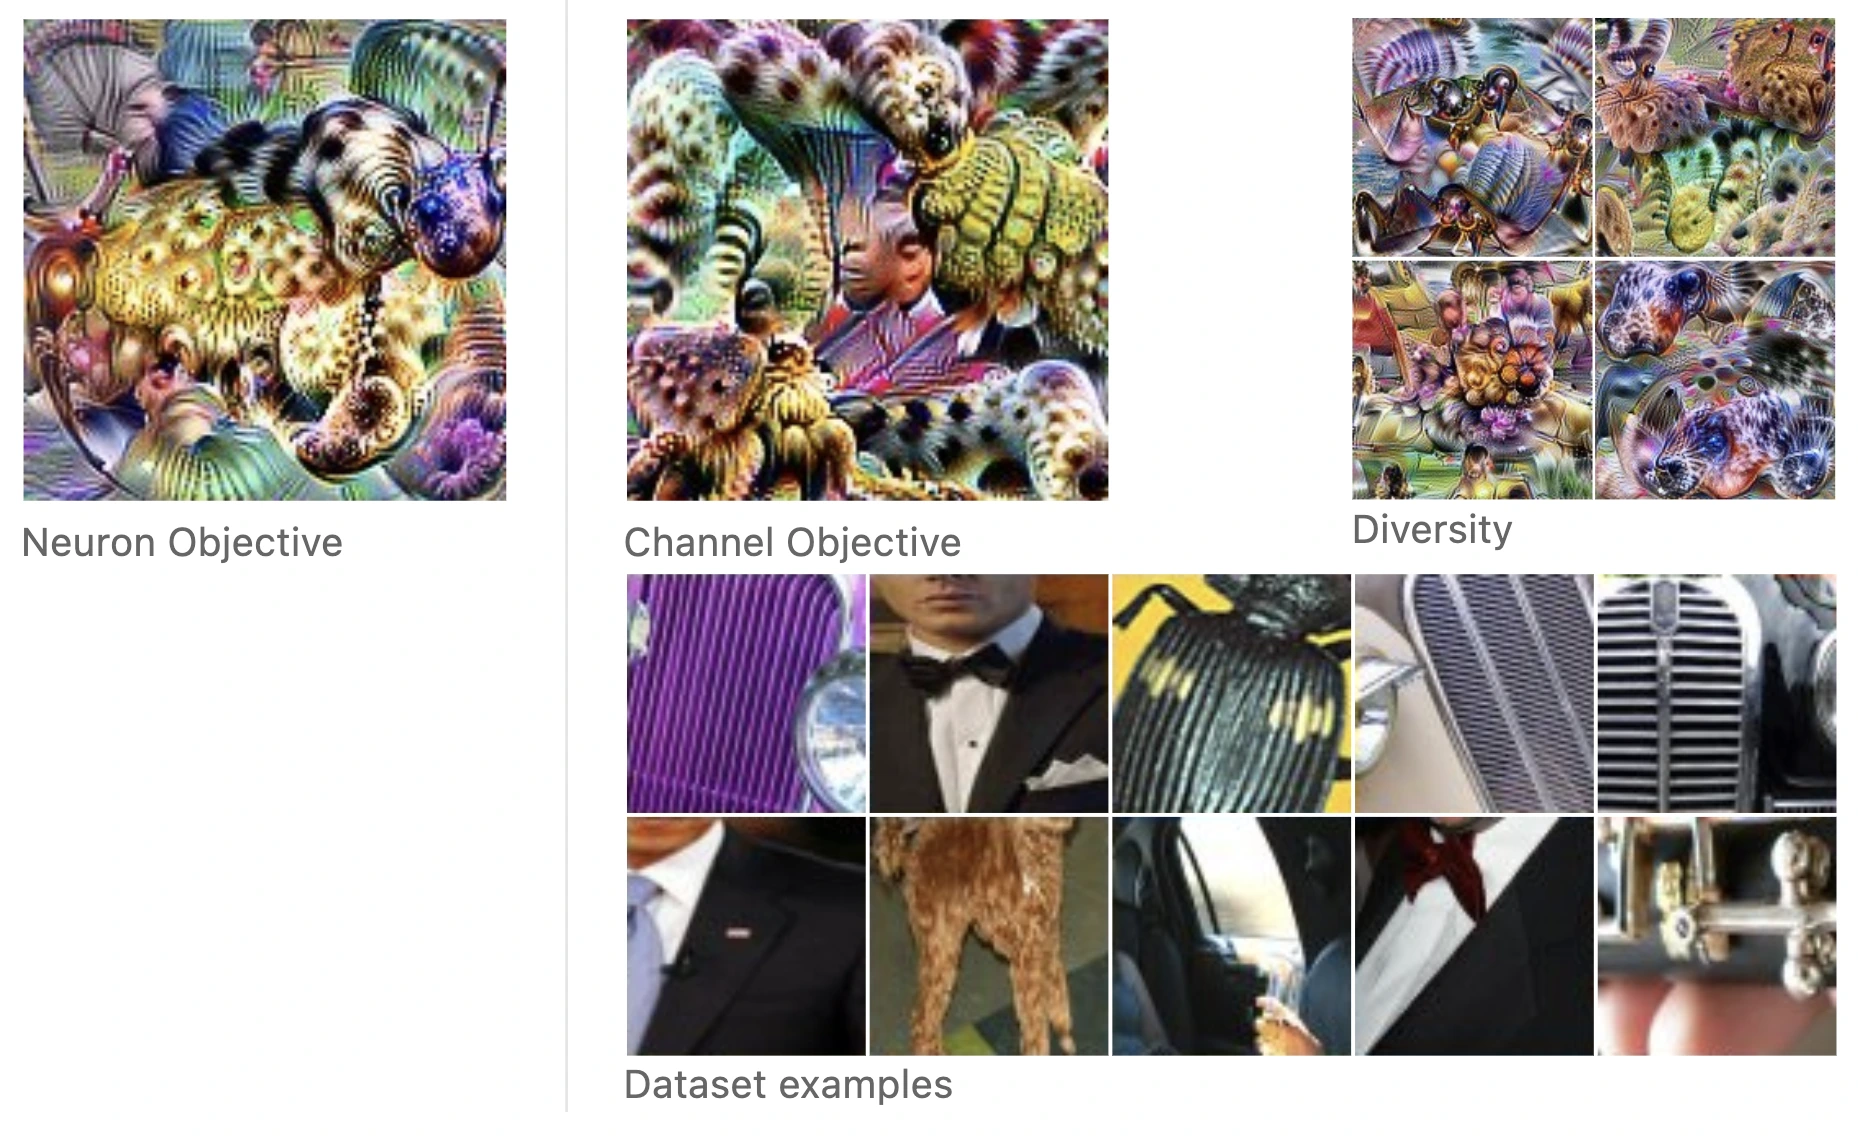
图中优化目标、自然例与多样化视图分区保留;主屏选择局部,不增加新实验。
来源:Nick Cammarata(2026),Goodfire,Neural Networks Are Already Clean。 原图/段落 inception-last-layer。 原图/段落 ladybug-figure。 图与原始照片保留原作者权利;本课按原图选择固定状态、重排并加中文标注,未重跑原文模型实验。
本页证据与条件
Goodfire · Cammarata 2026 · #inception-last-layer, #ladybug-figure