从训练目标到参数更新
用同一份 A/B 记录完整追踪输入、目标、损失与更新。
接着Transformer的信息流,先对齐预训练、规模规律与上下文学习,再追问信息怎样读回、学到了什么、怎样在机器上执行。沿记忆装置、视觉证据与文本训练走到一次具体判断,最后把问题交给搜索、推理与验证。
已经看懂 Transformer 的信息流之后,还需要解释训练后的能力从哪里来。本讲从读回、证据与执行三个问题继续。
Transformer 的结构规定信息经过哪些计算:当前输入经 attention 读取与 MLP 变换,形成输出;训练参数是这些运算持续使用的对象。知道信息流,并不等于已经解释了训练后的全部能力。本讲接着追问:信息如何被承载并读回,哪些观察足以支持“学到了什么”的判断,以及计算、存储和搬运如何限制实际执行。
图中只保留上一讲可识别的信息流,不是完整 Transformer 堆栈,也不把整个模型简化成一层 attention 和一层 MLP。输入示例来自 Lecture05;输出位置用于说明计算方向,不代表现场运行结果。三问是本讲选择的观察视角,不穷尽能力形成的全部原理。
Lecture05 熟悉句子的课程回访;图为计算关系示意,不是模型实测。
可以沿三问检查一个新模型:先指认它用到的信息,再说明支持能力判断的证据,最后列出执行所需对象。三个答案可以来自不同实验,不能用一张结构图同时代替。
用同一份 A/B 记录完整追踪输入、目标、损失与更新。
区分长期参数和本次输入形成的读取状态。
先区分两类变化:训练把什么留下来,当前输入又怎样影响这一次计算?
训练支路是“数据与目标→优化更新→参数”;使用支路是“参数+当前上下文→输出”。预训练与后续 SFT 都可以更新参数,但用途与训练材料不同;SFT 不是所有模型必经的固定阶段。常见 ICL 设置把任务说明与示例放入当前上下文,不在本次任务适应中更新模型参数。训练目标、投入规律与使用方式提供共同基础,本讲随后会深入它们背后的承载、证据与执行问题。
ICL 在这里指 GPT-3 论文所采用的无梯度任务适应设置。当前输入会改变中间表示、K/V 等状态和输出分布,“参数不更新”不等于“计算没有变化”。后续适配还有其他形式;本页只借 SFT 定位参数更新,Scaling Law 则用于研究投入关系,不是第三个训练阶段。
训练/使用关系为课程示意;ICL 的无梯度设置核对 GPT-3 原论文。
要判断改变会持续到哪里,先检查是否执行了参数更新。上下文中的示例还可能通过改变注意力读取和中间表示影响输出;这种当次计算变化与优化器更新参数有不同的持续范围。
从原始材料、下一项目标到损失,展开一次训练过程。
用 prompt 与回应目标说明后续监督如何更新参数。
原论文图2.1和方法部分区分 zero-shot、one-shot 与 few-shot。
同一句原文可以怎样提供学习信号?对照前缀预测与遮挡预测,找出输入和目标的位置。
同一句原文本可以提供两类训练信号。下一 token 预测给出前缀“我/昨天/给了/他/一本”,目标是原句下一项“书”;遮挡语言建模给出“我/昨天/给了/[MASK]/一本/书”,目标是被选中位置原有的“他”。模型的预测与这些目标比较,形成用于更新参数的误差信号。目标的存在不意味着模型预测正确,也不意味着该前缀只有一种语言上合理的后续。
中文词块是为了对齐输入与目标所作的教学切分,不是真实 tokenizer 的运行结果。两行是不同目标的并列示例,不是同一模型必经的连续阶段。BERT 原论文预训练还使用 NSP;本页只借其 MLM 目标说明遮挡预测。MLM 的训练目标是原位置 token,而不是任意语义合理的替代词。
下一 token 的完整样本、对齐、loss 和更新在 RC-P 段展开。视觉 MAE 的遮挡、像素预测与损失位置会由自己的模型与证据说明。
中文切分为教学构造;MLM 目标核对 BERT 原论文 §3.1,未展示模型实测预测。
自监督目标由数据构造,但并不省略误差计算与优化。一个训练位置的目标确定,不等于语言中只有一个合理续写;损失衡量的是对给定训练目标分配的概率。
在 A/B 记录上继续看目标右移、预测计分和参数更新。
原论文3.1节说明如何从可见上下文预测被选中位置。
投入增加时,损失怎样变化?预算不变时,又该怎样分配模型规模与训练数据?这两个问题需要分开。
在特定模型、数据与训练范围内,扩大模型规模和训练投入,交叉熵损失可呈近似幂律下降。这种经验趋势可以拟合,却不是“参数越多,所有能力必然越好”。若训练计算预算固定,则要共同选择模型参数量 N 与训练 token 数 D:把预算更多分给模型,就会限制可用于训练的数据量。总投入增加与固定预算内分配是两个不同问题。后文再用原论文实验图比较配置;这里不设通用指数或最佳比例。
Kaplan 等人的 Scaling Laws 研究特定模型、数据与计算条件下的损失关系;Chinchilla 研究固定训练计算预算下模型参数与训练 token 的分配。不同研究的训练条件与最优拟合不能混成一个不变比例,训练计算最优也不等于部署的经济最优。
定性关系图;一手依据为 Scaling Laws 与 Chinchilla,不含新增实测曲线。
“近似幂律”表示在所研究范围内,投入按比例扩大时,损失的变化可由经验函数拟合;它不是每次加同样数量参数就下降相同损失。固定预算问题则比较多组 N 与 D 的组合,而不是在原训练量上无限增加参数。拟合的指数、最佳比例和适用范围要回到各篇论文,不能跨实验直接照搬。
正文结合 Chinchilla 实验图比较参数规模与训练量。
阅读模型、数据、训练计算与交叉熵损失的经验关系和适用条件。
比较固定训练计算预算下模型大小与数据量的分配。
保留同一份 A/B 事实,只在输入前加入 C/D 示例。观察这一步改了什么,又没有改什么。
当前 A/B 材料为“A 用时12秒,B 用时8秒,未测量内存”,任务要求概括结果并保留未知。另一份输入在同一任务前加入 C/D 示例:“C 用时10秒,D 用时7秒,未测能耗;D 在本次测试中耗时更短,能耗尚未比较。”两份输入共用模型参数,差别是上下文有没有示例。示例提供回应组织方式,不能替代 A/B 的事实;本页没有展示 A/B 的模型实测输出,也没有保证示例一定改善结果。
全部 A/B、C/D 数值为课程教学构造。C/D 的文本是示例答法,不是模型运行记录。常见 ICL 使用不执行参数梯度更新,但输入改变会使当前表示与输出分布变化;任务效果应另行评价。
A/B、C/D 为教学构造;无梯度 ICL 概念核对 GPT-3 原论文。
若要评价示例的作用,应固定模型、任务材料和评分方式,只改变示例条件,并在多个输入上比较。这里先用输入对照明确变量,随后正文再将条件比较与实际输出分开讨论。
从当前输入 X 到 K/V,区分固定参数与请求状态。
查看有无示例、回应组织与事实保留的具体区别。
一次补全可能来自片段记忆,也可能利用可复用关系。怎样把“学到规律”的直觉变成可检查的问题?
在“我昨天给了他一本书”中,具体词序可以作为片段保留,“谁/何时/给谁/什么”的关系也可成为待研究的可复用结构。预测利用重复信息;压缩视角提醒我们,复用规律可能减少对每个例子的单独描述。但片段记忆与规律学习并不互斥,也不能仅凭一次正确补全辨别内部用了哪一种。需要进一步追踪信息的表示与读取,并设计能区分解释的新观察。
角色结构是教师用于提出问题的语言分析,不是该模型内部状态的实测可视化。这里不主张“压缩=智能”的等式,也不把记忆贬为死记或把泛化说成与记忆无关。后面的随机检索装置只使一个读取问题可追踪,不代表完整大模型学习机制。
句式与压缩关系为教学直觉及待检验解释,不是模型内部实测结论。
区分解释需要设计会产生不同预测的输入,例如保留关系而更换具体词语,或保留熟悉词语却改变关系。结果可以约束“仅记片段”的解释,但仍不能凭一个成功例子定位网络中的全部机制。
从 A/B 记录的后续预测理解不同位置依赖的结构。
固定查询和目标,观察关联增加时读回的改变。
固定查找线索与目标内容,只增加其他关联。先认清查询、存储与读回的分工,再观察干扰。
关联读取把查找线索与目标内容分开:查询提供线索,存储保存关联,读回结果再与目标比较。随后实验固定查询和目标,只增加其余写入的关联,观察读取是否被干扰。这使“容量”不再仅是累计存入条数,而是需要同时指定写入方式、读取方式及正确性的判断标准。此处只是引入实验对象,尚未展示结果或容量公式。
查询与目标来自 AR01 的同一教学随机向量实验。目标图样将64个分量排成8×8,便于比较,不是自然图像理解任务。
同源随机向量读取示意,沿用 AR01 与 Alex Wang 推导的条件。
检索的评价对象是读回向量与目标向量的差别。把向量排成图样便于看见差别,数值指标仍要使用同一尺度和误差定义,不能只凭图像看起来相似就认定读对。
查看查询、目标、存入关联数与干扰指标的完整实验。
展开写入、读取、随机向量假设和误差标准。
任务结果与内部响应回答不同问题。先辨认两组材料的模型身份,再看观察怎样引出检验。
MAE 的遮挡输入、预测与原图,允许比较模型完成任务的方式与误差;Goodfire 的猫车材料来自另一模型 InceptionV1,用于观察某个内部单元在哪些输入上响应较强。两者不是同一模型连续开展的实验。任务成绩说明能做什么,内部响应帮助提出解释,新例、近反例及受控干预再检验解释的支持范围。可视化的价值在于使这些比较可观察,而不是仅凭漂亮图像宣布机制已被证明。
MAE 的重建质量与下游任务能力需要分别评价;Goodfire 图像模型观察、语言模型归因及消融也需保持实验身份。单元的激活图不单独建立因果性,特定条件的局部干预也不推出所有单元都有唯一功能。
MAE 与 Goodfire/InceptionV1 原始素材,模型和实验身份分开;本页不展示新增实测。
表现、解释和干预之间需要可追溯的桥梁:先确定输入和测量对象,再提出能预测新例的解释,最后选择真正改变内部计算的操作。一次干预支持的结论仍受输入与对照范围约束。
看同一校车图的遮挡、重建与原图如何构成训练信号。
从真实高响应图像提出解释,并寻找下一步检验。
区分自然样例、内部观察、归因、消融和解释评价。
让一次矩阵计算真正发生,除了运算,还需要哪些存储与搬运?沿同一份参数和当前状态追踪。
可执行的计算包含参数与当前状态的存储、读取、运算和结果写回。计算量、存储容量及数据搬运是相互关联但不同的约束;算式正确,并不保证设备装得下或能以可接受的延迟执行。训练需要保存与更新有关的额外对象,使用需要处理当前请求状态。规模的收益取决于数据与训练条件,实际选择还须同时衡量执行代价。
本页是硬件执行的机制示意,没有指定 GPU 型号、吞吐实测或通用价格。训练状态账、分片、分块 attention、prefill/decode 与 KV 的具体对象与边界,保留在正文系统段逐一建立。
计算、存储、搬运关系为教学示意;未给出硬件基准或通用最优配置。
计算、存储与搬运并不总是同时成为瓶颈。同样的算式可因工作集大小和数据复用方式不同而产生不同等待;要改善执行,必须先识别当前资源限制。
从8B教学配置区分权重、梯度、主权重和优化器状态。
看分块 attention 保留计算关系而改变读写组织。
区分 prefill、逐步生成与 K/V 追加。
从可追踪的读取装置出发,再看真实模型的任务与内部证据,最后回到文本训练和实际选择。
课堂先由联想记忆建立可追踪的写入、读取与容量问题,再用视觉任务和内部机制研究区分表现、解释与检验。视觉段之后的短计算桥说明同一表示怎样执行,然后回到文本预训练、上下文使用、训练和推理资源,最终依据新测量修正选择。下方的查询—存储—读回对象与下一页 AR01 相同:查询和目标固定,接下来只增加关联。
路线中的视觉证据提供观察与检验的方法,不直接证明所有语言能力。联想记忆只打开一种可计算读取装置,正文随后建立外积、串扰、写入改动、非线性读取以及与 attention 的关系。
课程路线示意;读取对象同源于 AR01 的教学实验。
这里先把写入和读取变成可计算对象,再把视角移向真实模型。前者解释一种装置如何工作,后者检验训练和内部行为;两者相连,但不能彼此替代证据。
进入 AR01,认识 key、value、查询、目标和已存关联数。
按实际课堂顺序阅读同源图解与每一步解释。
关联记忆把线索key与内容value成对保存。查询是拿来查找的线索,目标是希望读回的内容;两者不必相同。本例将64维value排成8×8灰度方格,固定目标和查询,只把同一存储数组的前缀从1条扩展到16、64、256条。读回中的目标贡献仍在,其他条目的贡献却逐渐混入。可用性因此要由读取结果判断,而不能仅数已经写入多少条。
沿用刚才的读取装置。我们存一对关联:线索key用来查找,内容value是希望取回的东西。画面中的k₀是固定查询,v₀是目标内容,M表示已存关联数。现在M等于一,读取Wk₀与目标相同。图样只是把六十四个数排成八乘八,方便比较,并不是让模型识别一张照片。随后只增加其他关联,看看同一查询还能否读清同一目标。
关联对的记号为(kᵢ,vᵢ),下标i标识条目。固定查询取第0条的key,目标是同一条的value;M增加时沿用同一数组前缀。key与value都为64维,但其职责不同。
目标内容和查询都不变,只有存储中参与写入的关联数增加:十六、六十四、二百五十六。把每档读回与最左侧目标逐格比较,目标的结构越来越被其他变化淹没。原来那一条仍参与写入,问题是其他条目也在这次读取里贡献了内容。因此“已经存入”与“此刻能单独取回”不是一回事。
同一数组的前缀;seed=20261021。显示灰度统一为[−0.125,0.125],只裁剪显示,不改变指标。
把想要的贡献叫信号,把其他条目的贡献叫干扰。这里用干扰范数除以目标贡献范数,得到R。四档分别约为零、零点四五五、一点零三九和二点一四二。R等于一,只是一条方便的比较线:干扰与信号差不多大,不代表所有任务在这里一起失效。接下来去掉图样,只存两组线索与内容,亲手算清楚干扰从哪里来。
本页R=‖读出−目标贡献‖/‖目标贡献‖,指标按未裁剪向量计算。它不同于之后跨随机样本取平方期望再开方的理论RMS曲线。
这里的目标不是证明模型记住了图像,而是为“记住”选一个可检查的读回标准。同一查询、相同数组前缀和固定灰度,使变化能追溯到新增关联。
要理解大模型为什么可能用上更多知识,先分清结构的承载能力与训练形成的实际能力。
“先能记住,再讲怎样训练”是解释次序。实际训练时,数据、目标和参数更新一起发生,不存在先把空网络训练完、再把知识放进去的机械流程。
Alex Wang:对应原文小节。两个必要视角是本课程的开场组织,不是原文逐字开场。
M01 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
先用同一查询下的读回质量,给“记住”一个可检查的含义。
本节实验关注向量读回的保真程度。分类只要求正确候选胜出、生成只要求相关token更有可能时,可以采用不同指标;相应容量不能直接比较。
I03 原阅读材料 · M02 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
从key、value、查询和目标的不同职责开始,给出四档读回与未裁剪干扰指标。
把64维图样换成二维A/B例,逐步计算外积写入和查询读出。
展开随机单位向量、RMS比值和比较阈值,分清向量检索与现实知识。
固定查询、目标和记忆前缀,比较 M=1、16、64、256 的读回。这里是受控关联记忆计算。
二维A/B装置把串扰变成可手算的结果:k_A=v_A=(1,0),k_B=(0.6,0.8),v_B=(0,1)。外积写入W=Σvᵢkᵢᵀ得到[[1,0],[0.6,0.8]]。查询A时,Wk_A=(1,0.6)=v_A+0.6v_B;B的key与查询内积不为零,因此B的value也参与输出。A的key与value恰好相同只是选数巧合,B清楚显示二者的不同职责。
刚才的八乘八图样来自六十四维向量;现在换成能手算的二维例子,线索与内容的角色保持不变。A的key是(1,0),value也是(1,0),这只是选数巧合。B的key是(0.6,0.8),value却是(0,1),可见查询线索不必长得像要取回的内容。两个key长度都是一,方向并不垂直。先把这两对关联放在固定位置,W从零矩阵开始。
先把A的value排成一列,把它的key排成一行,相乘形成一个两行两列的矩阵,这叫外积。得到的矩阵只有左上角是一,其余为零。把它加进W,以后遇到A这样的线索,就会沿A的内容方向输出。这里请看清尺寸:写入的是一块和W同样大的矩阵,不是把一个标签塞进某个独立格子。
$v_i\in\mathbb R^{d_v}$、$k_i\in\mathbb R^{d_k}$均为列向量,故$v_i k_i^\top\in\mathbb R^{d_v\times d_k}$。
B也产生一块外积矩阵,这次非零项在第二行,是零点六和零点八。我们没有给B另开一个抽屉,而是把两块矩阵相加。W现在的第一行是一、零,第二行是零点六、零点八。继续累加非常容易;但这只能说明两条都参与了写入,是否能单独读出,需要下一步检查。
现在把A的线索(1,0)交给W。第一行与它相乘得到一,第二行得到零点六,所以输出是(1,0.6),而不是目标(1,0)。A的一份内容还在,但B也跟着贡献了零点六份。请注意,我们没有在读出之后加入噪声;这个混合是刚才那次矩阵乘法本身产生的。
把同一计算展开:先算查询和每个key的内积,再用这些分数加权value。A和自己匹配得一,B与A匹配得零点六,因此答案就是一份A加零点六份B。这里的系数可以带符号,也不必加起来等于一,所以还不是概率。两条时已经能看到串扰;接下来问条目继续增加、或线索维度变大时,干扰会怎样积累。
A/B例与开场随机64维图样是不同实验。此处保留职责与读取规则,不保留维度或随机样本。查询A时B产生0.6的交叉项,正是两条key内积为0.6。
可展开检查查询B:$Wk_B=(0.6,1)^\top=0.6v_A+v_B$。这与查询A的串扰对称,完整画面见AM04/b2。
本段始终使用两条目、列向量约定。两个外积的和为 W=[[1,0],[0.6,0.8]];读取是先匹配再汇总。旧三条目行向量算例仍在完整阅读中,但不混入此处计算。
目标仍被保存,读出却可能夹杂别的内容;现在用两组向量把装置拆到能手算。
W=Σᵢvᵢkᵢᵀ,W∈R^(d_v×d_k)。本例两个外积分别是[[1,0],[0,0]]、[[0,0],[0.6,0.8]]。
I02 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
两次外积已经加到同一个W,接下来检查能否只读回目标。
Wx=Σᵢvᵢ(kᵢᵀx);对单位key查询k_j,Wk_j=v_j+Σ_(i≠j)vᵢ(kᵢᵀk_j)。
I03 原阅读材料 · M02 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
保留A/B向量、两个外积矩阵及相加后的W,按列向量约定核对尺寸。
展开Wx=Σvᵢ(kᵢᵀx),同时核验查询A与查询B。
由交叉项平方期望解释干扰随M与dₖ变化的趋势。
从固定的二维例子转到随机单位key/value,可以分开比较条目数与维度。在外积写入、精确查询假设下,干扰RMS比值为√((M−1)/dₖ)。固定dₖ=64,增加M使曲线上升;固定M=128,增加dₖ使曲线下降。R=1只是一条共同参照线。扩大空间、联合选择写入权重、改变汇总前的响应,是作用于不同对象的三条改进路线。
先把二维小例子换成很多随机单位线索,key的维度固定为六十四。横轴是条目数,纵轴是理论RMS干扰与目标项的比值。单个无关匹配通常不大,但很多小贡献仍会合成可观干扰。曲线在约六十五条达到R等于一。这个量级描述当前假设和指标,不是一道所有记忆任务共同的失效开关。
独立各向同性单位value使交叉项期望为零;$R_{RMS}=\sqrt{(M-1)/d_k}$。这里先对平方干扰取期望再开方,不是一次抽样错误率。
现在横轴换了,请先看轴名:不再增加条目,而是固定一百二十八条,增加key的维度。曲线向下,因为随机线索在更高维空间中通常更容易分开,无关内积更小。扩大空间确实是一个办法,但相关矩阵和计算也会变大。我们还可以保留空间大小,改变写进去和读出来的方法。
回到A的查询。沿同一次计算,可以改三个地方:增加线索的维度,重新选择写入后的W,或者改变匹配分数参与汇总的方式。这三件事不能混称为“把模型做大”。刚才第一条已经看到了。下面先保留两条关联和两行两列的W,只重新选择四个权重,检查是否能够把两条都读对。
三条路线改变不同对象:维度改变表示空间;联合拟合改变写入矩阵;非线性改变汇总前的响应。这一态只建立选择位置,随后先沿写入路线核验。
有限维修正使dₖ=64的外积RMS比较线位于M=65,常用量级说法约为64。负匹配不能简单按绝对值累加;相消也不保证干扰为零。
二维例解释干扰来源,随机向量模型继续检查条目数和维度的影响。
独立零均值、各向同性、单位长度value使交叉项的期望消失。随机单位key有E[(kᵢᵀk_j)²]=1/d_k,故外积存储的平方平均干扰/信号为(M−1)/d_k,RMS比值为√((M−1)/d_k)。常用量级写法√(M/d_k)忽略一条目标记忆。不要把每一项绝对值简单相加成M/√d_k,也不要说正负相消后必然没有噪声。
I03 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
扩大维度不是唯一改进办法,写入与读取也可以分别调整。
M03 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
给出√((M−1)/dₖ)的来历,区分一次抽样与理论平方平均。
在同一装置上定位三类可改变的对象,接回下一页联合拟合。
核对独立key、伪逆、过载投影与噪声查询的不同条件。
外积直接累加不是唯一写法。令同一个2×2矩阵同时满足Wk_A=v_A、Wk_B=v_B:A的约束固定第一列为(1,0),B再给出0.6+0.8b=0、0.8d=1,所以W*=[[1,−0.75],[0,1.25]]。两条key保持不变,读回却都精确。推广到64维时,线性独立条件下M≤64的精确恢复区,与过载后约M=128达到R=1的区间不同;更好的写法延后干扰,但没有无限容量。
原先把两次外积直接相加,没有要求每一条都单独读对。现在改写入办法:一起求一个W星,使W星乘A的key得到A的value,乘B的key得到B的value。A的key是(1,0),所以矩阵第一列必须是(1,0)。B又要求第一行的零点六被抵消、第二行得到一,因此另外两个数解成负零点七五和一点二五。尺寸仍是两行两列,线索和内容也没变,变的是四个权重如何联合选择。先查A:新读出恰好是(1,0)。
令W=[[a,b],[c,d]]。Wk_A=v_A给a=1、c=0;W*k_B=v_B给0.6a+0.8b=0、0.6c+0.8d=1。故唯一解为[[1,−0.75],[0,1.25]]。本例展示改写入的可行性,不声称真实网络用这一步解析求逆完成全部学习。
再查B。W星第一行给出零点六减去零点七五乘零点八,结果为零;第二行给出一点二五乘零点八,结果为一,所以读回(0,1)。原来外积W会读出(0.6,1),比较就能看到串扰被消掉。两条key始终没有变得正交;这两个独立方向可以由合适的线性变换分开。新W不是凭空出现的标准答案,而是由两条读回约束共同求出的。
这里解的是无正则最小二乘问题;有限独立key的可拟合性,不保证噪声查询、病态矩阵或未见输入也能精确读回。
回到六十四维的曲线,灰色仍是外积累加,蓝色是联合拟合。key线性独立时,六十四条以内可以精确恢复;这段零误差区和后面约一百二十八条才达到R等于一的区域要分开。过载部分采用各向同性近似,两条曲线后段仍会升高。更认真写入延后了问题,却没有消除问题。那就回到读取:弱匹配能否少贡献一些?
过载投影中目标项是$P_{jj}v_j$,不是固定的$v_j$;R约为$\sqrt{M/d_k-1}$。约2dₖ是干扰/实际目标项阈值,不是精确恢复条数。
W*=[[1,−0.75],[0,1.25]] 可直接核验两次乘法。拟合范围、精确恢复区和过载阈值各有不同含义,完整伪逆与投影推导保留。
先改写入:key/value与矩阵尺寸都不变,只重新选择权重。
求解min_W Σᵢ||Wkᵢ−vᵢ||²。本例代入可直接核验:W*k_A=(1,0);W*k_B=(0.6−0.75×0.8,1.25×0.8)=(0,1)。独立key数量不超过输入维度时,无正则的线性回归可拟合所有这些指定关联。病态key、数值精度、噪声查询是另外的问题。
I02 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
手算例说明写入能改善;曲线检查改善在哪个范围成立。
M>d_k且K满列秩时,W*=VᵀK(KᵀK)⁻¹。权重矩阵P=K(KᵀK)⁻¹Kᵀ是投影,目标贡献是P_jj v_j,不能仍把目标系数写成1。由Σ_(i≠j)P_ij²=P_jj−P_jj²,若P_jj≈d_k/M,比值近似√(M/d_k−1)。因此约2d_k是“干扰约等于信号”的量级,不是精确恢复2d_k条。全节R的分母是实际目标项a_jj v_j,所以它不普遍等于||f(k_j)−v_j||/||v_j||,更不是错误率。
I03 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
保留两条key/value,核对W*两行乘法和线性独立条件。
用64维曲线区分M≤64零误差区和约128的R=1阈值。
展开过载区的P矩阵及实际目标贡献,解释为什么不能说精确存128条。
此处回到原始key匹配分数[1,0.6],不使用W*的输出。对分数逐项施加ReLU不改变这两个正数,再平方得到[1,0.36],最后才汇总value。输出由v_A+0.6v_B变为v_A+0.36v_B。顺序决定含义:处理每条关联的响应与处理混合后的内容坐标不同;本页也没有将分数归一化为概率。
刚才改的是怎样写入。现在走另一条路,明确回到最初两条key的匹配分数:A是一,B是零点六。这里没有接着把W星的正确答案做平方,也不重新训练W。我们保留每条匹配,在它们汇总成答案之前,单独改变每条内容能够贡献多少。
本页从联合拟合路线退回原始K/V匹配,以隔离读取规则的作用。始终不使用W*输出作为非线性函数的输入。
ReLU先把负分数截成零;不过眼前两个数都为正,因此只做ReLU并没有改变它们。再平方,一仍是一,零点六变成零点三六。目标保持,较弱的正匹配相对下降。顺序很关键:先对每项响应做非线性,再汇总value;不是对已经混在一起的输出做一次平方。
于是同一查询从一份A加零点六份B,变成一份A加零点三六份B。B并没有消失,只是少贡献了一些。我们现在获得的是选择性的具体机制,不是一个能保证任何数据都检索正确的开关。把刚才发生的三个动作连起来:比较线索、逐项非线性、再汇总内容,看看它像哪一种已经见过的网络。
本页未归一化。$f(x)=\sum_i v_i\sigma(k_i^\top x)$;平方ReLU是$\max(s,0)^2$。
线性写入仍有边界;现在回到原始相似度,只改读取规则。
f(x)=Σᵢvᵢσ(kᵢᵀx);本页没有归一化。平方ReLU是max(s,0)²,不是对所有带符号相似度直接平方。负相关项先被截断,避免把强负匹配变成强正贡献。
M03 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
在A/B算例中分别看ReLU截负、平方压低弱正响应以及输出变化。
把同一计算链对应到W₁、σ、W₂,说明手工构造与训练模型的差别。
匹配线索Kx、逐项非线性σ、组合内容Vᵀσ(Kx),构成两层MLP的计算形式。将K和Vᵀ分别称为W₁和W₂,运算本身不变。在手工构造中,中间宽度H=M,每条候选占一个响应;真实模型的方向由训练共同形成,不必逐行对应人类事实。随机检索曲线说明非线性可改变干扰积累,显式K/V的存储也随M增长。
我们不是先摆出一个MLP名词,再给它找用途。刚才解决读取问题时,已经走出了这条计算链:第一个矩阵把输入与不同线索比较,中间逐项施加非线性,第二个矩阵把各项响应组合为输出。请沿箭头再走一次,计算对象还是同一批线索、响应和内容。两层MLP的形式就在这三个动作里。
MLP是多层感知机;此处指带逐项非线性的两层前馈结构。先辨认已经做过的三个动作,再给W₁、W₂名称,避免把命名当作新的运算。
把第一个矩阵叫W一,第二个叫W二,运算并没有换。显式构造中,每条候选占一个中间响应,所以宽度H等于条目数M。真实模型中的方向由训练形成,不必一行对应一条人类能命名的事实;多个方向可以共同参与一个判断。这个关联记忆视角帮助我们理解计算,不是把MLP直接还原成一格一条的知识字典。
真实FFN还可能带偏置、门控、残差与归一化。Geva等研究支持参数化关联解释,但不能由此推出知识全部储存在MLP或一单元一事实。
换回同条件随机检索,灰色是线性,紫色是ReLU,绿色是平方ReLU。每个无关条目少贡献一点,很多项累积起来,达到同一条R等于一的线就要更多条目。这里平方曲线到千条量级,当前球面RMS口径约二千八百一十七。与此同时,显式K/V也随条目数增长;曲线比较的是读取规则,不是在固定总参数量里免费塞入更多知识。
平方RMS阈值2817与原博客近似约2700分开标识。立方约38299、SwiGLU特设及完整高阶矩推导在AM11完整阅读,不进入默认下一步。
保留显式构造H=M这一条件。容量曲线不能直接解释固定宽度MLP能记住多少现实事实。
匹配、非线性与汇总的操作已建立,现在辨认其网络形式。
Geva等在其研究模型中将FFN的key响应与文本模式、value与输出分布联系起来,并分析多个记忆贡献的组合。本页只采用这一受实验支持的解释,不把全部知识归属到MLP,不把每个hidden unit等同于一条事实。偏置、残差、归一化和门控结构另在材料中展开。
M04 原阅读材料 · P05 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
从单个弱匹配的降低,走向大量随机候选的整体干扰。
对球面均匀单位key,s=kᵀx,精确查询目标得分为1。E[ReLU(s)^(2p)]=(2p−1)!!/[2d_k(d_k+2)…(d_k+2p−2)],因此RMS干扰比为这一矩乘M−1再开方。大维度近似给出平方和立方的不同常数,不能只写d_k^p后把它当精确计数。独立复算在d_k=64时,平方ReLU的RMS阈值约2817;blog中常用近似约2700,二者指标/近似口径应分别标明。
M03 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
给出K/V与W₁/W₂的尺寸对应,说明一单元一事实为何不是结论。
保留各条RMS曲线、阈值和显式K/V存储随M增长的条件。
展示指数级数及截断曲线,并解释低阶常数项和负响应的边界。
二维A/B例固定β=4,原匹配分数[1,0.6]经指数成为[54.598,11.023]。B/A由0.6降为约0.202,因此选择性增强;两项绝对值变大不妨碍相对干扰减小。再除以共同总和65.621,得到[0.8320,0.1680],比例不变、总和为一。最后用这两个权重汇总value,仍然得到混合输出。它与常用attention公式的尺度写法不同,计算职责一致。
仍是同一组A/B关联,原分数是一和零点六,这一页锐度β固定为四。取指数后分别约为五十四点五九八和十一点零二三;两个绝对值都变大了。但以A为一份,B只剩零点二零二份,比原来零点六少得多。我们关心的是B相对于A有多大,不能仅看指数输出是否变大来判断干扰。
二维演示β=4:exp(4)=54.598150、exp(2.4)=11.023176,B/A=exp(−1.6)=0.2018965。尚未进入64维容量实验。
现在把两项都除以同一个总和六十五点六二一,得到约零点八三二和零点一六八。看权重条,A占百分之八十三点二,B占百分之十六点八。总和变成一,而B与A的相对比例没变。读回因此仍是两个value的混合,只是更偏向A;归一化不是突然把B删除,更不是把胜出标签直接当答案。
归一化分母65.621326;权重[0.832018385,0.167981615]。数值稳定实现先减最大logit再指数;只除以总和不能避免溢出。
匹配、取指数、除以总和、汇总value,就是softmax注意力的基本读取过程。上一讲通常把QK转置除以key维度的平方根;这里先将向量规范成单位长度,再用β表示锐度。尺度约定不同,比较的仍是匹配强弱。两条关联上的机制已经清楚:指数拉开比例,归一化给出总和为一的分配。下一页才切回六十四维、许多随机候选,用相同指标检查它能走多远。
列向量约定$f(x)=V^\top\operatorname{softmax}(\beta Kx)$。标准attention为$\operatorname{softmax}(QK^\top/\sqrt{d_k})V$。若q、k典型长度约√dₖ,可对应单位向量约定下β≈√dₖ,并非任意训练模型的精确恒等式。指数与幂次的完整支线:见AM12/b1、b2,另用dₖ=64、β=8,不能混为本页条件。
本页整个默认过程固定二维[1,0.6]、β=4。指数与幂次的联系完整保留在AM12深入阅读;AM13保留缩放、稳定实现和原公式。
提高幂次以外,指数也可以改变强弱匹配间的相对贡献。
exp(βs)=Σ_(p≥0)(βs)^p/p!。所有指数项整体除以目标权重后,非目标项相对权重为exp(β(s_i−1))。本页β=4仅为二维演示,后面的随机64维容量实验另用β=8,切换处必须明示。
I04 原阅读材料 · M03 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
回到两条key、β=4的例子,把正响应归一化成总和1。
用列向量查询记号,f(x)=Vᵀsoftmax(βKx)。标准attention为softmax(QKᵀ/√d_k)V,差别包括行列约定和Q投影。若q、k的典型长度约√d_k,其内积缩放可对应单位向量约定下β≈√d_k,不是对任意训练模型都精确成立。实现稳定softmax需先减最大logit,再指数和归一化;仅“除以总和”不能保证计算中不溢出。Transformer原论文。
I04 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
列出β=4的指数、共同分母、归一权重及value混合输出。
比较单位向量β与QKᵀ/√dₖ,并解释先减最大logit的数值作用。
改用64维β=8的独立曲线实验,保留不同截断项的条件与结果。
容量对照重新采用64维随机单位key/value、精确查询和β=8,不延续上一页二维β=4的算数。相同RMS指标和R=1参照下,线性、平方ReLU、指数的阈值分别约65、2817、127万。数量级说明读取规则的重要性;它没有把显式候选的保存和计算成本消掉,也不是固定现实模型可以背诵的知识条数。
现在明确换回随机向量实验:key和value都是六十四维,查询恰好等于一个已存key,指数锐度β为八。三条曲线使用同一种RMS比值与R等于一的线。沿交点看,线性是几十条,平方ReLU是千条,指数到了百万量级。变化来自读取分配的选择性,不是把三个不同任务的分数拼在一起。
从AR07的二维β=4切换到dₖ=dᵥ=64、β=8,目的由展示一次计算变为比较随机检索量级。图中线性65、平方2817、指数约127万采用同一球面RMS口径。
当前球面RMS计算约一百二十七万,高斯近似约一百二十万。它们都是这组理想随机检索条件的量级,不是现实模型保证的知识数或上下文长度。候选仍需保存、计算,真实查询也常不等于目标key。这个结论已经足够有意思:读取规则本身能改变可用关联的范围。接下来回到Transformer,问这些K/V究竟从哪里来。
可继续阅读AM16的长上下文锐度调整(LogN、Su、YaRN)和资源限制。本段不在默认路线展开各算法。噪声查询相似度ρ<1会降低相对目标优势。
球面RMS约127万、高斯近似约120万与博客采样统计属于不同口径。幂次、指数、查询噪声和候选存储的完整条件可从关联阅读继续。
条目可随输入增加;在大量候选下,读取选择性还能维持到什么量级?
对高维随机单位key相似度近似N(0,1/d_k),精确查询下相对目标的RMS干扰近似√M·exp(β²/d_k−β)。令其为1得到M≈exp(2β−2β²/d_k);d_k=64,β=8给e^14≈1.20×10^6。独立球面积分RMS复算约1.27×10^6,与高斯近似和作者采样统计不是同一口径。若目标相似度变为ρ,同一高斯估计替换为exp(2βρ−2β²/d_k),可在补充材料演示查询噪声使收益下降。
I04 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
固定锐度仍会积累干扰;只调整读取锐度,能否部分补偿长度增长?
原始Qwen报告中的LogN做法、Su的推导以及YaRN的尺度不同,不能合称所有模型都这样缩放。参考:Qwen、Su原文、YaRN。有限个互异key、精确查询、可任意提高锐度的数学极限,与有限精度、计算预算、训练分布及噪声查询下的实际系统应分开讨论。
M03 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
比较线性、平方、指数在共同RMS阈值下的交点,并区分球面值与高斯近似。
完整推导解释查询相似度降低为何削弱目标优势。
按问题继续读LogN、Su、YaRN及其存储与计算边界;不作为主讲支线。
训练参数与当前状态都能排列成矩阵,但产生方式不同。W₁/W₂、W_K/W_V是普通推理中固定的规则;当前输入X通过这些规则产生本次K/V。增加输入位置会增加K/V的行数,改变内容,却不改变投影参数尺寸。把A12秒、B8秒的新记录加入上下文可以改变本次回答,这本身不构成参数更新或跨请求的永久记忆。
刚才从MLP理解关联记忆时,承担检测和输出方向的是训练后的W一和W二。普通推理里,这些参数保持不变。不同输入会激活不同响应组合,但模型不会仅仅因为读了一条新记录,就自动把它永久刻进参数。先把这一类对象认清:训练留下的是处理输入的规则。
右边的attention也有训练参数:W下标K和W下标V,是生成key和value的投影规则。把当前输入X交给同一规则,才得到本次的K/V。输入中增加位置,K/V增加行,但投影矩阵本身不因此变大。我们要分清规则和这次规则处理出来的内容,不能把它们含糊地都叫权重。
非参数式条目描述的是条目可随输入长度变化,不代表attention没有可训练参数。每层/每头的K/V来自对应表示,不是一token一事实。
现在把这次实验记录放进当前输入:相同设置下,A用十二秒,B用八秒。模型可以利用这些新数字改变回答,而参数完全不必更新。换一份记录,本次K/V和读到的内容会变;下一个请求还能否看到旧记录,要看应用是否重新提供或保留上下文,不能只凭上次读过就说永久学会了。后半课会继续用这份A/B记录检验训练与使用的区别。
KV cache是保留中间计算结果的工程机制,既不是优化器状态,也不等同于参数学习。普通推理、应用保留、参数更新分开。
A12秒/B8秒是本课贯穿记录;本段引入它的身份,后半课只添加新任务和新测量,不重置事实。
读取公式已经连上,接下来区分关联在参数中还是来自当前输入。
此处“非参数式”描述可随输入长度增长的条目,不表示attention没有可训练参数。每层、每头的key/value是该层表示的投影,不是“一条token对应一条独立事实”。KV缓存是保留计算结果的工程机制,本页只埋线索,具体成本由后续服务段展开。
M04 原阅读材料 · N08 原阅读材料 · N09 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
沿X→投影→K/V看行数与内容变化,区分上下文使用、应用保留和参数学习。
后半课以同一AB记录和CD示例检查普通ICL没有优化器更新时的变化。
推理页区分prefill、decode、各层K/V与训练优化器状态。
手工关联例建立了结构怎样承载与读取信息的可能性,不能单独证明真实训练会形成何种能力。attention与MLP都处理当前表示、使用训练参数;它们在完整网络中共同作用。接下来的视觉证据分两步回答新问题:照片怎样成为结构可接收的输入,以及实际训练后的表示能否在独立任务上取得收益。
回到上一讲的Transformer框图,attention与MLP现在多了一层可以计算的含义。前者按当前条目读取,后者可以从训练参数中的关联来理解;它们都在变换表示,协同影响后续结果。我们已经回答了怎样可能承载与读取,却还没有回答真实训练到底学成了什么。能表示、能学到、能在任务上用好,是三个需要分别检查的问题。
线性层梯度更新ΔW=−η(∂L/∂y)xᵀ也是外积形式,但误差信号不是原始事实value;不能把一步更新说成写入一条完整知识。
刚才的小例子由我们亲手安排线索和内容,真实模型要从数据与目标中形成这些表示。现在换成能直接看见对象与结果的视觉任务。眼前是一张校车照片:我们先问它如何接入同类结构,再用实际训练和独立评测看效果怎样。结构提供可能性,成绩检验它是否在这些条件下被用起来。先别急着讨论内部含义,下一步从照片怎样变成输入开始。
校车照片只是将研究问题交给可观察输入;本页不提前切patch或给出分类结果,避免与VR01/VR02重复。
attention与MLP的计算结构可以承担读取与关联,但结构上的可能性还不能证明真实训练已经形成了所需能力。前面的手工例子中,key和value由我们指定;真实模型要从数据和训练目标中形成表示,再用独立任务评测检验。接下来先看图像如何进入模型,以及不同训练条件下的实际表现。
机制分析完成后,回到开场的另一条线:训练实际形成了什么能力?
对线性层y=Wx,一步梯度下降是ΔW=−η(∂L/∂y)xᵀ,形式上也是外积更新。它说明梯度可以怎样改变输入与输出方向的关联;−η∂L/∂y是误差信号,不是原始事实value,不能说每一步梯度把一条完整知识原样存入。整网的非线性、表示变化和优化历史还需另论。
M04 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
增加模型与材料是否改善任务表现,需要真实训练和评测来回答。
X01 原阅读材料。旧阅读材料保留自身的算例与记号;不要将旧三条目行向量例与本节两条目列向量例混算。
对齐承载能力、训练结果和任务使用,说明外积梯度不等于一次写入事实。
沿同一校车照片追踪patch、投影与位置表示,再进入真实任务评价。
完整阅读ViT条件比较与MAE目标、迁移结果,分清结构与投入。
图像无需先翻译成文字才能进入Transformer。照片切成patch,每块像素展平并经过可训练线性投影,再加入与原图位置对应的位置表示。所有patch使用同一投影规则,随后形成encoder接收的向量序列。课堂4×4网格只用于追踪裁片;ViT-B/16中的16是16×16像素patch边长,224×224图片通常有196块。
同一张校车照片,切块、编号,再按顺序排成序列。四乘四的十六块是教学网格,不是实验真实块数,也不是十六个词。沿一个编号,从右侧裁片找回原图位置。
patch意为图像块,encoder意为编码器。4×4是这张图上的教学网格,真实ViT /16为16×16像素patch;两种数字的职责不同。
打开第七块。像素展平为向量,经过可训练线性投影,再加位置表示,就成为模型输入。其他块使用同一投影规则。真实ViT的/16指十六乘十六像素块,二百二十四图像通常有一百九十六块。
真实/16指16×16像素patch;224×224图像通常有196块。此校车照片来自MAE Figure2,用于接口教学,不冒称ViT原实验输入。
全部向量交给encoder,经过attention与MLP,接上分类输出。接口已经接通,训练效果还要看实验:更大的ViT,在同一个分类任务上就一定更好吗?
4×4是教学网格;真正的patch规格与原论文配置分开。照片来源、编号与裁片一一对应。
图像分成 patch,每块像素展平后进行可训练线性投影并加位置表示。画面 4×4、16 个块仅是序列化教学示意。真实 ViT-B/16 的 /16 指 16×16 像素块;224×224 图像对应 14×14=196 块。图像取 MAE Figure 2 校车原图作为连续对象,不冒称为 ViT 论文中的原始示例。
来源:ViT v2,§3.1;校车来自MAE v3,Figure 2。
相关的完整阅读材料保留原有公式、引用和原始图解。
从教学网格到真实patch配置,解释展平、共享投影和位置表示。
含图像序列接口、预训练配置和真实迁移评价,核对/16的含义。
接着读结构比较、图片自监督目标及训练后的分类迁移。
ViT Figure3报告带标签预训练、ImageNet微调后的独立分类评价。纵轴为top-1准确率,横轴为ImageNet、ImageNet-21k、JFT-300M三种预训练数据集。粉色B/16与浅蓝L/16保持相同patch边长;在ImageNet列L/16低于B/16,到JFT列则反转。这个结果要求结合训练条件判断结构潜力。数据数量、组成和计算投入同时变化,不能把三个点读成只改样本数的因果实验。
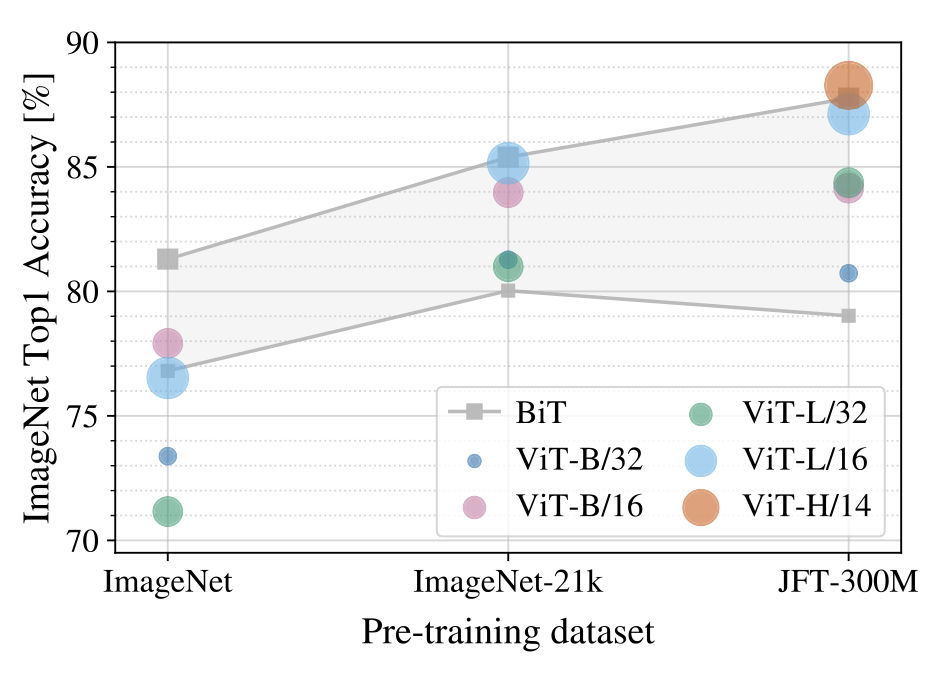
先看一个点的来历:在横轴指定的数据集里,图片和类别目标参与预训练,误差更新模型参数;随后按论文协议到ImageNet做带标签微调,最后用未参与训练的验证图片统计分类top-1正确率。纵轴就是这个百分比,横轴是三个不同预训练数据集。我们固定追踪粉色B/16与浅蓝色L/16,L是更大的配置;16表示相同的patch边长。灰色方点和范围保留为BiT卷积模型参照。
预训练流程中的类别目标来自相应有标签数据集;ImageNet微调继续更新参数,验证阶段统计top-1准确率。课堂校车来自MAE Figure2,仅作输入接口示意,不是此图实验样本。原图未提供供本课逐点复写的精确数表,因此屏幕只比较已确认的相对位置。
只看ImageNet这一列,粉色B/16点高于浅蓝色L/16点:较大的L/16反而较低。两者用同样的patch边长,最终也在同一个ImageNet指标上评价。可见把结构做大,并没有在这套训练条件下自动换来更高正确率。先记住这个排序,保持两种颜色和模型名称不变,再看右列。
在JFT-300M这一列,浅蓝色L/16高于粉色B/16,排序反转。较大的结构在更充分的训练条件下获得更大的相对收益,小条件下的排序因此不能代表它的长期上限。图能直接支持的是这项观察;数据数量、数据组成和训练投入都改变了,仅凭这三个点不能分别算出每个因素的因果贡献。
把两列放在一起,结论是结构与训练条件要共同选择。这里的预训练仍使用类别标签,“预训练”说的是先后阶段,并不等于无标签。三个数据集的数量与组成同时变化,总计算也没有配平;图也没有证明卷积不能扩展。于是自然出现下一问:如果不再额外给每张图片标类别,图片本身还能怎样提供训练目标?
ViT Figure4的同源JFT子集、冻结表示5-shot评价及ConvNeXt反证在相关完整材料。视觉5-shot不是语言提示ICL。
采用ViT v2 Figure3原图,保留数据集、模型身份、BiT范围与下游评价流程;不将不同数据集比较变成纯数据量因果实验。
ViT Figure 3 的横轴是 ImageNet、ImageNet-21k、JFT-300M 三个预训练数据集,数量与组成同时变化;纵轴为目标 ImageNet 的 top-1 分类准确率。这里先做带标签预训练,再带着参数到 ImageNet 进行带标签微调与验证集评测。因此“预训练”是学习流程位置,不必然指无标签训练。/16 表示 16×16 像素的 patch。灰色区间来自不同规模 BiT,不是单一小模型。
来源:ViT v2,物理 p.7 Figure 3、§4.3、p.15 Table 5。
相关的完整阅读材料保留原有公式、引用和原始图解。
左列比较同一 ImageNet 预训练数据集、同为 /16 patch、同一目标评测下的 B/16 与 L/16。L/16 更大,但该条件中准确率更低。图像局部先验可帮助解释为何卷积在较小训练条件下有效,但这张图不单独识别所有原因,也没有匹配每个模型的参数量与总计算。
来源:ViT v2,Figure 3 左列。
相关的完整阅读材料保留原有公式、引用和原始图解。
JFT-300M 列中 L/16 高于 B/16,修正了仅凭左列得出的扩展判断。该图换了数据集数量和组成,训练计算也不完全相等,因此不把全部增益归为纯样本数。
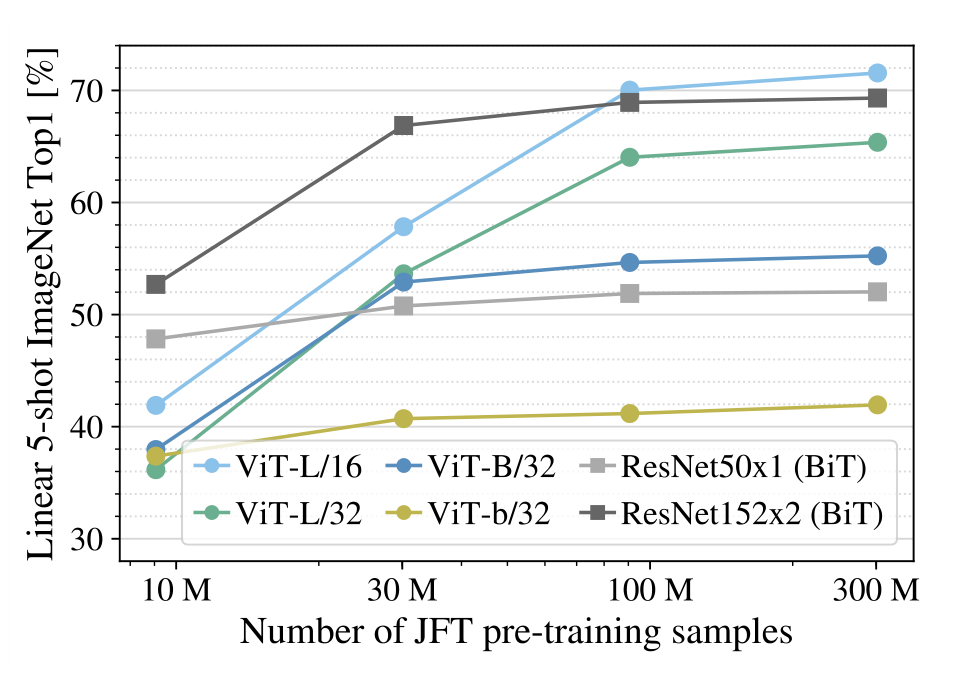
Figure 4 在同源 JFT 子集上补充研究规模变化,其 5-shot 指冻结表征后拟合线性分类器,并非语言模型的提示 ICL。
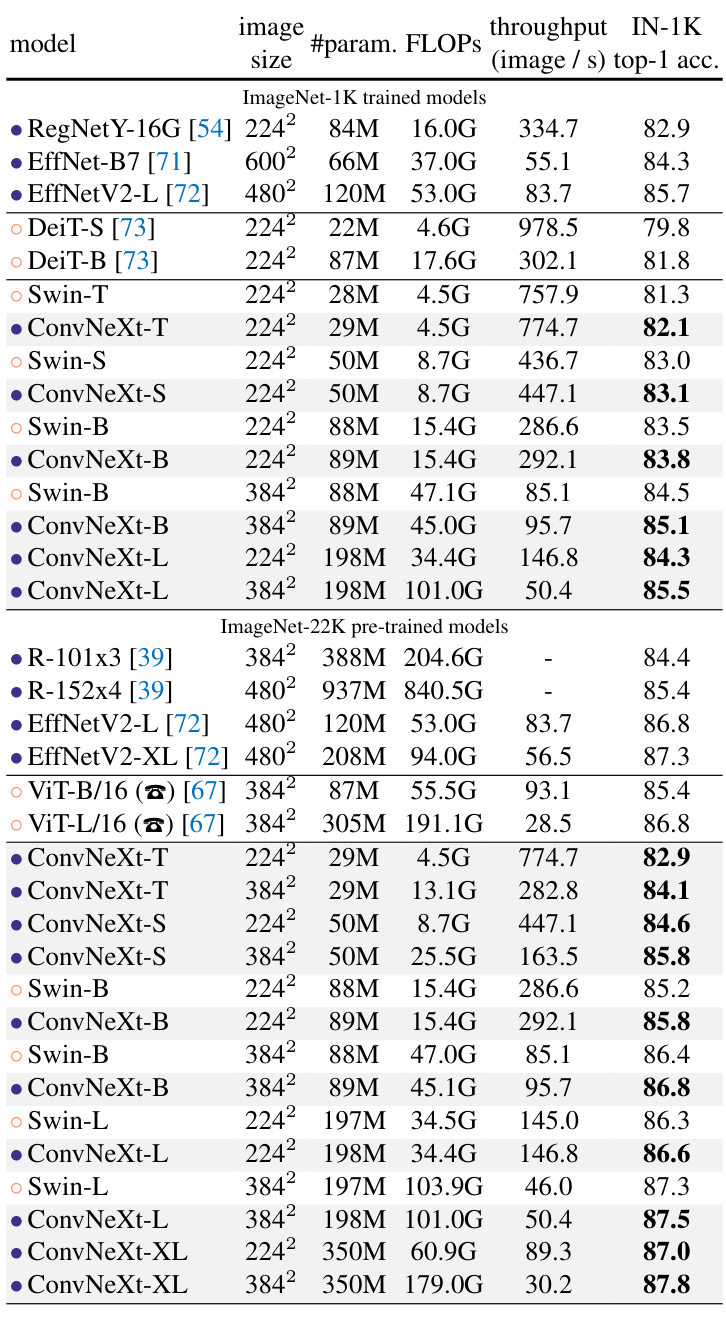
现代卷积同样可以从结构与训练配方获益;本段不主张卷积不能扩展。原图完整条件见视觉扩展正文。
来源:ViT v2,Figure 3/4;ConvNeXt,Table 1。
相关的完整阅读材料保留原有公式、引用和原始图解。
原Figure3与训练/微调/评价协议并读,保留B/16、L/16和BiT身份。
Figure4固定数据来源比较规模,说明冻结表示拟合与语言ICL不同。
核对Figure3/4/5、模型配置与训练条件。
MAE重建示例由同一原始校车图产生输入和目标:模型收到39/196个可见patch,根据它们预测被遮位置的像素。预测保留黄色车身、两层轮廓和窗户大致位置,但车窗边界和车头文字与原图有差异。目标像素来自遮挡前的原图,可以给误差定量计分。这个示例约80%遮挡,与常用75%训练设置分开;重建相似不等于下游分类已经有效。
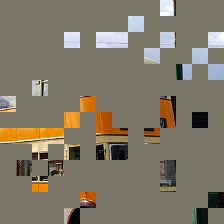
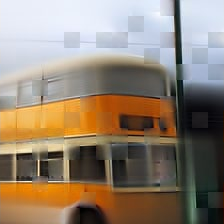
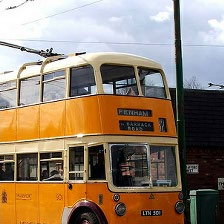
由完整图片构造任务:根据可见部分,预测被遮像素
此图约80%遮挡;方法常用75%。比较的是被遮位置的预测与目标。
我们见过完整校车照片,但模型这一轮只收到左边的零散块:一百九十六块中可见三十九块,约百分之八十被遮住。任务是根据可见部分,预测被遮像素。先有全图、再做遮挡,输入与目标就都能从材料本身产生;观众看到的全图不等于模型输入。
此Figure2示例约80%遮挡;MAE常见方法配置为75%,两者分开。这里mask是造训练题,不是因果attention mask。
先看真实预测;下一步再用同位置目标检查
此图约80%遮挡;方法常用75%。比较的是被遮位置的预测与目标。
中间出现论文报告的重建。可以认出黄色车身、上下两层和窗户的大致位置,但窗框边界和车头文字还不清楚。现在看到的是预测结果,还不能只凭轮廓相似就说它每处都补对。下一步揭开原图,在相同位置检查哪些结构恢复了、哪些细节仍错了。
此图来自MAE v3 Figure2的原始预测,未把可见原图块覆盖回重建图。该制作与来源事实用于解释预测身份,不作为主讲结论。示例39/196可见块约80%遮挡;常用方法训练设置75%须另分。
车窗、文字与边缘的差异 → 明确的像素误差
此图约80%遮挡;方法常用75%。比较的是被遮位置的预测与目标。
原图里车窗框和车头文字更清晰;预测保留了车身的大结构,却没有恢复这些具体像素。两图中的同一位置因此给出可计算的误差。原图在遮挡之前已经存在,训练能从被遮位置的真实像素获得目标,不需要另请人逐张写答案。重建是否准确与表示能否用于分类仍是两个问题;下一页先沿这项误差看参数怎样更新,再看留下的表示怎样转用。
像素重建loss只计被遮位置,常用patch像素归一化。重建像不像与表示能否迁移分类需分别评价。
三图均来自MAE v3 Figure2校车行,固定身份与尺寸。真实重建不作美化;输入限制、预测、目标与后续独立评价分开。
本页左图是 MAE v3 Figure 2 校车行的真实遮挡输入,196 个 patch 中可见 39 个,约 80% 被遮住。观众之前见过全图,不代表模型该轮得到全图。遮挡人为构造了输入限制,原始图片同时提供预测目标;这里的 mask 是构造重建训练题,不是因果 attention mask。
来源:MAE v3,物理 p.2 Figure 2 校车行。
相关的完整阅读材料保留原有公式、引用和原始图解。
三张图片固定为论文遮挡输入、论文重建、原始图像。重建图保留原始误差,不贴回可见区域,也不进行生成式美化。训练时只对被遮位置计算像素重建损失;原论文还讨论 patch 像素归一化等实现条件。重建是否像原图与预训练表征是否能迁移分类,是需要分别评价的两个问题。
来源:MAE v3,Figure 2 与 §3。
相关的完整阅读材料保留原有公式、引用和原始图解。
同一校车三联图保留真实误差,解释39/196可见块和像素目标。
完整路径连接encoder、decoder、被遮位置loss、分类头和标签微调。
核对Figure2重建展示、方法遮挡设置和Table3下游评价。
MAE预训练时,encoder处理可见patch,decoder结合其表示与mask占位预测像素;被遮位置的预测与原图目标形成loss,经反向传播更新参数。分类迁移保留encoder、移除重建decoder、接上分类头。完整图像全部patch进入模型,类别标签提供新的微调目标,之后由独立验证图片评价。可迁移的是训练后的参数与表示,并非那一张重建图或凭空出现的类别知识。
打开补图路径:大encoder只处理可见块,形成表示;表示与被遮位置的mask占位一起进入小decoder,产生像素预测。占位不是被遮的真实像素。原图走另一条目标支路,用来检查预测。
MAE此处的encoder/decoder表示重建职责,不是翻译模型自回归逐词输出的同义替代。encoder只处理可见patch,decoder接表示与mask占位;目标支路独立提供原图像素。
对齐同一被遮位置的预测与目标,差异形成重建loss,再通过反向传播更新encoder和decoder参数。样本、目标、损失、更新现在连起来了。自监督指材料自身提供目标,并非没有监督信号;请看更新箭头确实回到了参数。
方法结构示意采用常见75%遮挡,与前页真实展示约80%分开。MAE decoder预测像素,不是翻译逐词生成的decoder。
转到分类时,保留的是重建训练过的encoder参数,重建decoder被移除。完整图像的全部patch经过encoder,输出表示交给新接的分类头。类别答案从哪里来?来自目标任务的带标签训练图片;分类预测与类别目标形成损失,微调分类头和encoder。完成后再用独立验证图片统计准确率。于是补图不是直接变成分类答案,而是先提供有用的表示起点,再由新任务的监督把它用于分类。
MAE预训练的大encoder处理可见子集,小decoder结合mask token重建;下游保留encoder,输入全图,去除重建decoder,再微调和评测。两条路径在相同encoder处接续。
MAE 的大 encoder 仅处理可见图像块。编码表示与 mask token 一起交给较小的重建 decoder,生成像素预测。下游分类保留 encoder,去掉重建 decoder,输入完整图像的全部 patch,添加分类头,进行带标签微调与独立评测。本结构图采用方法常见的 75% 遮挡说明,不将上页示例的 80% 混进方法配置。重建 decoder 与上一讲翻译 decoder 的接口不同。
来源:MAE v3,物理 p.1 Figure 1 与 §3。
相关的完整阅读材料保留原有公式、引用和原始图解。
可见patch进入模型,原图提供目标;loss更新参数,目标不偷渡进输入。
移除decoder、接分类头、带标签微调后,用独立验证集比较收益。
核对encoder/decoder职责、mask token、被遮位置损失和迁移配置。
MAE Table3在ImageNet-1K、224×224评价中比较两条路线。B/16、L/16、H/14从头监督训练为82.3、82.6、83.1;MAE预训练后微调为83.6、85.9、86.9。相同L/16提升3.3个百分点,说明该路线有分类迁移收益。两路共享训练图片池,却非等计算:MAE还使用1600轮预训练。H/14的patch规格与B/L不同,448分辨率结果也不混入本图。
先分开两个对象:ImageNet一K训练图片池用于学习,独立验证集用于评价。纵轴是二百二十四分辨率下的分类准确率。灰线来自论文自己的从头监督训练。重点追L/16的八十二点六,B与H留作趋势参照。
top-1是模型排名第一的类别与真实标签相同的比例。灰线、蓝线都由独立ImageNet验证图片评价;用于学习的训练图片池与验证集角色不同。
加入蓝线:先做MAE预训练,再分类微调。同一个L/16从八十二点六到八十五点九,提升三点三个百分点。B和H也显示在图里。这把“学到的表示是否有用”交给另一项明确任务,不再仅凭重建照片作判断。
B/L/H从头82.3/82.6/83.1;MAE后83.6/85.9/86.9;差值1.3/3.3/3.8pp。H/14 patch规格不同;不混入448分辨率87.8。
蓝线还多做一千六百轮重建预训练。同一图片池不等于同样计算,因此这是任务方式与投入共同改变了结果。我们已经看到可迁移收益,但分数仍没说明内部正在区分什么;这个问题需要换一种观察办法。
按MAE v3 Table3重绘,保留原表核对入口。训练图片池与验证集分开,224评测与448结果分开,同文对照与等计算实验分开。
指标是独立 ImageNet 验证集上的分类 top-1,输入分辨率统一为 224×224。两条训练路线共享 ImageNet-1K 训练图片池,但验证集与训练图片池分开。论文 Table 3 的从头监督训练基线为 B/16 82.3、L/16 82.6、H/14 83.1;B/L/H 代表不同模型规模,H 的 patch 尺寸也为 /14,不能把跨规模图读成严格只改一个参数的实验。
来源:MAE v3,物理 p.7 Table 3 / Figure 8。
相关的完整阅读材料保留原有公式、引用和原始图解。
MAE 后微调成绩为 83.6、85.9、86.9,与从头监督训练逐模型差值为 1.3、3.3、3.8 个百分点。MAE 额外预训练 1600 epoch;共同使用训练图片池不等于等计算。ViT-H/448 的 87.8 使用不同分辨率,不混入本图 224 比较。
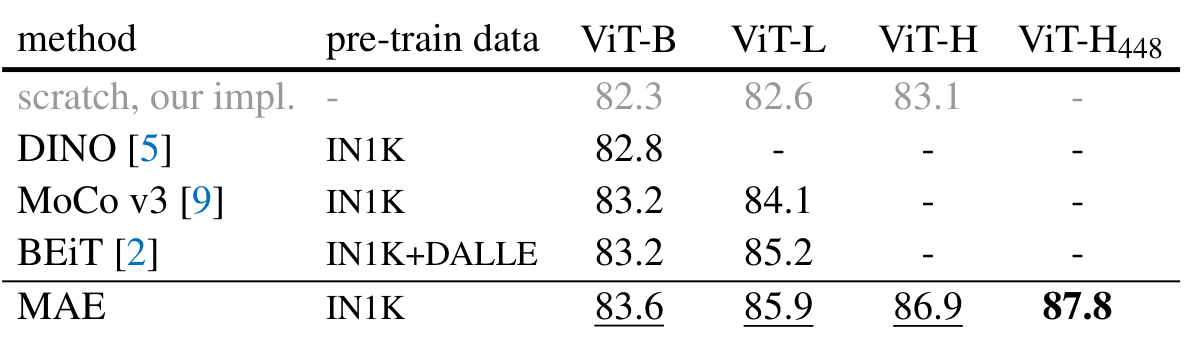
原表保留供核对配置;主屏曲线按 Table 3 重绘,不是新实验。
来源:MAE v3,Table 3;本课按原表重绘。
相关的完整阅读材料保留原有公式、引用和原始图解。
完整B/L/H表、百分点差值及1600轮条件就地可核,避免混入448分辨率结果。
查看原表及相关分类微调协议,区别同图片池与等计算比较。
解释为什么下一段更换模型,进一步看同一单元的自然响应。
分类成绩回答表示是否有用,内部响应研究回答这些表示在区分什么。接下来的猫与汽车自然图来自InceptionV1同一单元的高响应例,研究对象已经更换;它不是前述MAE checkpoint的内部审计。保留同一单元与不同输入,才能进一步检查这些物体是否有共同结构,以及这种解释是否经得住新证据。
分类分数说明表示有用,却没解释内部形成了哪些区分。下面换一组能深入观察的网络,从内部响应寻找解释;这不是对刚才那台MAE checkpoint的审计。
这里换到InceptionV1。同一个单元的高响应自然例里,为什么同时有猫和汽车?先留住这个困惑,下一段沿照片里的结构寻找解释。
分类分数告诉我们训练后的表示能否转用于任务,却不能直接说明网络内部的单元在区分什么。要继续追问,需要观察具体输入引起的内部响应。接下来的猫与汽车例子换用InceptionV1:这是另一个模型上的机制证据,不是对刚才MAE模型的内部审计。
N19 的 85.9% 是 MAE 预训练后 ViT-L 在给定分类微调设置下的 top-1 准确率;与同模型从头监督训练的 82.6% 相差 3.3 个百分点。额外 1600 epoch 预训练仍计入比较条件。这一结果支持容量能够被训练利用,不直接说明哪一个中间单元在做什么。
本段使用 Goodfire 文章中的 InceptionV1、作者自训的 ConvNeXt,以及文中语言模型案例。这里不是对前一页 MAE 的逐层机制验证。我们沿作者的观察和修正过程学习四类证据:自然输入上的响应、可视化工具产生的图、连接与干预,以及新的检验例。作者将其整体主张表述为工作假说;局部观察与全网判断分开。
来源:Nick Cammarata(2026),Goodfire,Neural Networks Are Already Clean。 图与原始照片保留原作者权利;本课按原图选择固定状态、重排并加中文标注,未重跑原文模型实验。
从两张自然照片进入同一InceptionV1单元,随后看局部结构和相反响应。
按自然例、训练轨迹、归因、干预和新例检验组织证据,保留模型切换。
原图、案例与作者论证,是后续局部机制材料的共同来源。
MAE 的分类成绩说明表示对任务有用;要理解内部形成了什么,需要观察具体单元。这里换到 InceptionV1。作者选出的猫和汽车照片都会强烈激活同一个单元,它们的日常类别却不同。先保留“兼做两份工作”的猜想,再检查照片里的共同结构。
按我们的日常分类,左边的猫和右边的汽车差得很远。现在有一个神经元,两种图都会让它强烈响应。一个自然猜想是,它兼做了两件不相干的工作。我们先保留这个猜想,再检查有没有遗漏的共同结构。注意,这里看到的是作者选取的自然照片,还不是对全部响应分布的结论。
自然照片只展示输入内容,图中没有响应热图或逐像素色标。这里的“强响应”依据原文选例,不是把猫/车类别直接写成单元功能;本态只提出两种待检验读法。
Goodfire · Cammarata 2026 · #v-figure
补上定位:InceptionV1 的 4e 层,第五十五号单元。这里确实是同一个单元,不是分别挑了一个猫单元和一个车单元。编号帮助我们追踪对象,本身不是语义标签。接下来模型和照片都不换,只改变观察尺度,看看它响应的局部在哪里。
4e:55表示网络中的层与单元坐标。两种照片都来自同一坐标的响应选例,因此“两个单元各自分类”不能解释当前观察;下一页保持照片身份,改变局部观察尺度。
Goodfire · Cammarata 2026 · #v-figure
这里展示作者选取的自然照片:猫来自 p47742,汽车来自 pCarX5。二者均是原文 InceptionV1 单元 4e:55 的正响应例子。照片不是本课生成的,也不是激活热图。层名 4e 与单元编号 55 用于定位研究对象,编号不代表语义标签。
作者曾参与的旧解释把它看成猫与车的多义混合;重新观察后修正了这个判断。本页先保留旧困惑,是为了让下一页的局部结构真正改变解释,而不是先给答案再找图片。这里没有把两张选例当作全部响应分布。
来源:Nick Cammarata(2026),Goodfire,Neural Networks Are Already Clean。 原图/段落 v-figure。 图与原始照片保留原作者权利;本课按原图选择固定状态、重排并加中文标注,未重跑原文模型实验。
保留两张自然照片及4e:55定位,解释为什么物体类别差异只提出疑问,不能直接确定内部机制。
沿原圆框与真实局部放大比较猫脸、车头,再看台球桌和新干线怎样约束形状解释。
原文Cars and Animals与交互原图,供核对自然例、区域定位和作者解释变化。
猫和汽车的整体类别不同,但同一单元的响应可能来自较小的局部结构。先在原自然照片上定位,再放大同一片区域,最后加入台球桌和新干线,检验“尖形/V形”候选解释能否跨过类别。
还是刚才的猫与汽车。看这两个圈落在哪里:猫脸的中间和汽车前脸的相应部位。圆框来自原图的响应局部定位,不是一幅逐像素热图。先把整张照片的类别名放到一旁;下一步只放大圈里的同一部分。
圆框由原图交互的区域坐标确定。比较时应先找到圈内实际对象,保留整图作为定位;圆框范围不表示激活的精确支撑区域。
Goodfire · Cammarata 2026 · #v-figure
现在把同一局部放大,两边都有向下收尖的结构。于是有了另一个解释:这个单元可能在区分尖与圆。它能把两个物体名连接起来,但现在还只解释了两张图。我们把它作为候选,让它接着面对新的对象。
两处局部都有向下收尖的轮廓,这是候选描述的共同依据。V形不是脱离自然输入的数学判别式,也没有由两张照片证明充分或必要条件。
Goodfire · Cammarata 2026 · #v-figure
物体换成台球桌和新干线,尖形结构仍然出现。下方的小图让我们保留局部来自哪里的定位。现在检查的是跨类别的共同模式,而不只是给猫与车换一个更宽泛的名称。接着反过来问:什么会把同一个单元推向另一侧?
台球桌和新干线补充跨类别的自然例,使“猫或车”这个类别并集不再是最简描述。图下整图缩略保留局部来路;要进一步缩小解释空间,还需相反侧与连接证据。
Goodfire · Cammarata 2026 · #v-figure
本页全图中的圆框、下一态的局部放大均按照原图交互给定的位置和三倍放大参数。圆框是原图的响应区域定位,不是本课算出的热图;颜色也不是激活值色标。原图未在此提供逐像素热图,不凭空绘制一幅。
猫与汽车局部都支持“尖形/V 形”的候选读法,但只有两张图还不够。作者给出的台球桌与新干线例子跨越了动物/车辆的常用类别,扩大了候选解释要覆盖的范围。泛化可能沿几何结构发生,而不是按人的名词表发生。新的自然例仍是作者选取的检验例,本课没有独立进行盲测。
来源:Nick Cammarata(2026),Goodfire,Neural Networks Are Already Clean。 原图/段落 v-figure。 图与原始照片保留原作者权利;本课按原图选择固定状态、重排并加中文标注,未重跑原文模型实验。
解释原图局部坐标、三倍放大与照片身份;圆框是定位,不是逐像素激活热图。
用自然正负侧、上游构成和下游用途继续检验V形候选,而不止给四张照片找一个名称。
保留同一checkpoint的优化图与自然响应对照,区分模型变化与观察工具变化。
一个候选解释如果只覆盖几个正例,仍然容易过宽。这里增加两类约束:同一单元的相反响应是否呈现相反结构;上下游连接是否与这个区分的形成和使用相符。自然例与优化图各自承担不同证据职责。
上排是刚看到的尖形正侧,下排是原文记录的相反侧:圆脸、蜗牛壳、球与钟。它们不共享一个物体名,却有较圆的结构,连狗也能出现在相反一侧。这给“尖与圆的区分”增加了一条约束。这里的正负是原文所研究信号的方向,不是正确与错误,也不是说 ReLU 输出了负数。
正负侧是原文所研究响应信号的两端;本页不把负侧当作分类错误,也不声称ReLU后输出为负。尖与圆比物体名称更能同时概括两排选例。
Goodfire · Cammarata 2026 · #v-figure
沿左边看,尖嘴、尖耳脸和车辆前部这些路线汇向同一个 4e:55。每组的自然例与优化图并排放着:前者是输入上的实际响应例,后者是帮助观察的可视化。共享区分不只在两张照片上说得通,它与上游构成也能对上。线宽只在各侧按原文口径读取。
上游三组分别显示自然例与优化图:自然例是输入上的响应,优化图受目标和先验影响。线宽在输入侧由原图drive比例决定,不能和下一态读出侧去除后的下降量直接比较。
Goodfire · Cammarata 2026 · #v-figure
再向右走,火焰、尖脸、长嘴与 V 形杯等路线会使用这个区分。连接表明这个区分会被后续计算使用。现在,同一个解释要同时接住自然例、相反响应和上下游关系。我们因而有理由认真对待它,也清楚它目前解释的是这个单元和这些选定连接。有些共同点能从成品看出来;另一些单元到了终点已经响应好几类对象。它们怎样走到一起?这一次看真实保存下来的训练过程。
读出侧呈现4e:55如何被若干下游路线使用。图中只保留原文精选连接,连接与自然例相符支持共享解释,但没有穷尽所有路径。下一页更换训练对象,追踪的是发展过程。
Goodfire · Cammarata 2026 · #v-figure
原文同时展示 4e:55 的正、负侧。正侧的尖形与负侧的圆形是相对同一单元、原文所测响应量的两端,不是在宣称 ReLU 后输出为负。本课遵从原文“pushes it negative”的说法;理解时必须区分非线性前信号与经过整流后的输出。
上游节点为 4d:493(尖嘴)、4d:477(尖耳脸)、4d:201(车辆前部);下游为 5a:94(火焰、消防船水柱与狐脸)、5a:352(尖脸)、5a:317(长嘴与 V 形杯)。本课保留这些节点与方向,线宽在每一侧按原图元数据相对缩放。输入侧 data-w 为 0.321/0.031/0.029;读出侧为 38.3/34.1/22.1,原图提示分别是 drive 比例与去掉 4e:55 后下降量,口径不同,不跨两侧比较粗细,也不当作完整网络全部边。
优化图负责提出候选,自然例说明其实际响应,上下游关系检查这个区分如何被构建与使用。几类证据相互制约,是支持作者解释的理由;不是仅凭箭头存在就宣称全网机制已经证明。同一原图的自然照片、局部定位与精选连接按问题顺序展开,完整证据与原图来源仍可继续核对。
来源:Nick Cammarata(2026),Goodfire,Neural Networks Are Already Clean。 原图/段落 v-figure。 图与原始照片保留原作者权利;本课按原图选择固定状态、重排并加中文标注,未重跑原文模型实验。
按4e:55的正负侧、三条上游和三条下游读真实对象;解释为什么两侧线宽不能跨侧比较。
从自由优化图转到自然路线引导优化与自然响应比例,解释旧读法为何需要修正。
用门控与读出例区分内部信号的符号和对答案的促进或抑制,避免把负侧理解成“不喜欢”。
修道院实例保留自然图、上游结构和晚层路线,可练习沿真实节点读连接。
只看训练终点,很难知道几个响应类别怎样走到一起。真实 checkpoint 保留了同一坐标在训练中途的状态。本页按两行固定单元、三列时刻并排保留证据,观察田野相关响应如何延伸,以及两次训练的后期差异。
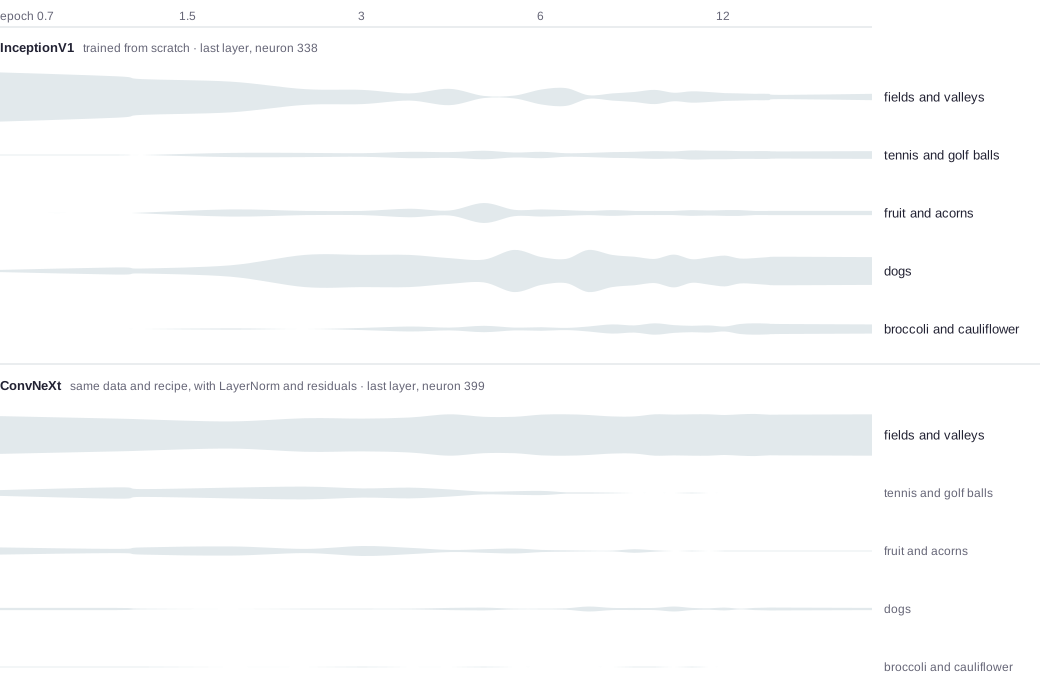
这里换成两次真实训练中保存的单元:上行是重新训练的InceptionV1末层338号,下行是ConvNeXt末层399号。每一行一直追踪同一个坐标,列是训练时刻。先看零点七epoch:强响应自然例多是油菜花田,其中也有狗。后面会保留这一列,检查它们如何从这个起点发展,而不凭终点名单倒推。
epoch表示训练遍历数据的进度。上、下行来自两次训练中的不同单元,不能把两行当成同一模型切换结构。时间列一旦出现便保留,下一态可以横向对照;照片数量不表示响应份额。
Goodfire · Cammarata 2026 · #neuron-overflow, #recursive-generalization, #conjoined-features
一点五epoch这一列加入后,零点七那列仍在。横着看同一行,球、果实和狗的响应例开始出现。它们可能通过颜色、环境和局部形状与先前场景相连。图中记录的是这些照片在该时刻的强响应;哪些因素真正驱动变化,还要进一步控制比较。先把观察到的变化和候选解释分开。
一点五epoch列与早期列同时可见。观察是相邻时间的强响应照片出现球、果实和狗;颜色、环境、局部形状是候选连接,而不是已经分别隔离的因果因素。
Goodfire · Cammarata 2026 · #neuron-overflow, #recursive-generalization, #conjoined-features
现在三列并排。InceptionV1从田野相关例延伸到球、狗和蔬菜,ConvNeXt这一行的后期例仍更多围绕田野。请用同一行的前后照片作比较,而不要按格子数量推响应占比。作者把相邻关系不断长出分枝称为递归泛化;这两条真实轨迹给发展解释加了约束。接着回问:它与前面“能读回多少关联”究竟是同一个问题吗?
末态三列同时显示,InceptionV1末期的场景、球、狗和蔬菜可与早期田野直接对照;ConvNeXt一行仍主要展示田野与其中的狗。完整五时刻原图的灰带才表示各组最强响应例份额,本舞台的均匀照片格不编码份额。
Goodfire · Cammarata 2026 · #neuron-overflow, #recursive-generalization, #conjoined-features
原图对象为从头训练的 InceptionV1末层单元338、使用相同数据和训练配方并含LayerNorm与残差的ConvNeXt末层单元399。原图包含epoch0.7、1.5、3、6、12;本页课堂先读0.7、1.5、12三个固定状态,完整中间轨迹与图例见下方本地原图。每行图组背后的灰带表示该组占神经元最强响应例的份额;主屏只选真实照片定位观察,不重画没有复算的比例曲线。
InceptionV1最初主要响应油菜花田与山谷,花田里也有狗;随后到球、果实、狗,后来延伸到西兰花。ConvNeXt也短暂触及球和水果,但随后保留田野主线,分枝较少。这是两个实际记录的案例,不是所有单元必然遵循的定律。
补充材料中的iy→diy→do it yourself是原文概念插图的中文重排;这里不声称拥有语言模型的训练checkpoint。文章 Watching Neurons Develop 描述沿重训InceptionV1追踪坐标,作者也记录曾因缩放不当误以为出现任意混合。附录 Relation to Conjoined Features 承认2021年Multimodal Neurons已有从共享侧面向多方向泛化的线索;新命名突出多层分枝与发展过程。本文尚未完成整模型的严格发展审计。
来源:Nick Cammarata(2026),Goodfire,Neural Networks Are Already Clean。 原图/段落 neuron-overflow。 原图/段落 recursive-generalization。 原图/段落 conjoined-features。 图与原始照片保留原作者权利;本课按原图选择固定状态、重排并加中文标注,未重跑原文模型实验。
重训 InceptionV1 suffix 的图让同一坐标按 checkpoint 并排显示,优化图下方配最强响应处的自然裁剪。它能区分一个成品单元里的邻近反应是怎样逐步出现的;但观察尺度错误仍可能把轨迹看成任意混合。作者临近发布时再次误调显微镜的经历,是提醒我们保留自然例、位置与工具设置,而不是为了一个发展故事挑几张顺眼的图。
原文 Watching Neurons Develop · 完整训练显微镜 · GF09
Multimodal Neurons 已描述从共同侧面向多个方向泛化的 conjoined features。本文承认这一先行观察,并选择“递归泛化”强调分枝还能再分枝、过程发生于生长而不是两个静态概念被接起来。早期只有成品,曾猜是训练早期的残留;后来的视觉轨迹显示分枝还会继续生长。名称变化本身不是新证据,应把发展记录和概念解释分别保留。
原文 Relation to Conjoined Features · GF09
一个有约束的递归泛化解释应预测语义空间中的局部来路、分枝方向及训练次序,而不是见到任何两个响应都补一个共同祖先。本文承认没有严谨证明所有重度多义例都如此,也没有大语言模型所需的完整 checkpoint。成品上的路径一致性可以增加信心,但要确证发展因果仍需要时序数据。保留这一限制,才能避免把“任意打包的空隙解释”换成另一个无所不包的故事。
原文 Is Recursive Generalization Hard to Vary? · GF09 · GF24
语言分枝的概念示意:iy → diy → do it yourself;这张图不是语言模型训练的checkpoint。
完整原图包含0.7、1.5、3、6、12 epoch及灰带;照片用于识别内容,灰带才表达组内份额。
iy、diy与do it yourself展示可相连的局部关系;这里没有语言训练录像,不能与视觉checkpoint混同。
区分罕见输入的既有响应、错误标签训练造成的变化以及优化构造输入,避免把它们都叫异常。
原作者提供的训练过程浏览器,可进一步查看不同层与单元的实际发展轨迹。
联想记忆问的是在指定规则和误差标准下能读回多少关联;Goodfire 的案例问的是训练后哪些响应共享一个机制、为什么共享。两个问题相关,但既不能用容量计算解释具体组织,也不能用几个机制案例推翻前面的条件化推导。
前面问的是,给定写入和读取方式,能可靠读回多少条关联。这里追的是,训练后的某些响应为什么聚在同一个机制里。即使一个结构能承载很多内容,也还要研究它实际怎样组织这些内容。Goodfire 对一类共享解释提出质疑,不会自动推翻前面的条件化容量推导。现在把观察方法带到一句话,沿其中的关系追到模型准备写出的下一个词。
左侧承接随机K/V装置中的明确规则和读取标准,右侧承接4e:55与真实训练例。本文较窄的“任意打包不相关计算”组织假说,不等于所有特征多于维度、组合或向量叠加命题;对词义的完整对齐可在正文核对。
Goodfire · Cammarata 2026 · #packing-vs-growing, #superposition-of-the-gaps, #features-and-definitions
本文重点质疑的superposition是一个组织假说:不相关的计算因为很少干扰,任意共用神经元容量。它不同于“可描述的特征多于维度”,也不同于向量相加、多个神经元共同完成任务或普通组合式表示。前一节联想记忆的条件化容量推导没有因此被推翻。
原图packing-vs-growing用32个图形作概念对照:相近颜色与形状代表相近对象;减少神经元时,一边按相似性形成较粗组,另一边把不相干项打包。本课只重画这个对照的精选组,标明示意,不伪装模型测量。共享带来的干扰成本和复用收益可以并存;仅有特征数与维数的比较不能回答为何这些具体计算共用同一个单元。
正文Superposition of the Gaps保留三个观察盲点。其一,某单元看似同时响应pr、Base64网址与孟加拉文字,解码/转写后仍与pr相关。其二,某Qwen单元看似响应逗号,完整上下文显示它跟踪Colorado,逗号是上下文摘要位置;作者还通过steering观察到徒步相关生成。其三,只给两段文本会让长上下文机制显得没有主题,完整前文可能改变解释。这些是作者研究案例,不是本课实验;也不意味着任何未解释例都必有漂亮答案。
附录 A Note on Superposition 与 A Note on Features and Definitions 区分计数命题、组织命题与词义变迁。作者认可Toy Models在其预设特征和重建目标下的实验,争论真实网络中共享的复用收益是否被这些设定覆盖。不能把本文写成Toy Models实验已被证伪。尚不能解释的响应应当保留为未知;工具、数据覆盖和发展关系都是可进一步检验的候选原因。
来源:Nick Cammarata(2026),Goodfire,Neural Networks Are Already Clean。 原图/段落 packing-vs-growing。 原图/段落 superposition-of-the-gaps。 原图/段落 features-and-definitions。 图与原始照片保留原作者权利;本课按原图选择固定状态、重排并加中文标注,未重跑原文模型实验。
同一个词曾指向向量叠加、特征数超过维数、分布式组合,以及因很少相撞而把无关计算放在一起。本文重点质疑最后一种作为真实网络难解释性的默认原因,尤其是它对神经元如何生长的解释。特征数量超过维数也可以来自有用组合;残差流没有特权坐标基,也不能单独证明任意打包。评价本文必须先固定所谈命题,而不是把它当作否定所有同名理论。
原文 A Note on “Superposition” · GF10
人类关心的一种概念、网络自己的可复用计算构件、SAE 中一个字典方向,都可能被叫作 feature,却不是同一个对象。给猫、车、V 各计一个特征还是只计 V,会改变“特征数”,不一定改变网络。本文因此优先追问什么被什么读取、为什么响应会同处一处。字典仍可作为有用视图;只有确实存在妨碍理解的原生组织问题时,才需要论证替换机制的成本值得承担。
原文 A Note on Features and Definitions · GF10 · GF28
三个命题的完整对齐与pr/编码/转写案例、Colorado与长上下文观察盲点。
把特征数与维度、可复用组合及任意打包不相关计算分开,明确本文主要质疑的组织解释。
瓶颈重训、任务成绩及曲线恢复构成一个可核对实验,帮助区别可表达、学到和可读。
比较字典视图和网络原有组件,说明重构误差、活动事件与解释对象为何不同。
在 Qwen3-32B 的一个保存案例中,输入用“Pride Lands 中后来成为国王的幼狮的死敌”暗指 Scar。归因图追踪指定下一词位置;随后比较未删除、删除作品与狮子背景两组,以及同层同数量随机删除,检验这两组是否实际影响预测。
这次换成 Qwen3-32B。图书馆失窃,卡片只说:Pride Lands 中后来成为国王的幼狮的死敌。这里的幼狮是辛巴,他的死敌是刀疤 Scar;这不是电影知识测试,我们把人物关系先交代清楚。输入没有直接写 Scar。模型已经写到画面中的回答前缀,即将接出名字,我们追的就是这个指定位置怎样形成答案。
舞台保留原文关键留言、提问和实际回答前缀。中文人物关系是为理解任务而补的背景,不是原输入额外出现了Simba或Scar。后续测量始终对应这次输入与Scar下一token。
Goodfire · preeclampsia-circuit · 原文实验/图数据;据原图重排
从底部 Pride Lands 线索往上,先进入作品与狮子背景的两个组,再与反派、死敌等信息共同走向答案。请沿图实际走一遍。方框数字是神经元数,线宽表示这张归因图里的贡献;蓝边是相反方向的贡献。内部数值取正还是负,与最后促进还是抑制答案,还要结合读出关系。作者把复杂活动分组后展示,我们沿真实节点读,不替图添一条更顺口的路线。现在特别留意作品与狮子背景这两组,合起来十八个单元。
原图JSON中lk组为The Lion King、7个神经元,lions组为Lions, savanna、11个。金框与同源放大只定位这两组,不增添Simba节点。线宽为分组贡献,蓝边为相反方向贡献,不能用单元激活符号直接代替对答案的净贡献。
Goodfire · preeclampsia-circuit · 原文实验/图数据;据原图重排
现在在原图同一位置标出要删除的两组:The Lion King七个,Lions与savanna十一个,共十八个。未删除时,当前下一词Scar的概率约零点九一;指定删除后降到约零点二四,实际回答转为Simba。同层、同数量随机删除,Scar仍约零点九一。删除规模相近而影响不同,支持这两个中介组确实参与本次计算。它仍是当前输入和位置的局部证据。接下来再问:解释能不能在测量之前预测一个新的输入?
原图数据outs[0].p为0.9057;ko.ids=[lk,lions],ko.p.scar为0.2378。原文配文给同层同数量随机删除约0.91,没有为它提供更精确小数。舞台红叉是对原归因图的干预定位标记,不是重新测得的删除后归因边。三种条件都读P(Scar),而非准确率。
Goodfire · preeclampsia-circuit · 原文实验/图数据;据原图重排
本页采用原文轮播中的 Scar 案例,模型为 Qwen3-32B 的原生 MLP 神经元,不是前面 MAE,也不是 Claude 的 transcoder。原始提问描述市立图书馆密室失窃,唯一线索是一张留言卡:署名是“Pride Lands 中后来成为国王的幼狮的死敌”,并要求只答名字。图中给出的实际回答前缀是 The person responsible is **,接下来要预测 Scar。因此分析的对象有明确的输入与输出位置,而不是一般性地声称网络“理解狮子王”。
原图把单元按解释汇成组,方框内数字是神经元数。所示组包括 Pride Lands 词语组(6)、狮子/草原(11)、The Lion King(7)、Disney and Africa(8)、字母 scar(2)、反派(5)及 sworn enemy(3)。线宽编码组间贡献强弱;蓝边表示与答案方向相反的贡献。图里的聚合边不是一条新增的物理连线,也不是每个节点到答案都只起促进作用。原文的选图和分组用于把复杂归因图讲清楚,不是完整模型结构。
作者删除 The Lion King 与 Lions, savanna 两组,共 18 个神经元。下一个目标 token Scar 的概率约为 0.24,回答转向 Simba;同层、同数量随机删除的对照约为 0.91。原图未删除时的精确值为 0.9057,指定删除为 0.2378。这个比较支持这些单元在当前输入上的作用,不能单凭结果推出它们是唯一通路,或所有《狮子王》问题都由同样 18 个单元解决。Simba 是有结构的错误,也比随机名字更提示中间步骤出了问题。
原文先将 Claude 3.5 Haiku 的跨层 transcoder 图与 Qwen3-32B 原生神经元图对照。两模型、表示方法不同;因此不能把差异量化成哪种方法普遍更优。Qwen 医疗案例中删除四个诊断枢纽单元后询问转向另一种症状,展示的是同类“追踪—删除—看回答改变”的研究动作。本课改以无需医学背景的 Scar 案例作为主讲,医疗图与原文完整轮播保留为来源入口。
附录 Social Security: Detection and Use 回查一个由三个神经元组成的短语 probe。probe 可以准确检测 Social Security,但沿模型实际下一 token 计算所追到的路线包含词汇延续、表格字段、退休及输出单元,还存在 Social Security 与 401(k) 的竞争。研究者展示的是筛查 31 个单元中的 11 个;图中数值是删除单元后目标 log probability 变化的求和,负值意味着删除有害。检测器的成功不能自动当作模型使用那个方向作决定的证据。
来源:Nick Cammarata(与 Curt Tigges 合作语言部分),2026,Neural Networks Are Already Clean,Goodfire,preeclampsia-circuit。本课呈现原文结果及据原图数据重排的选定状态;没有重新运行模型实验。原作者权利保留。
给出原输入、下一token位置、7与11两个组,以及0.9057和0.2378的原图数据;随机对照按同层同数量匹配。
Santa实例与SwiGLU代数区分正负激活和答案贡献,展示只看正侧标签可能漏掉的机制。
Social Security探针与模型下一词路线不同,提供检测能力和因果使用的具体对照。
Kimi K3选例保留推进与阻碍、单元删除及未画路径;它不是整台大模型的审计。
能解释旧例,还不等于能预测新例。Blind maximum 先把单元解释交给看不到原高激活样本的另一方,由它构造预期强响应的输入,再读取模型激活。本页沿 action 的一个原文实例,分开解释、预测和测量。
第一位 agent 研究单元后写下一段解释。第二位只能看到这段解释,看不到单元和原来的最高响应样本。它要据此写一个预计会强烈激活单元的新句子。先把预测写下来,再去测量。这里用信息隔离减少只对旧例讲故事的空间,尚没有替解释预先宣布成功。
信息隔离是两方可见材料不同:调查方可看单元及例子,构造方只看解释。这有助于避免仅复述旧样本,但原文未在此交代完整搜索预算,不能额外承诺“一次生成、零迭代”。
Goodfire · blind-maximum · 原文实验/图数据;据原图重排
这段解释说,它对 action 表示参与活动、发挥作用的用法敏感。新句子写一位替补投手在十一季里参加了四百一十二场比赛。看英文 saw action 中的 action:不是一个孤立动作,而是参与比赛。按解释,这个位置应当接近它要找的用法。到现在我们还没有看测量值;画面下方中文只帮助理解,实际被测的是上面的英文。
原文该实例明确标峰值token为action。中文“参加比赛”帮助解读saw action,不作为另一次测量输入;字符412与eleven seasons都来自原被测句。
Goodfire · blind-maximum · 原文实验/图数据;据原图重排
原文新句子的激活是十八点四,高于那份一百亿 token 语料里找到的十五点零。比较的是同一单元的激活量,不是概率或准确率。解释帮助另一方在尚未见过的输入上作出了有效预测;语料最佳只是有限检索中的最高值,不是理论上限。不过,命中一个中心,还不知道解释的边界在哪里。下一步换一个单元,让两个句子看起来很像,检查另一种解释能否分清关系。
15.0是100亿token语料中检索到的最好激活,18.4是按解释构造的新输入的激活。它们在同一单元上比较,不是概率;中心命中不足以排除解释漏掉其他分枝,因此下一页检验边界。
Goodfire · blind-maximum · 原文实验/图数据;据原图重排
第一位 agent 可以调查神经元,形成短解释;第二位只看到这段解释,看不到单元本身、原始高激活例和其他内部细节,写出一个预期会最大激活它的新句子。然后才测量模型响应。图中 Qwen3-32B L8/N5247 的解释围绕不可数名词 action 表示“参与行动、正在起作用”的用法。第二位写了棒球替补投手在 11 个赛季中参与 412 场比赛的句子,峰值 token 为 action。原文显示 100 亿 token 搜索中找到的最佳例约 15.0,这个新句子约 18.4。二者是同一单元的激活量,不是百分比或概率。
原轮播另一例为 L56/N6360:请求到达负责方后,接下来是“我们正在处理”的谓语。新句子写软件支持团队确认能重现通知故障,停在 The devs are,激活约 99.5,对应语料中最佳为 82.0。它也提示我们,响应位置可能是即将出现某种表达之前,而非在某个主题名词上。
生成一个强例可以说明解释抓住了至少一个中心区域,却不能排除还有第二份工作。作者进一步按输入到该单元的归因聚类,在宠物芯片例中分出动物标记、走失宠物/救助、microchip/RFID 等上游束。对每束分别做盲构造,同时消融其他束,并与相同消融条件下的最强语料例比较。这样比一次中心命中覆盖更多方向,但仍不是全域完备证明。
“猫或车”这种解释可能在很多预测测试里得高分,却仍漏掉 V 形机制;观察火焰输入或反极就能击中其弱点。有效的反驳往往针对具体解释。Blind maximum 是一种预先约束信息、再测量的办法,与后面 near miss、消融和上游检查互补。
来源:Nick Cammarata(与 Curt Tigges 合作语言部分),2026,Neural Networks Are Already Clean,Goodfire,blind-maximum。本课呈现原文结果及据原图数据重排的选定状态;没有重新运行模型实验。原作者权利保留。
完整记录action的原文句子、峰值token、15.0与18.4激活,以及信息隔离与未规定搜索预算的区别。
软件支持团队例与宠物芯片分束展示中心命中之外的覆盖检查,区分不同单元和不同消融条件。
继续比较spoken for原例与近失配,再看完整样本的分母、阈值和失败例。
现在换到另一个单元 L36/N15664,检查解释的边界。前页 action 单元是 L8/N5247;这里 spoken for 的候选含义是已经许诺归属、尚未交付。两个原文文本前缀保留相近题材,却分别说许诺小马归属与运输母马;相对激活的差异检验关系判断,而非仅识别“马”这个主题。
上一页检验了 action 的中心新例。现在换到另一个单元,检验 spoken for 的边界:东西或人已经许诺给某一方,但尚未交付。原文展示的英文前缀说小马还没出生,饲养者就已许诺把它交给某马厩。它同时满足归属承诺和尚未交付。前缀停在for是原图的展示形式,不是让我们补写答案。我们先根据已经出现的关系作预测,再看相近却不满足关系的输入。
原文figure #explanations-could-lose确实把文本展示到for为止;这里保留其前缀身份,不补写后续。现有正文与图例没有明确标出这对例子的峰值token、索引或取值位置,因此不将最后的for另标成已知测量token。
Goodfire · explanations-could-lose · 原文实验/图数据;据原图重排
第二个前缀保留小马、出生前与马厩,改为把母马运过去。promised it描述小马归属的许诺,driven the mare只说明母马发生运输。原测量分别为最强语料例激活的百分之八十一和百分之二十,区分的是关系而不只是题材。百分之二十仍有响应,但低于原测试百分之三十的强响应阈值;它不是理解准确率,也不是答案概率。
promised it描述对小马归属的承诺;driven the mare描述运输母马。原图相对激活为81%和20%,分母是该单元最强语料例。20%并不等于零,它低于完整测试使用的30%强响应阈值。
Goodfire · explanations-could-lose · 原文实验/图数据;据原图重排
接下来换到完整样本,不再只看刚才的单元。随机抽取的二百个单元中,一百八十三个解释描述正侧,进入这一测试口径;每个都有五个新例和五个近失配。以最强语料例激活的百分之三十为阈值,强响应率是百分之七十六和百分之十一。逐单元比较,有一百六十四个赢、十五个平,也有四个输了。这比只列成功例更有信息。近失配主要检验边界,若单元还有别的工作,仍需检查那些方向和实际作用。
183是随机抽出的200个单元中解释描述正侧的子集,每个解释各有5个新例与5个近失配。76%和11%是这些输入达到30%阈值的比例;164/15/4是逐单元比较的赢/平/输,分母与输入条数不同。
Goodfire · explanations-could-lose · 原文实验/图数据;据原图重排
本页换到另一个单元;前页 action 的中心命中与这里的边界测试不属于同一单元。主图单元是 Qwen3-32B L36/N15664,解释为“东西或人已经答应给某一方,但尚未交付”,即 spoken for。命中句写小马还没出生,饲养者就已许诺给某马厩;near miss 保留小马、马厩与出生前的情境,却改成把母马送到马厩,并没有许诺归属。原图给这两个文本前缀报告的响应分别为最强语料例的 81% 与 20%。第二对葡萄酒预售约定与已经出售的例子为 43% 与 16%。
这些百分数是激活值相对于该单元最强语料例的比例,既不是答案概率,也不是“81%的句子理解正确”。两句只换关键条件,是为了减少用大类主题就能蒙对的可能,但仍不能证明唯一机制。
原图的两个英文片段都止于 for,葡萄酒例止于 at;这就是原文提供的展示内容,不在课堂替实验续写。原文正文、图注和该对例子的HTML没有明确标出峰值token、token索引或取值位置,因而只能核定文本展示与相对激活读数,不能把最后一个词直接宣布为测量位置。
主图展示最初 20 个单元;每个解释生成 5 个命中新例与 5 个近失配,因此各 100 条。以达到最强语料例的 30% 为强响应阈值,命中有 81/100,近失配 8/100;20 个单元的均值比较都在命中侧更强。
附录的完整测试从 gallery 随机取 200 个单元,其中 183 个解释描述正侧进入这一口径:命中新例强响应约 76%,近失配约 11%;逐单元比较赢 164、平 15、输 4。不能把主图的 81%/8%当成全部 183 单元的结果,也不能悄悄删除失败的 4 个。
一个真正同时做 X 或 Y 的单元,也可能把“不属于 X 或 Y”的近失配拒绝得很好。因此 near miss 检查的是边界,不单独判定概念为什么共处。作者还让 agent 构造尽可能遥远的概念,每单元 5 条,这些文本强响应约 1%;183 个单元中有 179 个在这些文本上从未强响应。但“agent 想到的远概念”仍不是整个可能输入空间。
好的解释要接受多种批评:中心新例、相近反例、远概念、符号分区、上游构成和实际干预。本文据这些结果提出组织机制假说,仍不把它们变成全模型的完备证明。
来源:Nick Cammarata(与 Curt Tigges 合作语言部分),2026,Neural Networks Are Already Clean,Goodfire,explanations-could-lose。本课呈现原文结果及据原图数据重排的选定状态;没有重新运行模型实验。原作者权利保留。
从 gallery 随机抽 200 个单元后,183 个解释描述正侧。agent 先只读解释,分别写五个应该激活的新例和五个近失配,再测响应;达到语料最强响应的 30% 算强。完整样本的新例强响应率为 76%、近失配为 11%,按单元计赢 164、平 15、输 4。主图展示前 20 个,81/100 对 8/100 是这个子集的数字,不能与整体混写。
近失配检查语义边界,却不能独自区分“X 或 Y”的任意打包;它对 X、Y 都可以有清楚边界。作者另让 agent 写最遥远概念,约 1% 达强响应,179/183 个单元没有一次强响应。有限构造仍不穷尽所有潜在用途。Blind maximum 测中心、近失配测边界、遥远概念挑战无关分支、路径与干预再问怎样发生;没有一个单分数替代其余工作。
原文 Explanations That Could Lose · GF23 · GF24
前20个单元的子集与完整统计对照画面。此处保留两个分母供核对;本页课堂统计只使用183个正侧解释口径。
两个原文前缀及81%/20%读数并列;解释归属许诺与运输母马为何不同,以及来源没有给出的token定位边界。
原子集图和完整统计分别保留,核对各5条、30%强响应阈值、164赢15平4输。
正文说明近邻边界测试为何不能单独排除另一个无关分枝,并保留遥远概念结果和覆盖范围。
原图保留止于for/at的文本展示、相对激活条及前20单元;正文给出完整183口径。
在 V4 选择 EVIDENCE_CASE="RG24",先写预测,再揭示原研究的近失配证据;本活动不重新测量模型激活。
局部研究和干预之后,才能回头读总体估计。约90%的对象是 Qwen3-32B 初步审查中的 neuron poles,即神经元响应的正侧或负侧;判断标准是一个主要工作及相关分枝。这个数字随激活阈值与工作划分粒度而变。
经过局部检验,回头读总体说法。原文的“约九成”,指 Qwen3-32B 初步审查中,神经元的正侧或负侧,通常能用一个主要工作及相关分枝来描述。这里的 poles 就是响应的两个侧向。阈值和怎样划分“一项工作”会影响结果;它不是参数解释进度,也不覆盖所有输入。下面这组尚未解释好的响应,应当留在结论旁边。
poles在这里指正、负响应侧向,判断通常针对每一侧的主要工作及相关分枝。弱激活阈值与工作划分粒度会改变分类;原文约90%、约7%、约2–4%是近似估计,不能相加后硬凑精确100%。
Goodfire · language-models · 原文实验/图数据;据原图重排
原文开头明确说 neuron poles:约 90% 有一个主要工作,常伴随相关小分枝;另约 7% 有两个相关工作;约 2—4% 尚未理解。正文有时简写为 neurons,本课按更明确的 poles 口径呈现。它们是作者的粗略估计,阈值与“一个工作”的粒度会影响结果;各项近似数不应硬凑到 100%。这不是全部参数的解释比例,也不是各种输入上的机制覆盖率。
深层、弱激活阈值、上游子电路密度、跨语言近义表达是否合并,都改变评定。例如 Titanic 的弱响应可能延伸到航行、蒸汽机或时代背景;有时工具只看向前上下文,漏掉单元在提示下一个 boat token。作者另称少量深入样本的强激活下约 97% 为非任意混合;这个更小、选择更深的集合不替代总体估计。
原站提供随机选择的 1000 个单元的详细研究页,帮助检查具体解释。它们是可打开的研究材料,不意味着每一篇都经过相同强度的穷尽验证,也不等于所有单元。正文中的比例与每个图的对象范围应分别读。
2023 年 OpenAI 自动解释项目在 GPT-2 XL 上宽松口径也不到 2% 可解释。作者这次用近乎不迭代的流程再写 500 篇单元研究,约 70% 看起来有一个粗略工作、约 5% 很纯;但评分协议不同。更好的工具、研究者对 motif 的认识和模型架构/规模都可能影响可读性,不能用“2→70→90”折线宣称一次控制实验的进步。
原文对 2023 Towards Monosemanticity 某个被称为混合学术引用、对话、HTTP、韩文的单元提出“不要接句点”的替代解释:负 logit 连接多与句点有关,韩文例位于音节未完成处。但作者没有那个模型继续实验,韩文也可能是第二个相关模式,因此这里只能保留候选解释,不能宣布旧例已彻底解决。
附录认为,精确模拟每个激活值会同时考验注意力把信息放在哪个标点、弱响应衰减率,以及解释模型输出精确数值的能力。一个解释可能抓住机制,却因这些因素得分低;反过来“猫或车”也可能模拟得不错却漏掉 V 形结构。模拟分数可作为一种指标,但不替代具体新例、近失配与因果实验。
附录报告 agent 阅读 100,000 张归因图,作者亲自检查数千张图像与语言图。作者尚未发现一个大组的联合活动持续无法解释,但明确把这视作定性证据,认为当前工具不足以换成精确“清晰度分数”。一个可信反例就可能明显改变其判断。因此“研究仍在继续”体现在具体可改变结论的例子和测量协议里,不是泛泛一句保留意见。
来源:Nick Cammarata(与 Curt Tigges 合作语言部分),2026,Neural Networks Are Already Clean,Goodfire,language-models。本课呈现原文结果及据原图数据重排的选定状态;没有重新运行模型实验。原作者权利保留。
模拟器要预测精确数值,也要猜注意力把信息放在哪个标点上。一个解释可能抓住了单元的主要判断,却不擅长预测物体缩小时激活下降的精确速率;反过来,一个“猫或车”的预测器也可能在原例上得分很好,却错过 V 形。作者建议把模拟分数当成若干检验之一,并配新例、近失配与干预;这不是说数值预测没有用途,而是计分目标与研究问题必须对齐。
原文 On Simulation Scores · GF25
作者让 agent 审阅约 100,000 张归因图,并亲自检查数千张视觉与语言图;他报告很多异常在辨认新的模式后消失,尚未找到一个仍无法解释的重要单元群。但作者明确把它看作定性证据,没有把现有工具的结论压成可信“清洁率”。审阅数量不等于无偏样本、统一协议或完整覆盖;真正有力的反例仍可能改变判断。
原文 Audits of Attribution Graphs · GF25
约7%与约2–4%的完整近似分类、阈值与工作粒度、GPT-2 XL历史协议对照。
解释neuron poles、主要工作与相关分枝;保留约7%和约2–4%的近似分类而不强制凑到100%。
从具体弱响应及消融范围理解激活阈值,区分单元数量、响应幅度与实际因果作用。
GPT-2 XL历史与再审计协议、simulation score及归因图定性审阅各有对象,不能与Qwen比例直接连线。
用mixed5a:719的自然响应检查“一个主要工作”是否真的接住反例,给总体判断留可修改之处。
一个尚未解释清楚的单元可以帮助检验总体判断的边界。InceptionV1 mixed5a:719 响应领结、蝴蝶和泳衣,也响应礼鞋、沙滩包与拖鞋。简单的“中间收窄”概括不能接住全部证据,剩余部分应继续作为研究问题。
先看 mixed5a:719 这组响应。领结、蝴蝶与泳衣这些对象,中间都收窄、两边张开,“沙漏形”是一个可能的概括。原图上部保留同一单元的优化图与自然例,两个视角都指向类似形状。这个名字是候选解释,不能在几张顺眼的图上就结束。接着看同一个单元剩下的响应。
本态展示原图上部响应证据的固定视窗。中间收窄是从当前可见对象提出的候选,不是作者已经证明的完整函数。优化图和自然例受不同选择因素影响,应一起读。
Goodfire 原文、原图及其同源交互数据;本页按原数据重绘与中文讲解。
继续往下看,礼鞋、沙滩包与拖鞋没有都满足刚才的简单描述。作者找到一些共同来源,也提出带着语义残留的泛化解释,但还没有完全讲清。我们保留这些响应为待解决问题,不把标签无限放大后宣布成功。照片里有这些响应是观察;为什么相连是候选解释;整个网络多清晰则是更大的判断。能追到局部机制已经让研究前进,还不等于模型被解释完了。
保留上部缩略定位后才出现下部礼鞋、沙滩包与拖鞋。共同早期来源可以提示解释方向,却尚不足以说明全部响应;这就是应保留的具体未知。作者的85%另属总体机制判断的主观信念,不能作本例覆盖率。
Goodfire 原文、原图及其同源交互数据;本页按原数据重绘与中文讲解。
主文 Unresolved / counterevidence;附录 On the Title。作者约85%的数字是对其总体机制判断的主观信念,不是逐神经元解释覆盖率。
InceptionV1 mixed5a:719 会响应中间收窄的领结、蝴蝶、泳衣上部,也响应伴随它们的礼鞋、沙滩包和拖鞋。作者倾向于把它读成共同形状加语义残留,因为早层共享通路;但他没有完全解释这些例外。课程保留这个对象,是为了让“还不知道”可以落在一组实际反应上,而不是被一个足够宽的名字抹掉。
原文 Unresolved Responses · GF30
作者把两件事分开:旧模型混乱的经典解释是否成立,以及任意打包会不会在下一规模出现。后一项没有由前一项直接排除。他的猜想是更成熟的相关电路更容易吸引新知识,罕见事实则沿相关通路生长,因而规模增大可能加强组织而非任意打包。可检验的预测是承载罕见事实的单元与注意力头应和事实内容有关。原文明确没有证明这一发展机制,不能据此保证更大模型永远更清楚。
原文 Does Scale Help or Hurt Superposition? · GF28 · GF30
作者没有完成所有网络的全审计。他说约 85% 确信的是“几乎所有机制可能来自这一类组织过程”的假说,而不是报告“85% 神经元已解释”。标题表达的是对生成机制的判断变化,不能用作清洁率、正确率、安全性或对齐程度的测量。本文的有力之处在具体案例与可继续检查的方法;它的雄心仍需更多模型、协议和反例承受。
作者目前观察到的旁枝通常较罕见,在各自语境中也较少具有主干那样大的因果作用,因此不像罕见但极关键的隐藏机制。这是经验判断,并非保证;它还提出未知的抑制过度生长压力。研究上有价值的是能够解释旁枝的来路与作用,而不是仅统计 top-k 与一个标签吻合多少。若出现少见却影响巨大的分枝,就应更新这一判断。
原文 Why We’re Not Worried About Recursive Generalization · GF21 · GF30
原图保留领结、蝴蝶、泳衣与礼鞋、包、拖鞋;共同来源是线索,不能替代完整机制解释。
保留输入控制、响应测量、连接与干预的研究候选,明确方案尚不是已完成实验。
区分作者85%主观信念、初步审计的比例与可扩展性假说,说明哪些新结果可改变判断。
把三个层次重新接在一起:记忆装置展示结构的承载与读取,MAE 独立评测检验训练收益,Goodfire 案例追踪内部区分与作用。接下来回到先前 MAE 的可见 patch 表示,让这些向量进入实际矩阵计算,讨论并行、存储与搬运。
记忆装置帮助我们理解承载与读取的可能性;视觉训练检验这种可能性有没有转成任务收益;猫与车、Scar 这些案例进一步追内部形成了什么、怎样参与计算。这三类证据接起来,才逐步回答模型怎样学到并用上知识。它们相互补充,不能拿其中一类替另外两类作答。现在把表示放回一轮真正要执行的计算。
三行分别回指默认课堂已经展示的联想记忆装置、MAE分类结果、猫车与Scar,不依赖迁到深入层的其他案例。MAE与Goodfire是不同模型与研究设置,三类证据只能按各自对象连接。
AM 随机向量检索装置;MAE · He 等(2022)· Figure 2 / Table 3;Goodfire 原文局部机制案例
回到前面这张校车图。进入这一轮 MAE encoder 的是可见 patch,每个位置成为一个向量,排成矩阵 X。后面一层层的变换,要靠共享权重和这些表示实际算出来。下一步就沿这一批向量看:哪些计算能一起做,训练时要保存什么,数据又要怎样搬运。同一个W会作用于X的许多行,这就是下一页要打开的多行计算。
X在此表示已经嵌入的MAE可见token向量,不是整幅原始像素。W表示接下来要看的某层共享变换;图只定位对象,没有为MAE另造维度或测量。计算桥继续沿X与W展开,而不重讲视觉实验。
MAE · He 等(2022)· Figure 2 校车遮挡输入;X 与 W 为教学计算定位示意
本页先回收记忆装置、MAE任务结果和Goodfire局部机制各自回答的问题,再明确返回MAE encoder的计算对象。校车遮挡图沿用MAE Figure 2的原图证据,X与W图形只定位计算关系,没有新增模型测量。
本课既有 N11–N19 与后续 N20。此桥接图为教学定位图;校车图沿用本课 MAE Figure 2 既有证据资产,不引入新模型结果。
用本讲实际出现的三个对象梳理各自支持的判断,明确Goodfire并非对刚才MAE的内部审计。
核对可见patch、encoder、重建目标和分类迁移,再识别进入下一段的表示矩阵X。
沿可见token排成的X与共享W展开矩阵运算,区分行内并行与层间计算依赖。
一批已知位置的表示可排成矩阵 X,共用投影 W 形成 XW。位置并行是计算的组织方式,attention、MLP 和后续层仍有先后依赖。图像与文字可共享这类算子接口;可读取的位置则由各自任务规定。
继续沿这批 MAE 可见图块看。每个已知位置经过前面的处理,得到一行表示;把这些行排起来,就是矩阵 X。W 是接下来共享使用的投影参数。图里的色块表示坐标位置,不是这台模型的实测激活值。我们先保持输入与参数身份,看看输出怎样产生。
此处沿用 RG32 的 MAE 校车遮挡图与可见 patch 身份。X 为行向量排成的矩阵;不是把先前 Goodfire 的单元当作 MAE 实测结果。
教学构造与机制示意;非模型实测
同一个 W 分别作用于 X 的许多行,结果排成输出矩阵 XW。每行接受相同的变换,因而能组织成硬件擅长的矩阵运算;增加输入位置会增加工作,却不要求为每行另学一套 W。图像和已知文字位置都可以这样排成多行,但接下来允许各行读取谁,还由任务决定。
设 X 为 T×d、W 为 d×h,则 XW 为 T×h。T 改变行数,W 的形状可以不变。这里只打开共享线性投影,不把完整 Transformer 层简化为一个矩阵乘法。
教学构造与机制示意;非模型实测
下方是运算依赖:attention 先产生当前表示,MLP 才能接着变换,再送到下一层。能一起做的是依赖已经满足的工作,不是让所有层同时完成。为看清文字预测的读取边界,下一页借上一讲的半句英文,只跟踪 gave 这一行,然后再回到 A/B 记录。
教学构造与机制示意;非模型实测
以下从计算对象、条件与原始证据继续展开。
同一投影作用于已知输入的许多行,可实现为大矩阵乘法。GPU 矩阵计算单元及 CUDA、Triton 等实现层负责组织具体执行;它们不改变数据依赖。图像 encoder 与因果文本模型可共用部分矩阵算子,但可见性规则不同。算子内的位置并行不能取消 attention、MLP 与层之间的先后依赖。
来源:Transformer 矩阵计算;L5 T34。
相关的完整阅读材料保留原有公式、引用和原始图解。
沿 X 的每一行、同一个 W 与输出行核对尺寸,解释哪些计算能并行、哪些必须等待。
用 BOS / I / gave / him 的前缀—目标对照,分清数据已知与当前预测可见。
文字预测可以成批处理已知位置,同时让每一行只读取合法前缀。完整位置表的大小是 n²,因果有效配对是 n(n+1)/2:4 个位置分别为 16 与 10,8 个位置分别为 64 与 36。参数不必增加,中间计算与状态却会增长。
先借上一讲的英文片段检查一行。gave 这一输入位置允许读取 BOS、I 和 gave;右侧 him 是要预测的目标。训练文件虽然包含完整句子,当前行也不能把后面的输入 him 当线索。这是在文字任务里添加的因果规则,与多行能否成批计算是两件事。
教学构造与机制示意;非模型实测
现在离开具体句意,只改变位置数,做一个隔离长度影响的计数。四个 query 与四个 key 有十六个完整配对;变为八个位置后有六十四个,金框标出原来的四乘四范围。参数规则没变,但本次需要处理的位置关系增加了。
4 与 8 是独立教学计数,并不是给上一态的英文句子补写一倍文本;完整配对 n² 与因果有效配对 n(n+1)/2 必须区分。
教学构造与机制示意;非模型实测
若只允许因果前缀,上三角不参与读取:四个位置是十项,八个位置是三十六项。有限长度下增长三点六倍,不是恰好四倍;两种计数都呈二次量级。图中参数 W 与本次中间表要分开看。工作量增加以后,这些对象还要有地方保存、有通路送去计算。
n=4:1+2+3+4=10;n=8:1+…+8=36。这里仅讨论稠密 attention 位置配对项,不把投影、MLP 等全部成本归为平方项。
教学构造与机制示意;非模型实测
以下从计算对象、条件与原始证据继续展开。
输入 BOS / I / gave / him 对应下一词标签 I / gave / him / a。gave 行可读取 BOS、I、gave,而不能读取后面的输入 him。标签 him 在目标端,不作为该行可见输入。训练前向之后另有 loss 与反向更新;推理 prefill 处理已知提示,只做前向;decode 生成未知新 token,需要逐步等待。
来源:L5 T30/T34 的因果训练与生成;原句片段固定使用 him。
相关的完整阅读材料保留原有公式、引用和原始图解。
dense attention 的完整分数矩阵尺寸为 n²;n=4 时16格,n=8 时64格。因果有效配对数为 n(n+1)/2,分别为10与36,有限 n 下比值为3.6而非4,但同属二次增长。投影参数可以不变,激活和注意力中间状态仍随序列长度增长。整个模型还有投影与 MLP 等不同增长项,不能将所有训练成本都写为 n²。
来源:FlashAttention v2对 dense attention 中间矩阵的分析;4/8为教学构造。
相关的完整阅读材料保留原有公式、引用和原始图解。
完整输入—目标对齐和因果可见区,说明为何批量训练不等于允许看未来。
从完整方阵和有效下三角分别复算 16→64 与 10→36,并说明二次项的适用范围。
显存保存大对象,片上工作区接收当前计算需要的数据。直接分阶段 attention 可以把 S、P 等完整中间表写回后再读;这使计算吞吐、容量与搬运带宽成为不同约束。后续分块执行改变的是保存与读写安排,仍需完成规定的读取目标。
左侧是高带宽显存 HBM,保存较大的输入、参数和中间结果;右侧是靠近计算的片上工作区,容量小得多。当前要算 Q 与 K 的匹配,先沿蓝色箭头把数据读过来。数据已经放在显存里,并不等于计算单元已经拿到它。
HBM 是 High Bandwidth Memory;本图只区分显存与片上工作区的职责,不给某型号芯片的容量或速度。
教学构造与机制示意;非模型实测
算出分数表 S 以后,一种直接实现把它写回 HBM;下一阶段再读出来做归一化。于是一次预测除了乘加,还包含保存、写回和再次读取。红线表示写回,蓝线表示读入,方向不同但处理的是同一个中间对象 S。
S=QKᵀ(可带任务规定的缩放与 mask),后续 P=softmax(S),再 O=PV。这里保留代表性的 S 写回与重读,完整三阶段读写和分块比较在 RC-T3 展开。
教学构造与机制示意;非模型实测
现在可以区分三张账:容量看要保存多少,带宽看单位时间要搬多少,算力看乘加要做多少。完整大表能否少写回,后面还会回到这幅图。先问这些昂贵运算为何值得反复做:MAE 用原图构造目标,普通文字又怎样提供训练目标?
教学构造与机制示意;非模型实测
以下从计算对象、条件与原始证据继续展开。
直接 attention 实现会生成分数矩阵,写入显存,再读出做 softmax,随后使用归一化权重汇总 V。HBM 容量、片上工作区容量、计算吞吐和数据搬运带宽是不同约束。这里先定位问题;N49–N51 回到同样的内存层级,用分块与在线归一化解释如何减少保存和搬运,不提前把名称当答案。
来源:FlashAttention v2,§3.1 IO 分析。
相关的完整阅读材料保留原有公式、引用和原始图解。
沿 Q/K→S→P→O 定位每个对象在哪里,理解计算与搬运为何是两张账。
比较直接实现和分块实现;保留所有允许位置,并解释必须共同归一化的原因。
语言建模把完整材料拆成“合法前缀”和“实际后续”。A/B记录的完整文本是训练资料;在某个位置做预测时,模型只读该位置及此前内容。后续单位用于计分,而不是提前出现在当前可见输入中。改变截断位置,同一段资料便产生另一道预测题。
前面MAE有完整图片,再遮住部分像素作为预测题。现在把材料换成同一份A/B记录:相同设置下A用时十二秒,B用时八秒,内存没有测量。这段普通文字没有附带人工编写的问题和答案,但已经包含每个位置实际出现的后续。画面上方是完整资料,我们先保留它,再把某一次预测能读到的输入单独取出来。
A/B记录为教学构造;语言建模目标对应GPT-1 §3.1。
同一份材料 → 多个前缀与下一项目标
看第一条输入副本:它只读到“B用时”,未来内容被挡住。完整资料中接着出现的是八,所以训练程序知道这一次应当用八来计分。模型此刻要产生的是下一项的概率分布;八在独立目标端,并没有进入这一行的可见前缀。资料完整存在和当前预测不能偷看后续,可以同时成立。
“输入副本”表示当前预测的可见范围,不要求实现中真的复制出许多字符串。整段并行训练可用因果遮罩同时实现各位置的前缀约束。
A/B记录为教学构造;语言建模目标对应GPT-1 §3.1。
同一份材料 → 多个前缀与下一项目标
再换一个截断位置,读到“未测量”,目标就变成“内存”。同一段材料因此能在许多位置不断出题:有些要求表达习惯,有些要求数值与对象对应。目标来自原文,不是自动核查现实;记录若写错,训练目标也可能带着错误。先把目标组织清楚,再谈材料质量:如果整段都参加一次训练,每个输入位置该对应哪一项?
本页以可读词块说明机制;实际tokenizer可能将数字、标点或词语分成不同数量的token。后续页的16单位也属于明确指定的教学切分。
A/B记录为教学构造;语言建模目标对应GPT-1 §3.1。
| 当前合法前缀的末尾 | 原文实际后续/目标 | 当前预测不能读取的部分 |
|---|---|---|
| B用时 | 8 | 8及其后的未来输入 |
| 未测量 | 内存 | 内存及其后的未来输入 |
完整资料用于构造监督;前缀用于生成预测;目标用于评价预测,三者职责不同。
普通记录能够提供语言建模监督:给定一段合法前缀,用材料里真实出现的下一单位作为目标。本例在“B用时”之后预测“8”,在“未测量”之后预测“内存”。完整原文属于资料区,模型的当前输入副本仍受因果限制。这里学习的是材料分布;训练目标本身不会自动核验记录是否符合真实世界。
用“B用时→8”和“未测量→内存”两对输入与目标,区分完整资料、当前可读前缀和计分端。
从开始标记到结束标记核对输入和目标的错位,说明因果可见性与同层并行如何同时成立。
从材料构造监督,接到概率、损失、参数更新与能力评价,解释预测后续为什么既有用也有边界。
从同一 A/B 记录生成多组前缀与目标,区分教学切分和真实 tokenizer。
本例把正文分成16个可读教学单位,令x₀为开始标记BOS,x₁到x₁₆为正文。输入位置i读取x₀到xᵢ,预测下一项;末尾正文位置预测结束标记EOS。第二个“用时”位于x₉,其目标是x₁₀=8。所有位置共用参数,因果遮罩分别限定每个位置的读取范围。
同一段记录被分成十六个方便读图的单位。这里的token是教学单位,真实分词器不一定这样切。金色的是第二个“用时”,它紧接B、后面是八。先认出这三个相邻对象;下一步只重排输入与目标,不更换材料。
指定16单位的教学切分;因果语言建模目标对应GPT-1 §3.1。
BOS是开始标记,它所在的位置预测第一单位“在相同设置下”。向后看,金色第二个“用时”记为x₉,它产生的预测要对照下一项x₁₀,也就是八。末尾句号对应的下一目标是结束标记EOS。因此两排各有十七格:上排是输入位置,下排是该位置应预测的后续,不能按相同文字把上下格直接配对。
索引从0开始:x₀=BOS;x₉是第二个“用时”,即把BOS计入后第10输入列。目标为x₁₀=8。x₁₆是正文末尾句号,其目标为EOS。
指定16单位的教学切分;因果语言建模目标对应GPT-1 §3.1。
现在固定金色x₉这一行。它允许读取x₀到x₉,包括已有的A十二秒和B用时;x₁₀以及更后面的输入不可读。目标八仍留在计分端。训练程序可以一次持有整段文字,却必须对每个预测位置分别执行这样的因果可见性规则,否则任务就变成把未来答案抄回来。
指定16单位的教学切分;因果语言建模目标对应GPT-1 §3.1。
其他位置也各有自己的合法前缀、目标概率和损失Lᵢ。各项损失汇总后约束同一组参数θ,不是一列对应一台模型。同层的输入已知,可以批量计算;每行可读谁仍由因果规则决定。现在我们把十七项中的金色目标单独拿出来,追一次概率怎样变成可用于更新参数的数。
训练损失可以对选定位置求和或求均值,本页只表达多个位置共同训练共享参数。具体归一方式、padding目标和实现移位约定须一致。
指定16单位的教学切分;因果语言建模目标对应GPT-1 §3.1。
| 输入位置 | 可读取的前缀 | 目标 |
|---|---|---|
| x₀=BOS | BOS | x₁“在相同设置下” |
| x₉=第二个“用时” | x₀…x₉ | x₁₀=8 |
| x₁₆=末尾句号 | x₀…x₁₆ | EOS |
标签向后错开一项解决“预测谁”;因果mask解决“读取谁”。这两个设计不能互相替代。
本例采用16个可读教学单位,非真实tokenizer输出。记x₀=BOS,x₁…x₁₆为正文;输入位置i使用x₀…xᵢ,预测xᵢ₊₁(i=0…15);位置16预测EOS。因此上、下两行各有17项。第二个“用时”是x₉,也就是把BOS计为第1列后的第10输入列;对应目标为x₁₀=8。因果mask阻挡未来输入,不会把标签变成当前可读内容。各位置使用同一组参数,训练序列已知带来同层并行,并不取消每个位置的可见范围。
列出16个正文单位与BOS/EOS,核对首列、第二个“用时”及末列,分开标签对齐和输入可见性。
固定目标8,比较两组假设概率的负对数损失,再沿前向、反向和优化器走一次更新。
检查 input、target、causal mask 及 BOS/EOS 对齐,说明各位置怎样使用同一组参数。
对当前实际目标8,单项损失可写为−ln pθ(8|前缀)。假设概率0.2与0.5分别对应约1.61与0.69的损失,说明评分规则偏好给实际后续更高概率。两张卡是独立对照。训练则要从一组参数完成前向、求损失、反向求梯度、优化器更新,再用新参数重新预测。
目标仍是前一页的八。假设第一组预测给八零点二的概率,取负自然对数得到约一点六一;第二组给零点五,得到约零点六九。其他条件相同,对实际后续分配的概率越高,这一项损失越小。这两张卡只比较评分规则;右卡不是左卡经过一次更新后的测量。
本页取自然对数:−ln(0.2)=1.609437912…;−ln(0.5)=0.693147181…。不同对数底会改变数值尺度,本课全程采用自然对数。
概率0.2/0.5为独立教学假设;损失按自然对数复算,未声称一次优化实测。
现在沿第一组预测看训练。输入表示进入Transformer,再经词表头得到分布;目标八选出要计分的概率。反向传播沿这条计算依赖求梯度:如果想改变损失,各个参与计算的参数该怎样改变?红线回到表示参数、attention、MLP和词表头等位置。原文中的十二和八仍是输入材料,梯度并不改写这些文字。
反向传播求的是损失对可训练参数的导数。输入token身份固定,但其被查取的embedding参数若未冻结,仍可通过本次计算获得梯度。
概率0.2/0.5为独立教学假设;损失按自然对数复算,未声称一次优化实测。
优化器根据梯度和自己的状态,将参数θ更新为θ′,然后必须重新做前向计算,才知道新的分布是什么。不能从两张示意卡断言一次更新就把零点二变成零点五:一次更新还汇总其他位置与样本的影响。样本、目标、损失、梯度、更新已经连成闭环。下一问是:后词预测究竟可能要求模型处理多长、多复杂的关系?
概率0.2/0.5为独立教学假设;损失按自然对数复算,未声称一次优化实测。
| 假设预测 | 目标8的概率 | 单项损失 −ln p |
|---|---|---|
| 一 | 0.2 | 1.6094 |
| 二 | 0.5 | 0.6931 |
两行只是同一计分规则的对照。一次训练遵循:参数θ与输入→前向分布→目标损失→参数梯度→优化器更新为θ′→重新前向。输入文字不因反向传播而被改写。
语言模型位置损失为 $L_i=-\log p_\theta(x_i\mid x_{<i})$,整段损失可取选定位置之和或均值。对目标8,假设概率0.2对应损失1.6094379,假设概率0.5对应0.6931472。两张概率卡只是计分对照,不是一轮优化的前后实测。训练闭环为前向分布、计算损失、反向梯度、优化器更新,再重新前向;一次更新不保证所有样本的损失同时下降。
保留两组独立概率卡和负对数计算,区分计分对照与一次实际参数更新的完整依赖链。
把本页的参数、梯度和优化器接到训练显存账,说明权重文件为什么不等于训练现场大小。
核对一次真实轻量 RNN 更新前后的参数、loss 和目标概率;不把教学计分预设为实测结果。
在“The trophy would not fit in the suitcase because it was too big/small”这组教学对照中,对象和放入动作保持不变。big通常把原因连到奖杯过大,small通常把原因连到手提箱过小。要给出明确解释,就需要结合物体、容器及失败原因,而不能只按名词距离决定指代。
把完整句子读完:奖杯放不进手提箱,因为它太大。两个物体先只标明角色:奖杯是要放进去的东西,手提箱是容器。我们要判断的不是哪个名词离it最近,而是哪一个对象“太大”能够解释放入失败。先保留这个问题,不让图片大小替我们直接给答案。
图形是物体/容器角色示意,不把画出的几何尺寸当作实验测量。任务条件来自完整句子。
Winograd式奖杯/手提箱教学对照;图中解释为教师参考。
通常的解释是奖杯太大,相对于手提箱的可容纳空间放不进去。图中的尝试放入把原因和结果接了起来:物体过大,阻碍放入。最近的名词其实是手提箱,仅靠最近名词规则就会偏离这里的合理关系。显示的是教师参考;它提出任务需要什么关系,并不是一台模型已经做对的证据。
Winograd式奖杯/手提箱教学对照;图中解释为教师参考。
现在只把big换成small,名词顺序、两个角色和放入动作都不变。合理原因转向容器:手提箱太小,容不下奖杯。若沿用上一态的“选奖杯”,就忽略了刚刚改变的条件。模型若要明确解释这句话,必须让small与容器容量这层关系参与当前判断。
Winograd式奖杯/手提箱教学对照;图中解释为教师参考。
两种原因放在一起:奖杯过大,或手提箱过小,都能解释放不进去。逐个输出token只是输出接口,不把所需依赖限制在相邻一个词。当前句子给本次条件,训练参数可能提供语言和关系模式;是否真的学得可靠,还要独立测试。接下来先看不同训练材料会反复提出什么要求,再看真实的迁移评价。
该例展示任务可能要求的关系,并不证明任何模型已获得稳定常识。检验模型应使用受控变式和独立评价,而不是只展示教师给出的正确答案。
Winograd式奖杯/手提箱教学对照;图中解释为教师参考。
| 句子中改变的词 | 通常指向的对象 | 如何解释放入失败 |
|---|---|---|
| big | 奖杯 | 物体相对容器过大 |
| small | 手提箱 | 容器可容纳空间过小 |
对象、顺序和动作未变,改变的是造成失败的条件。该对照说明任务要求,不能替代模型能力测量。
这是沿用的Winograd式奖杯/手提箱教学改写。完整条件中,物体相对容器过大可以解释放入失败,所以教师参考把“太大”连到奖杯。它展示预测可能需要的关系,不能作为模型真实输出或基准准确率。最近名词、固定选择第一个名词等浅层规则并不足以稳定完成这些关系判断。
只把big改为small,两个物体的位置与放入关系保持不变。当前正常解释转为容器太小。直接翻译成“它太大/太小”不必然错误,只是把指代消解留给读者;本例显式消歧是为了展示关系变化,不宣判唯一正确译文。是否学到可靠常识,需要更多受控变式与独立评价。
源句提供当前对象、动作和big/small;目标前缀提供已经表达的内容;参数提供训练所得的语言与关系模式。encoder-decoder可由cross-attention读取源表示H,decoder-only可把源句和指令组织进同一因果前缀,两者都可以自回归输出。逐token生成本身不排斥常识,也不能保证常识可靠。
从big句子的物体、容器和放入失败关系解释教师参考,保留构造例身份。
并排比较big与small;同时说明直译为“它”可以保留歧义,本例不规定唯一中文译文。
把本次条件、已经表达的内容和训练所得语言模式放在不同位置,比较两类条件生成接口。
比较成对输入与实际输出;把教师参考答案、轻量训练和独立诊断分别看待。
打开本册后,找到同名小节。
相同的语言建模目标可以作用在关系句、实验记录和代码上,但三类材料分别要求因果条件、数值对象对应和程序依赖。材料类别并不自动等于获得的能力。资料库存、抽样后的训练消费和重复次数也必须分开:未被抽到的材料不构成这轮训练经历,重复读取则重复消耗计算。
三类教学材料:合法前缀 → 实际后续
The trophy would not fit in the suitcase
because it was too big.
在相同设置下,A用时12秒,B用时8秒。未测量内存。
方案 / 数值times = {'A': 12, 'B': 8}
faster = min(times, key=times.get)
三种材料都能采用合法前缀预测后续。关系句含有物体、容器和原因;A/B记录含有方案、数值和未测项;代码把A、B映射到耗时,再用min选择对应的键。目标形式相同,预测时必须利用的具体依赖并不相同。
三类输入为教学材料;库存、混合权重与重复口径对应GPT-3 Table2.2。
三类教学材料:合法前缀 → 实际后续
The trophy would not fit in the suitcase
because it was too big.
在相同设置下,A用时12秒,B用时8秒。未测量内存。
方案 / 数值times = {'A': 12, 'B': 8}
faster = min(times, key=times.get)
关系句要把原因连到对象,实验记录要把十二和八分别连回A和B,代码还要让变量、字典键与函数调用配合。材料决定训练反复向模型提出哪些要求,但“材料里有代码”不等于“模型已经会编程”。训练能否把这些规律变成可用本领,需要下一步的独立任务评价。
代码是教学输入,未将这里的代码或答案伪称为模型生成。min(times, key=times.get)按字典值选择最小耗时对应的键,本例为B。
三类输入为教学材料;库存、混合权重与重复口径对应GPT-3 Table2.2。
三类教学材料:合法前缀 → 实际后续
The trophy would not fit in the suitcase
because it was too big.
在相同设置下,A用时12秒,B用时8秒。未测量内存。
方案 / 数值times = {'A': 12, 'B': 8}
faster = min(times, key=times.get)
再看文档编号组成的训练流。库存里有一、二、三号文档,实际训练却按抽样顺序读了一、二、一、三、一、二。同一文档被读三次,就产生三次训练消费;没被抽到的材料只是库存。筛选、抽样和重复一起改变训练经历。现在先问这些经历能否帮助新任务,稍后再把实际消费放进计算预算。
GPT-3原表同时报告数据集规模、混合权重与近似epoch;权重经过四舍五入,不能为使总和恰为100%擅改各项。完整五行表保留在本页阅读正文。
三类输入为教学材料;库存、混合权重与重复口径对应GPT-3 Table2.2。
| 材料 | 预测可能需要的依赖 |
|---|---|
| 奖杯/手提箱关系句 | 物体、容器、原因条件 |
| A/B实验记录 | 方案、数值、未测范围 |
| 字典与min调用代码 | 变量、键值对应、函数语义 |
库存①②③与训练流①②①③①②不同:前者有三份独特文档,后者发生六次读取。这只是说明计数身份,不是模型能力或泛化测量。
相同的下一项预测目标可以面对物体关系、记录字段或代码操作等不同内容。材料选择改变反复要求模型处理的规律,但不能仅凭材料类别宣布能力已经获得。库存是可用语料;过滤、去重、抽样比例和重复决定实际训练消费。GPT-3训练300B tokens的语料表区分库存、混合权重与近似epoch,原论文四舍五入后的权重合计不强改为100%。
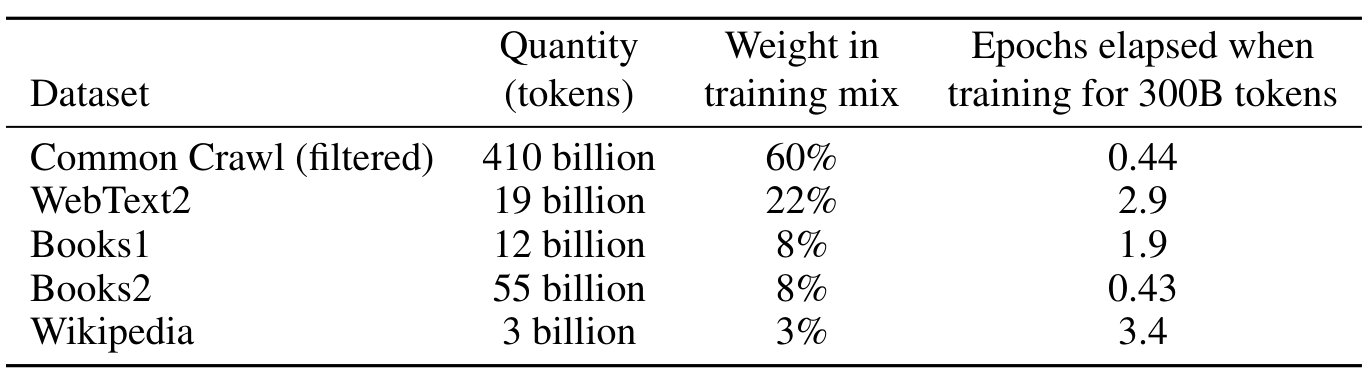
完整数据配比解释 · Goodfire五步局部表示观察。后者是InceptionV1案例,不是LLM能力证明。
保留关系句、A/B记录和代码实例,逐一解释它们的依赖,再看库存到实际训练消费的路径。
对照完整Table2.2的语料规模、混合权重和近似epoch,分开“有多少独特材料”和“实际读过多少”。
区分材料库存、不同 token 和实际训练消费量,检查固定预算下材料提出的依赖。
打开本册后,找到同名小节。
自然语言推断判断一条假设与给定前提的关系:受到支持、与前提冲突,或信息不足。A/B例子只用于解释这三类关系。真实证据来自GPT-1 Table5的MNLI消融:完整方案81.8,无预训练方案75.7,相差6.1个百分点;两条路线均使用下游监督,完整方案含辅助语言模型目标并额外使用预训练资源。
先用熟悉的A/B前提读懂任务:十二和八支持“B在本次测试中耗时更短”,与“A更快”冲突;没有测内存,则“B内存更少”既未得到支持,也未被否定。这三种关系叫蕴含、矛盾、中立,合称自然语言推断,简称NLI。左边三句是课堂构造,用来理解任务,不是论文MNLI数据集中的原题。
A/B句对为教学构造,用于解释NLI三关系;不是MNLI原题。
现在把证据换成真实MNLI评价。它在不同体裁的前提与假设句对上判断同样三类关系。上路先用普通文本做语言模型预训练,再用带标签的MNLI数据更新参数;下路省去预训练,直接从下游监督训练开始。两路的终点都是MNLI分类评价,这次比较的是训练经历是否带来可迁移收益。
MNLI为跨体裁自然语言推断任务。此处早期GPT使用下游监督微调及任务输入转换,不应与后面仅前向的ICL或生成式指令SFT混为同一接口。
GPT-1 §3.2–3.3、§4.2与Table5:有/无预训练的下游监督路线。
GPT-1 Table5的同一MNLI列,完整方案是百分之八十一点八,去掉预训练是百分之七十五点七,差六点一个百分点。准确率表示许多句对中关系标签判断正确的比例。这些是原论文实验结果,不是左边三道A/B题的得分,也不是本课现场重跑。结果支持指定条件下普通文本预训练对下游任务有帮助。
GPT-1 Table5:Transformer w/ aux LM (full)=81.8;Transformer w/o pre-training=75.7;Transformer w/o aux LM=81.1。这里只主读前两项,不与Table2的MNLI-m/mm 82.1/81.4混用。
GPT-1 Table5 MNLI原实验:full 81.8、无预训练75.7;差6.1个百分点。
把两条路线的条件也一起读:两路都有下游标签,完整方案还加入辅助语言模型目标,而且多用了预训练材料和计算。因此它不是不改参数的纯提示实验,也不是等总预算比较。到这里我们看的是训练后继续更新参数的迁移。接下来把优化器暂时拿开,只给当前输入加一个示例,看看可以改变什么。
“full + aux LM”中的aux LM是辅助语言模型目标,指下游训练同时保留语言建模辅助项;不能将它改写成另一个没有原文依据的新训练阶段。
GPT-1 Table5条件:两路有下游监督,full含aux LM;额外预训练数据与计算,非等总预算。
| 材料层 | 比较内容 | 可以回答的问题 |
|---|---|---|
| A/B教学例 | B更快/A更快/B内存更少 | 蕴含、矛盾、中立分别是什么意思 |
| GPT-1 Table5原实验 | full 81.8;w/o pre-training 75.7 | 指定训练配置下预训练是否有迁移收益 |
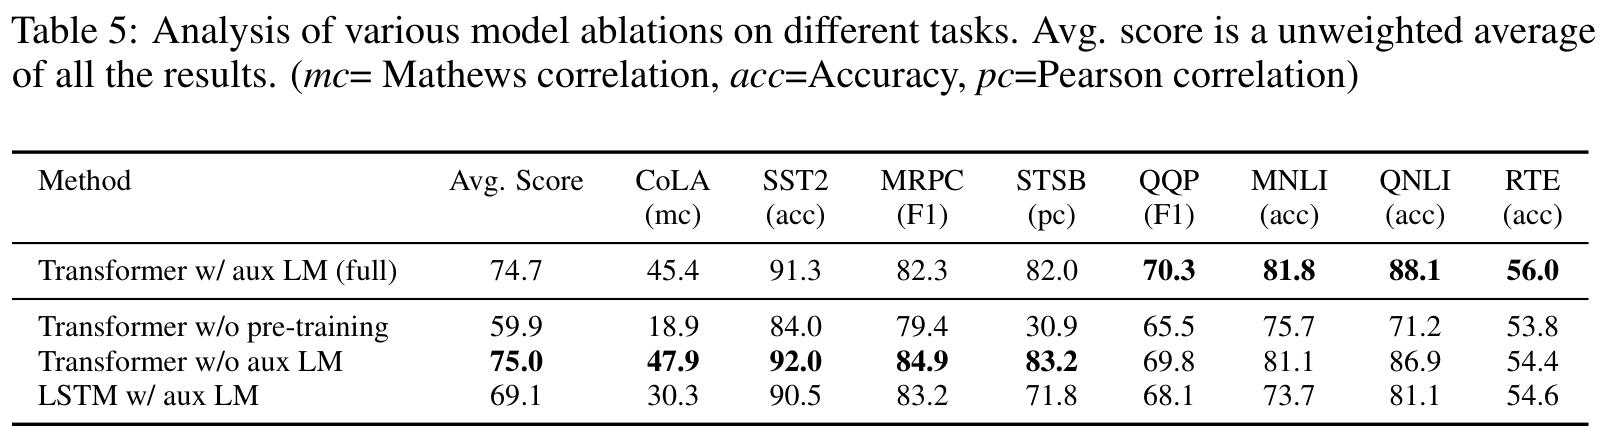
6.1是准确率的百分点差,不是相对增长率。原表和A/B构造例承担不同职责,不能把整页都标为教学模拟。
NLI判断前提与假设之间的关系:蕴含是被前提支持,矛盾是与前提冲突,中立是信息不足。本例A/B三句是教学构造,并非MNLI原题。未测内存不能推出B更省,也不能推出A更省或两者相等。MNLI是真实跨体裁的自然语言推断数据集,准确率是在许多句对上选对标签的比例。
GPT-1 Table5的MNLI列:Transformer w/ aux LM (full)为81.8,Transformer w/o pre-training为75.7,差6.1个百分点。两条路线都有下游监督学习;full还包含辅助语言模型目标,w/o aux LM一行为81.1。本例比较预训练消融,不是纯提示zero-shot,也不是相同总训练预算,不与Table2的MNLI-m/mm 82.1/81.4混用。
三句假设共用12/8秒及未测内存的前提;重点解释未知为何既不是支持,也不是反对。
直接查看Table5,核对81.8/75.7、辅助LM目标及下游监督,分清预训练迁移、纯提示和等预算比较。
进一步解释预训练参数、下游输入转换和监督训练的关系,保留完整迁移比较。
分别阅读 GPT-1 原表和课堂轻量模型结果,说明它们各自支持怎样的迁移判断。
上下文学习把任务示例放进当前输入。C/D示例示范“先给本次耗时结论,再保留未测项”的回应方式;A/B的12/8秒与未测内存仍是当前事实来源。该输入对照没有反向传播或优化器更新,图中回应是教师参考,不构成示例改善效果的实测。
请只根据材料,用一句话概括结果,并保留尚不能判断的部分。
在相同设置下,A用时12秒,B用时8秒。未测量内存。
回答:
请只根据材料,用一句话概括结果,并保留尚不能判断的部分。
同一条件下,C耗时10秒、D耗时7秒;未测能耗。
D在本次测试中耗时更短;能耗尚未比较。
在相同设置下,A用时12秒,B用时8秒。未测量内存。
回答:
保留同一A/B请求:比较十二与八,并保留未测内存。我们只改变输入是否带有示例,训练参数固定。
本态没有提供模型输出。比较输入条件时,不应先编一个“无示例答错”的结果,把构造场景变成收益证据。
A/B与C/D提示及回应为教学构造;示例条件概念对应GPT-3 §2。
请只根据材料,用一句话概括结果,并保留尚不能判断的部分。
在相同设置下,A用时12秒,B用时8秒。未测量内存。
回答:
请只根据材料,用一句话概括结果,并保留尚不能判断的部分。
同一条件下,C耗时10秒、D耗时7秒;未测能耗。
D在本次测试中耗时更短;能耗尚未比较。
在相同设置下,A用时12秒,B用时8秒。未测量内存。
回答:
右边加入C/D示例:先比较耗时,再保留未测能耗。它示范回应的组织方式;当前事实仍是A/B,不能把D、七秒或能耗抄进回答。
C/D示例提供的是如何把已知与未知一起组织成回答;C/D的耗时与未测能耗不能作为A/B的新事实。
A/B与C/D提示及回应为教学构造;示例条件概念对应GPT-3 §2。
请只根据材料,用一句话概括结果,并保留尚不能判断的部分。
在相同设置下,A用时12秒,B用时8秒。未测量内存。
教师参考
B在本次测试中耗时更短;内存尚未比较。
请只根据材料,用一句话概括结果,并保留尚不能判断的部分。
同一条件下,C耗时10秒、D耗时7秒;未测能耗。
D在本次测试中耗时更短;能耗尚未比较。
在相同设置下,A用时12秒,B用时8秒。未测量内存。
教师参考
B在本次测试中耗时更短;内存尚未比较。
两边的教师参考都应是“B在本次测试中耗时更短;内存尚未比较”。这是参考答案,没有模型实测胜负。参数未变,示例怎样影响本次回答?
图中两个参考回答相同,是因为同一A/B任务的正确参考相同;不是两次模型运行恰好得到相同输出。zero/one-shot描述本次提示中的示例条件,不代表模型此前从未训练过相关任务。
A/B与C/D提示及回应为教学构造;示例条件概念对应GPT-3 §2。
| 项目 | 示例材料 | 当前材料 |
|---|---|---|
| 对象与用时 | C 10秒;D 7秒 | A 12秒;B 8秒 |
| 未测项 | 能耗 | 内存 |
| 可借用的东西 | “本次结果;未知事项”的回应方式 | 当前回答必须依据本列事实 |
上下文学习改变本次输入,不自动写入参数。示例是否改善任务表现,需要实际评价。
下面暂时离开当前AB/CD记录,回看原N33保留的翻译构造例:它同样比较“不给示例”和“先给一个示例”的输入形式,并非本页AB任务的运行结果。zero-shot与one-shot描述本次输入中给多少任务示例,不是新架构。在这个翻译例内部,两种提示都问cheese,one-shot另给sea otter/loutre de mer成对例子。fromage只作教师参考,没有真实模型运行或左错右对比较。本例按GPT-3的示例形式重新排版,不是WMT正式评测提示的逐字复刻。
提示先用C/D、10/7秒与未测能耗示范“结果;尚不能判断的事项”,再给A/B、12/8秒与未测内存。示例提供格式和边界,当前材料提供事实;二者不能串用数字。教师参考仍需重新读取当前记录。没有执行真实推理时,预期回答与核对方法不应写成实测效果。
对照C/D示例与A/B当前材料,逐项核对对象、数字、未测项和回应格式,防止把示例事实抄给当前问题。
用zero-shot与one-shot完整提示说明示例数量的含义,保留cheese/sea otter教学输入与教师参考。
把输入变化接到X、K/V与前向计算,解释示例影响回答的入口。
核对固定 checkpoint、输入和已保存输出。24 条真实 pilot、独立 6 条诊断与 192 条合成 fixture 分开。
打开本册后,找到同名小节。
在某一层,输入表示X经过训练得到的投影Wₖ和Wᵥ,生成本次K=XWₖ与V=XWᵥ。在当前问题前插入C/D示例,会增加输入位置,并改变后续位置的上下文表示。相同权重仍可产生不同状态和输出分布;这是前向计算,不需要本次优化器更新。
请根据材料概括结果,并保留未知。
A12秒 / B8秒;未测内存。
请根据材料概括结果,并保留未知。
C10秒 / D7秒,未测能耗。
示例答:D更快;能耗未知。
A12秒 / B8秒;未测内存。
两份输入使用同一组W。加了前置示例,当前层的表示由X₀变为X₁;X是一排表示向量,不是参数。
第一层X来自token与位置等输入表示;后层X已经包含之前层处理的上下文。这里的0/1是两份输入条件的编号,不是时间步或模型版本。
A/B与C/D为教学输入;固定参数仅前向的few-shot设置对应GPT-3 §2。
请根据材料概括结果,并保留未知。
A12秒 / B8秒;未测内存。
请根据材料概括结果,并保留未知。
C10秒 / D7秒,未测能耗。
示例答:D更快;能耗未知。
A12秒 / B8秒;未测内存。
沿相同投影计算K=XWₖ、V=XWᵥ。W没变,X不同,K/V就可以不同。前置示例成为后续位置可读取的内容。
前置示例参与模型计算并改变条件;它不是绕过当前任务直接复制答案的通道。
A/B与C/D为教学输入;固定参数仅前向的few-shot设置对应GPT-3 §2。
请根据材料概括结果,并保留未知。
A12秒 / B8秒;未测内存。
请根据材料概括结果,并保留未知。
C10秒 / D7秒,未测能耗。
示例答:D更快;能耗未知。
A12秒 / B8秒;未测内存。
当前Q读取合法前缀K/V,经后续计算形成词表分布。这里只有前向,没有优化器更新。机制说明了影响的入口;影响是否有益,还需要独立评价。
普通ICL只有前向计算。某些研究会把特定情形下的内部计算与学习算法类比,但本图本身不证明一般ICL必然实现梯度下降。
A/B与C/D为教学输入;固定参数仅前向的few-shot设置对应GPT-3 §2。
| 跨两种输入保持不变 | 随当前输入改变 |
|---|---|
| 训练权重WQ、WK、WV | 输入位置及各层表示X |
| 参数化的计算规则 | 本次K/V与可能不同的输出分布 |
在某层,K=XWₖ、V=XWᵥ。用同一矩阵处理不同输入可产生不同结果;这不要求执行一次参数更新。
在某层,固定投影权重与不同层输入产生不同的当前K/V:$K=XW_K$,$V=XW_V$。第一层X来自token和位置表示,后层X是上下文化后的层输入。本例从当前问题前插入示例,后续位置及条件改变;不要推广为纯因果模型追加token后所有旧位置都会变化。普通ICL只作前向,不执行优化器更新,也不等价于宣称内部算法必然是梯度下降。
说明第一层与后层X的身份、K/V投影及当前查询的合法读取范围,区分插入示例与末尾追加。
从机制解释转向GPT-3固定参数的zero/one/few-shot比较,区分可能影响与实际有效。
比较参数不变时的内容变化;将关联记忆构造与固定真实模型的记录分开。
打开本册后,找到同名小节。
GPT-3 Table3.4报告同一175B模型在WMT’14英语到法语任务上的BLEU:zero-shot 25.2、one-shot 28.3、few-shot 32.6。评测仅前向、不更新模型参数。few-shot采用K=64的设置并受2048上下文窗口限制。该结果是指定翻译任务的证据,与A/B课堂构造例分开。
换看真实完整句翻译:GPT-3的175B模型,WMT英语到法语。BLEU衡量译文与参考译文的匹配,不是正确率;这也不是刚才的A/B实验。
原文为GPT-3 Table3.4,175B模型,WMT’14 English→French;采用multi-bleu.perl口径。完整六方向原表保留在阅读正文。
GPT-3 Table3.4原始翻译评测:175B、WMT’14 En→Fr、BLEU;固定参数仅前向。
同一模型固定参数:零例25.2,一例28.3,少样例32.6,提升7.4分。少样例上限K=64,还受2048 token窗口限制。
论文§3.3与Appendix H给出1/64个成对示例等设置;K=64与有限上下文窗口须一起解释,不能把它改成任意长度的64句保证。
K=64是论文少样例设置,受上下文窗口约束;不能解释为每个请求保证装入64个任意长度的句对。
GPT-3 Table3.4原始翻译评测:175B、WMT’14 En→Fr、BLEU;固定参数仅前向。
证据支持这个任务与配置中的收益,不能推广成示例越多越好。若希望每次不附示例也能按要求回应,可以进一步训练参数。
这个评价把机制可能性推进为指定配置下的收益证据。示例选择、上下文占用和执行成本仍需分别评价。
GPT-3 Table3.4原始翻译评测:175B、WMT’14 En→Fr、BLEU;固定参数仅前向。
| 示例条件 | BLEU |
|---|---|
| Zero-shot | 25.2 |
| One-shot | 28.3 |
| Few-shot,K=64设置 | 32.6 |
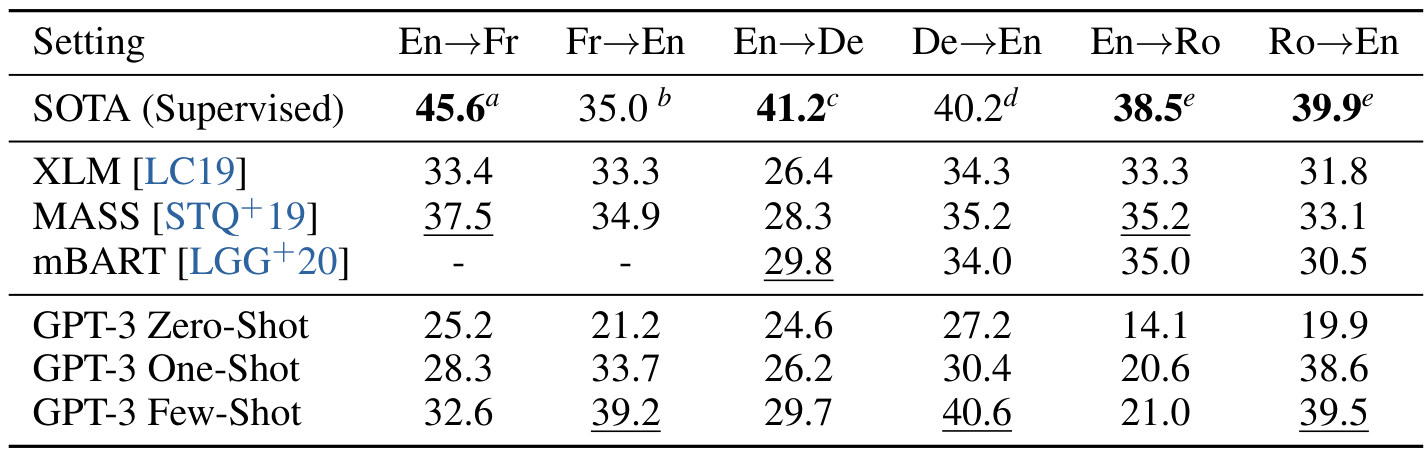
这些数值来自真实论文评价,BLEU不是准确率。本课未重跑模型,也未将此结果改写成A/B任务效果。
这里仅采用GPT-3 Table3.4的175B模型在WMT’14 English→French方向的BLEU:zero-shot25.2、one-shot28.3、few-shot32.6,采用multi-bleu.perl口径。论文设置K=64,并受2048上下文窗口约束,不假定每条输入完整装下64个长句。BLEU不是准确率,7.4分差不能写作准确率提高7.4%。
结果仅支持指定模型、任务、示例与预算条件,不能推广为示例越多越好或超越全部监督模型。
查看同一翻译方向的三根柱和原始六方向表,解释BLEU单位、K=64设置及窗口限制。
回到A/B任务,比较文档接续和期望回应,再把它们组织为监督微调样本。
重算已有记录,检查分母和对照条件;D−C 不能单独代表示例的因果效应。
生成式指令SFT以请求、材料和期望回应组成监督样本,从已有预训练参数继续训练。通顺续文与完成任务的回应都可以通过逐token预测产生,差别在于当前条件下反复训练的期望行为。instruction、input、response表示职责;实际输入仍按模型模板连接为一条带角色边界的序列。
下一节将介绍实验装置与测量流程。
教学构造的接续B在本次测试中耗时更短,内存尚未比较。
教学构造的期望回应撤去C/D示例,仍要求根据A/B材料用一句话回答,并保留未知。现在检查后续有没有完成请求。
“文字通顺”与“完成用户请求”是两个判断。仍使用相同A/B事实,只改变我们希望训练出的回应行为。
A/B请求与两种后续为教学构造;示范监督训练对应InstructGPT §3.1。
下一节将介绍实验装置与测量流程。
教学构造的接续B在本次测试中耗时更短,内存尚未比较。
教学构造的期望回应“下一节介绍实验装置”虽通顺,却没回答。期望回应同时满足比较、范围、未知与形式四项要求。两种后续是教学构造,不是模型实测。
期望回应逐项对应:8小于12、限定本次测试、保留未测内存、符合一句话要求。四项是可检查职责,并非实测增益。
A/B请求与两种后续为教学构造;示范监督训练对应InstructGPT §3.1。
请只根据材料,用一句话概括结果,并保留尚不能判断的部分。
在相同设置下,A用时12秒,B用时8秒。未测量内存。
B在本次测试中耗时更短,内存尚未比较。
教学角色标记;prompt 包含指令、材料和回应边界
随后:正确回应前缀 → 后续目标,直到 EOS
把请求、材料、期望回应分别记为instruction、input、response,用这类示范继续训练已有参数,就是监督微调SFT。目标仍是预测后续回应。
这里是生成式指令SFT:继续以token预测目标训练。它和GPT-1 MNLI页的判别任务微调共享“从预训练参数继续训练”的思想,但输出接口不同。SFT也不等于全部后训练。
A/B请求与两种后续为教学构造;示范监督训练对应InstructGPT §3.1。
请只根据材料,用一句话概括结果,并保留尚不能判断的部分。
在相同设置下,A用时12秒,B用时8秒。未测量内存。
B在本次测试中耗时更短,内存尚未比较。
教学角色标记;prompt 包含指令、材料和回应边界
随后:正确回应前缀 → 后续目标,直到 EOS
三部分连成序列:prompt含指令、材料和回应边界,之后是正确回应。角色标记是教学占位。下一页检查首回应B在哪里预测、在哪里计分。
instruction/input/response只是职责划分;〈user〉、〈assistant〉和当前切分为教学占位,不宣称适用于所有模型的精确chat template。
完整训练回应虽已知,每个预测位置仍只读合法前缀。该因果规则在下一页与目标是否计分的规则分开。
A/B请求与两种后续为教学构造;示范监督训练对应InstructGPT §3.1。
| 样本职责 | 本例内容 |
|---|---|
| Instruction | 只根据材料,用一句话概括结果并保留未知 |
| Input | A 12秒、B 8秒;未测内存 |
| Response | B在本次测试中耗时更短;内存尚未比较 |
三部分经模型适用的角色模板连成序列。SFT继续更新预训练参数;“通顺但未完成任务”的构造对照不是实际模型失败记录。
基础语言建模与任务回应共享预测后续token的接口。两种后续都是人为构造,不能把文档接续当作某基础模型的真实失败,也不说明基础模型绝不可能完成请求。任务化示范反复展示输入材料、请求和期望回应,SFT只是后训练的一部分;FLAN的任务指令化、InstructGPT的示范和偏好训练各有不同证据,不能把RLHF最终收益归因于单独SFT。
instruction、input、response是本例为说明职责而列出的字段。工程中需采用模型对应的chat template,处理角色、分隔与结束标记。本例的标记只是教学占位。训练时以正确回应前缀预测后续,这是teacher forcing。此处是生成式指令SFT,与N32早期GPT判别任务使用分类头的微调不可混成同一输出接口。
保留同一A/B请求并对照两种构造后续,核对数值、本次范围、未测项和形式要求。
展示instruction/input/response到一条训练序列的转换,说明角色边界、teacher forcing和教学模板身份。
区分示范监督、偏好比较与其他训练目标;SFT是其中一种,不把其他阶段收益统归SFT。
分别指出可读取的输入和计分位置:只给回应计分,不等于看不到用户输入。
预测首回应B时,合法前缀是完整prompt;预测后续“在”时,训练使用prompt加正确B作为前缀,这叫teacher forcing。本例采用response-only loss:回应目标计分,prompt目标不直接计分。因果mask控制读取范围,loss mask控制计分目标;prompt仍参与前向计算并影响回应损失的梯度。
预测首回应B,前缀是完整prompt;预测“在”,前缀再加正确的B。训练用正确回应前缀,称为teacher forcing;推理接自己的生成继续。
Teacher forcing使用真实的历史回应token;自回归推理则使用自己此前生成的token。两者都保持前缀预测后续,不能据此取消因果约束。
A/B response-only SFT为明确指定的教学实现;一般示范监督训练对应InstructGPT §3.1。
本例只给回应目标计分。B由prompt末位置的输出预测,但B属于回应,权重仍是一。loss mask要跟目标走,不能漏掉首回应。
概念性移位写法:shifted_logits=logits[:-1],shifted_labels=labels[1:]。应按移位后的目标选择mask:B至EOS权重1,prompt目标权重0。实现中的张量维度和框架接口可能不同,关键是对齐同一预测与目标。
A/B response-only SFT为明确指定的教学实现;一般示范监督训练对应InstructGPT §3.1。
左边因果mask管可读取谁;右边loss mask管哪些目标计分:prompt目标零,B至EOS一。零不删除prompt,它仍参与前向计算。
prompt目标的loss权重为0,仅表示这些目标没有直接贡献该项损失。prompt仍参与形成回应所需的表示,包含12、8与未测内存等条件。
A/B response-only SFT为明确指定的教学实现;一般示范监督训练对应InstructGPT §3.1。
回应概率产生loss,梯度沿共享计算回传,优化器把θ更新为θ′。输入文字不变,相关参数可以更新。response-only是本课选择,并非所有SFT唯一做法。
“输入文字不变”与“输入表示相关参数可训练”并不冲突。token身份不被优化器改写,embedding及其他未冻结参数仍可能通过回应损失获得梯度。
A/B response-only SFT为明确指定的教学实现;一般示范监督训练对应InstructGPT §3.1。
| 控制项 | 问的问题 | 本例作用 |
|---|---|---|
| causal mask | 当前预测能读谁? | 允许合法前缀,禁止未来输入 |
| loss mask | 哪些目标进入损失? | prompt目标0;回应B至EOS目标1 |
首回应B由prompt末位置的logits预测,因此其目标权重为1。完整prompt→B、prompt+正确B→在,是两个连续的teacher-forcing前缀—目标对。
instruction、input、response是本例为说明职责而列出的字段。工程中需采用模型对应的chat template,处理角色、分隔与结束标记。本例的标记只是教学占位。训练时以正确回应前缀预测后续,这是teacher forcing。此处是生成式指令SFT,与N32早期GPT判别任务使用分类头的微调不可混成同一输出接口。
本例明确采用response-only loss。loss mask对应被预测目标而不是直觉上的输入格:首回应B由最后一个prompt位置的logits预测,所以移位后该位置的标签B必须计分。若labels=[prompt₁,…,promptₘ,B,…,EOS],shifted_logits=logits[:-1],shifted_labels=labels[1:];prompt目标权重0,B至EOS目标权重1。直接损失为0不代表prompt不参与attention、不前向计算或其路径梯度为零。causal mask限制可读取位置;loss mask选择计分目标,两者职责不同。
沿prompt末位置的logits到目标B核对移位,保留回应目标权重1以及完整索引解释。
通过前向依赖与回应损失的反向路径,区分目标权重0、输入删除和梯度为0。
从完整prompt→B、prompt+B→在两对前缀和目标,解释训练与自回归推理的不同。
分别指出可读取的输入和计分位置:只给回应计分,不等于看不到用户输入。
新的独立教学记录把耗时改为A 7秒、B 11秒,未测内存与请求形式保持不变。正确参考因此变为A在本次测试中更快,内存仍不能比较。参数是否经过SFT与当前输入是否含示例是两个可以独立控制的条件;四格评价设计用于区分两者作用,尚不代表任何实测胜负。
新记录改为A七秒、B十一秒,其他要求不变。我们要保留依据材料比较的行为,不是旧答案“B更快”。
7/11为与原12/8对照的独立教学材料,未声称真实模型已经在该样例上出现错误或成功。
7/11记录、教师参考与2×2评价均为教学设计;未填入未运行的模型结果。
旧答案:B耗时更短…
不符合新证据;非模型实测错误
教师参考:A在本次测试中耗时更短,内存尚未比较。
教师参考因此改为“A在本次测试中耗时更短;内存尚未比较”。新事实来自当前输入,不必每次先训练进参数;模型能否做到,仍须检验。
教师参考只说明新材料下正确回应应是什么,不代表模型已经实测答对。要检验稳定性,需要多个独立材料,而非只换一次数字。
7/11记录、教师参考与2×2评价均为教学设计;未填入未运行的模型结果。
| 待评价条件 | 无示例 | 同一正确格式示例 |
|---|---|---|
| 预训练参数 θ | 需用独立样例实际评价 | 需用独立样例实际评价 |
| SFT后参数 θ′ | 需用独立样例实际评价 | 需用独立样例实际评价 |
评价指标:事实对应、未测边界、任务与格式符合。
表的两行比较预训练与SFT参数,两列比较无例与有例输入:SFT和ICL可以组合。用独立材料核对事实、范围、任务和形式;空表尚无实测胜负。接下来考虑训练资源怎样分配。
当前四格是评价设计,未实际执行。SFT训练样本与评价样本须分开,改变数字只是必要检查之一;更完整的评价还需覆盖对象、未测项、任务形式及分布变化。
7/11记录、教师参考与2×2评价均为教学设计;未填入未运行的模型结果。
| 当前记录 | 耗时判断 | 内存判断 |
|---|---|---|
| A 12秒/B 8秒 | B在本次测试更快 | 未测,不能比较 |
| A 7秒/B 11秒 | A在本次测试更快 | 未测,不能比较 |
| 参数条件 | 当前无示例 | 当前有示例 |
|---|---|---|
| 预训练参数θ | 待独立评价 | 待独立评价 |
| SFT后参数θ′ | 待独立评价 | 待独立评价 |
四格设计让参数变化与输入变化分别接受检验;没有填写模型胜负。
把事实反转成A7秒/B11秒,仍保留未测内存,检查是否重新依据材料回应。教师参考A更快,不是已运行后的测量。可以将预训练参数/SFT参数与无示例/同格式示例构成2×2独立评价,检查事实对应、证据范围、任务及格式;四种组合均需独立评价,目前没有实测优劣结论。
SFT之后仍可做ICL,示范目标与偏好目标不同。继续阅读:奖励模型、RLHF/PPO、DPO、可验证反馈、LoRA、QLoRA。后训练正文和适配正文保留完整机制。LoRA冻结原权重、训练低秩增量;QLoRA中的低位保存、反量化与计算精度是不同对象。
对照12/8和7/11记录,核对事实、范围、未知与形式;再用预训练/SFT×无示例/有示例组织独立评价。
以模型参数量与实际训练token消费建立预算近似,继续回答获得能力需要怎样分配资源。
解释冻结权重、训练低秩增量与低位保存的不同对象,供需要深入训练实现时继续阅读。
区分修改权重与修改上下文,分别核对已有记录和能够支持的结论。
打开本册后,找到同名小节。
打开本册后,找到同名小节。
在固定主要算术预算 C 下,近似关系 C≈6ND 把参数数量 N 与实际训练消费 D 联系起来。N 翻倍、D 减半保持近似预算,却不保证效果相同。库存、重复消费、算术量、墙钟时间和费用必须分别计量。
刚才我们区分了更新参数与改变当前输入。若决定训练,先看投入怎样分配。N 是参数数量,D 是实际消费的训练 token 数;同一段材料读三遍,要计三遍。更大的模型通常使每个 token 的计算更贵,在总预算固定时,就不能同时任意增加训练量。
课堂预算构造;C≈6ND 为稠密 Transformer 主要算术近似,参考 Chinchilla §3.3
对这里讨论的常见稠密 Transformer,用 C 约等于六 ND 估算主要前向与反向算术量。六概括这一计算口径,N 与 D 分别对应模型和训练流。它不是训练耗时或价格公式;长序列、架构与具体执行还会引入其他成本。
C≈6ND 是常见稠密模型的主要算术近似。不能把 MoE 的总参数不加区分代入,也不能将它当作同设备墙钟时间或货币成本。
课堂预算构造;C≈6ND 为稠密 Transformer 主要算术近似,参考 Chinchilla §3.3
把 C 锁住:如果 N 翻倍,D 就约减半。式子建立了可比较的配置,却没有给出性能胜负。小模型多读一点、大模型少读一点,哪种在这笔预算内更有效?下一页在真实的固定预算实验中比较训练损失。
保留的教学配置 4B/400B 与 8B/200B 均为 9.6×10²¹ FLOPs;它们不是下一页 3×10²⁰ FLOPs 曲线上的实验点。
课堂预算构造;C≈6ND 为稠密 Transformer 主要算术近似,参考 Chinchilla §3.3
以下从计算对象、条件与原始证据继续展开。
N 是参数数量,D 是训练实际消费的 token 数,C 是主要训练算术量。重复读同一材料会重复计入 D;独特内容库存不是 D。对常见稠密 Transformer,$C\approx6ND$ 概括主要前向与反向计算,长上下文、架构及实现会增加修正项。它不直接给出墙钟时间或货币成本,也不能把 MoE 总参数未经区分代入。
同一原始配置下,N 与 D 各翻倍得到约 4C;先恢复原始配置后再固定 C,N 翻倍才对应 D 减半。这个算式只生成可比较的配置,不决定哪种配置更好。
完整预算口径、Kaplan 两种横轴及生命周期成本;原预算算例。
原 N42 材料两张教学配置卡使用十进制 B(十亿):$6(4\times10^9)(400\times10^9)=6(8\times10^9)(200\times10^9)=9.6\times10^{21}$ FLOPs。它们没有在本课程实际训练,也没有测得比较成绩。
随后采用 Chinchilla v1 Figure 3 物理 p.6 的真实实验,先选择性呈现 $3\times10^{20}$ FLOPs 预算曲线并保留原坐标、实验点和虚线拟合。该预算与构造卡不同,构造卡不是曲线上的数据点。横轴参数用对数刻度,纵轴是训练损失;沿同一预算线改变 N 时,对应训练消费 D 也在改变。论文为不同训练长度匹配学习率日程,不能把一次训练的中途 loss 截点当作同一类实验。
Chinchilla 原文 §3.2 / Figure 3;完整原图及说明。
复算 4B/400B 与 8B/200B 的相同 6ND,并与同时翻倍得到 4C 区分。
区分教学配置卡与论文固定预算线,读懂点、拟合和训练日程的身份。
Chinchilla Figure 3 比较固定主要计算量下不同参数规模和训练消费的组合。单预算线两侧损失高于谷底附近,提示容量与受训程度需要共同配置;恢复多预算线后,必须区分分配变化与总投入变化。后续 8B 仅为显存教学配置。
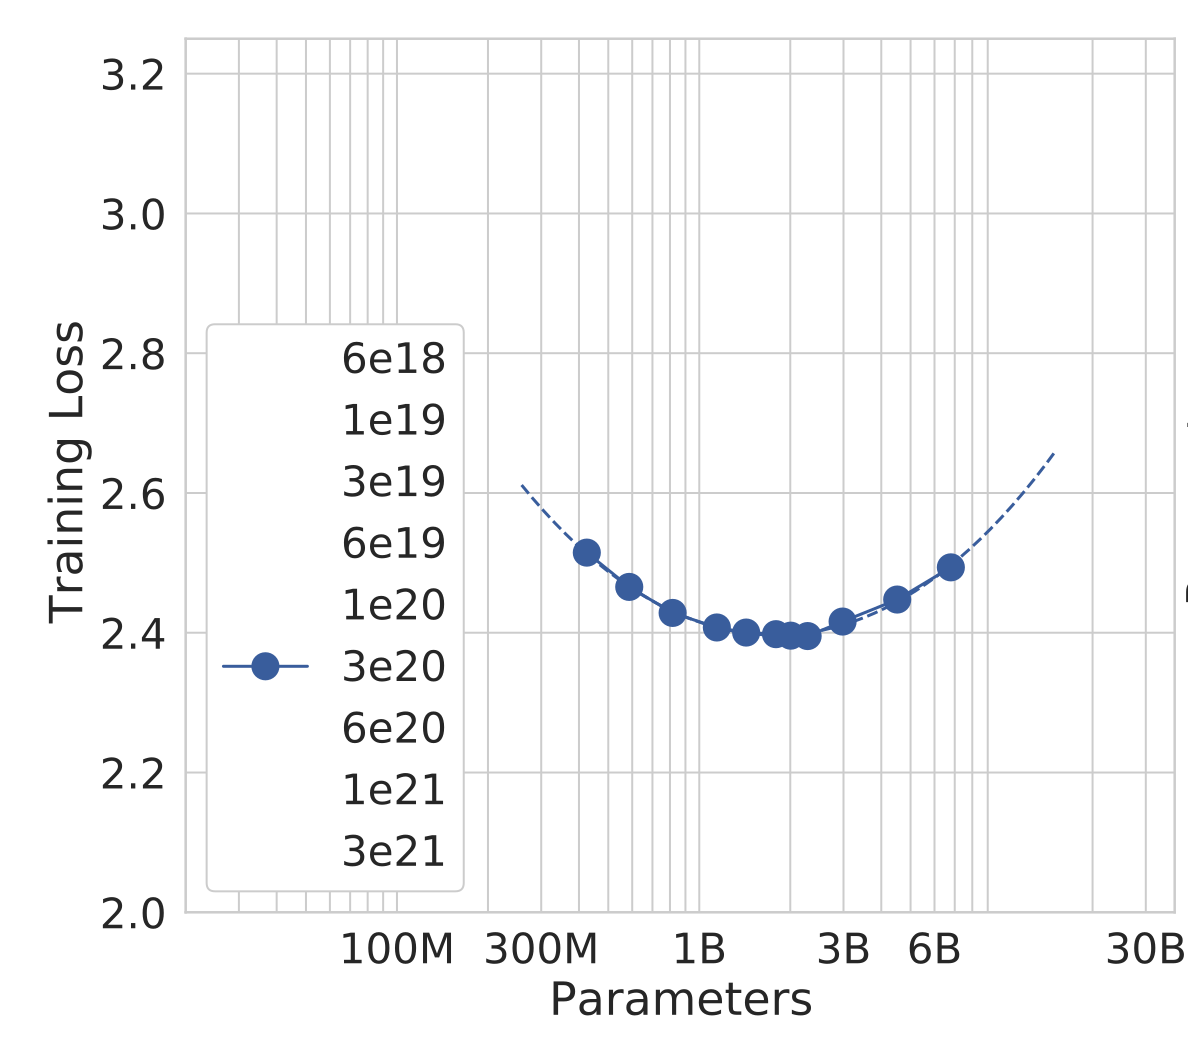
这是 Chinchilla 的真实训练实验。横轴是参数 N,采用对数刻度;纵轴是平滑训练损失,越低越好。先只看三乘十的二十次方 FLOPs 这条预算线:圆点来自实验,虚线是拟合。沿线向右增大模型时,训练消费 D 随之减少,不是只改变参数数量。
保留 Chinchilla v1 Figure 3 的原坐标、实验点和虚线拟合;选择性呈现来自同一原图,不从像素拟造精确最优 N。
Chinchilla v1 Fig.3 / Appendix F;课堂预算构造与论文实验分开
左侧模型小,每个 token 较便宜,所以同一预算能支持更多训练消费。可是图上的损失仍高于谷底附近:反复训练无法无限补偿容量与表示能力的限制。这是对这一组曲线的解释,不能推广成所有小模型的固定命运。
Chinchilla v1 Fig.3 / Appendix F;课堂预算构造与论文实验分开
先对照谷底,再看右侧。谷底附近的配置取得较低损失;继续增大模型时,可训练的 token 更少,模型可能尚未充分受训就耗尽预算。因此问题是共同选择 N 和 D,不是单独把模型或训练量做到最大。
Chinchilla v1 Fig.3 / Appendix F;课堂预算构造与论文实验分开
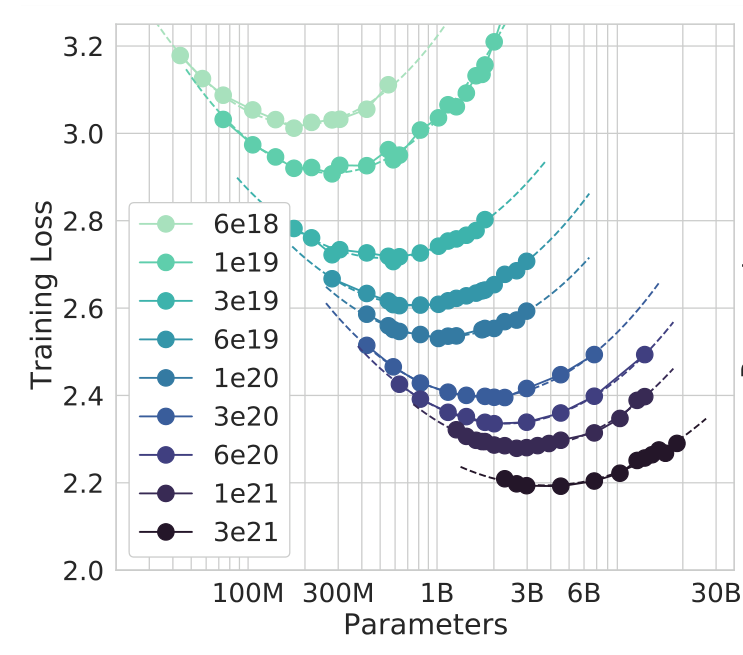
恢复其他预算线以后,比较有了两个方向:沿同一条线移动是在分配同一笔投入;换到另一条线才是改变总投入。谷底随条件移动,给出的是这组数据、目标和训练日程下的经验规律。训练损失仍需与实际任务表现分开评价。
沿线比较与跨线比较是两种实验问题。多预算曲线不能证明参数越多就越好,也不能将训练损失直接换算为用户满意度。
Chinchilla v1 Fig.3 / Appendix F;课堂预算构造与论文实验分开
接下来选八十亿参数作为统一的显存算例。它只是便于逐项记账的配置,不是从图中读出的最优点。参数规模定下来以后,还不能直接判断设备能否训练:一次更新要保存的对象,是否只有模型权重?
Chinchilla v1 Fig.3 / Appendix F;课堂预算构造与论文实验分开
以下从计算对象、条件与原始证据继续展开。
原 N42 材料两张教学配置卡使用十进制 B(十亿):$6(4\times10^9)(400\times10^9)=6(8\times10^9)(200\times10^9)=9.6\times10^{21}$ FLOPs。它们没有在本课程实际训练,也没有测得比较成绩。
随后采用 Chinchilla v1 Figure 3 物理 p.6 的真实实验,先选择性呈现 $3\times10^{20}$ FLOPs 预算曲线并保留原坐标、实验点和虚线拟合。该预算与构造卡不同,构造卡不是曲线上的数据点。横轴参数用对数刻度,纵轴是训练损失;沿同一预算线改变 N 时,对应训练消费 D 也在改变。论文为不同训练长度匹配学习率日程,不能把一次训练的中途 loss 截点当作同一类实验。
Chinchilla 原文 §3.2 / Figure 3;完整原图及说明。
沿单条预算线移动,比较的是固定计算预算下模型规模和训练消费的分配。小模型一侧可能受容量限制;大模型一侧则可能在充分受训前耗尽预算。谷底附近是指定模型、数据、训练与评价条件下的证据,不是永久比例,也不是越大越好的证明。
恢复多预算原图后,换曲线表示改变总训练投入。图中不从像素估算未经表值支持的精确最优坐标。8B 是后段统一教学配置,不对应声称的某个最优点。训练 loss 也不是用户满意度;高频使用时还应考虑服务成本。
Kaplan / Chinchilla / Gopher 与生命周期成本;MoE 总参数、激活参数与异构承载。稠密 6ND 不无条件套用 MoE 总参数。
原图、轴、实验点和拟合完整可查;分清改变 N/D 与截取训练中途状态。
保留左右两侧及多预算图,解释条件化结论与生命周期成本。
连接 Kaplan、Chinchilla 及推理成本,讨论为何训练 loss 并非所有应用目标。
指定 8B 混合精度 Adam 账本包含 BF16 工作权重 16 GB、低精度梯度 16 GB、FP32 主权重 32 GB,以及各 32 GB 的 m/v。持久小计为 128 GB;激活、临时空间与通信缓冲另计,因此它不是运行峰值。
仍沿前面的一次更新:先前向计算损失,再求梯度。八十亿参数采用 BF16,每个数两个字节,工作权重就是十六 GB。这里用十进制 GB。权重文件只回答这套参数怎样保存,还没有列出为了修改参数而需要的其他对象。
BF16 和 FP32 分别为每数 2 与 4 bytes;本页不假定某个实际设备容量。
8B / 四卡混合精度 Adam 教学构造;ZeRO 机制,非硬件实测
按本页的混合精度 Adam 设定,再加入十六 GB 低精度梯度、三十二 GB FP32 主权重,以及各三十二 GB 的历史统计 m 和 v。m 累计梯度方向,v 累计梯度平方的信息。当前梯度、主权重与这两份历史共同参与更新;新主权重再转成工作精度,供下一步计算。
m、v 是两份优化器历史统计,不是两套独立模型。图中三类输入一起进入 Adam 更新,再保存新主权重与新 m/v;没有 m/v 先转化为主权重的步骤。
8B / 四卡混合精度 Adam 教学构造;ZeRO 机制,非硬件实测
五项相加是一百二十八 GB,相当于每参数十六字节。这是持久状态的小计,激活、临时工作区和通信缓冲还在账外,不能把它当运行峰值。现在加到四张卡:硬件容量增加了,程序会不会自动把每张卡保存的内容除以四?
8B / 四卡混合精度 Adam 教学构造;ZeRO 机制,非硬件实测
以下从计算对象、条件与原始证据继续展开。
一次更新先用工作权重做前向,给真实后词分配概率并计算 loss;反向沿计算图求出参数梯度。梯度表示当前损失对参数的局部变化关系,不是另一份模型知识或生成答案。反向还要使用前向激活或重算得到的中间量。
本课程采用混合精度 Adam 教学设定:BF16 工作权重与低精度梯度、FP32 主权重,以及两份 FP32 历史统计 m/v。优化器据此更新主权重,再形成工作权重供后续计算。实际实现可以采用不同精度和状态策略;这不是唯一训练实现。
完整训练状态账本;ZeRO §3.1(原论文讨论 FP16,本课用 BF16 设定)。
以下全部采用十进制 GB,$1GB=10^9$ bytes,N=8×10⁹ 参数。
| 状态 | 每参数字节 | 本课容量 |
|---|---|---|
| BF16 工作权重 | 2 | 16 GB |
| 低精度梯度 | 2 | 16 GB |
| FP32 主权重 | 4 | 32 GB |
| FP32 统计 m | 4 | 32 GB |
| FP32 统计 v | 4 | 32 GB |
| 持久状态小计 | 16 | 128 GB |
图中五条从相同零点起,16GB 条长是32GB条的一半。128GB 不包括激活、临时算子空间、通信缓冲及运行环境;不能当实际运行峰值,也不是所有8B模型的固定训练需求。
沿前向、反向和 Adam 更新说明五类对象的用途,以及主权重怎样形成下一轮工作权重。
完整精度假设和表格,可复算 2+2+4+4+4 bytes/参数,并区分持久状态与峰值。
复制式数据并行让四卡处理不同数据,却每卡保留完整状态。全状态分片可把指定持久小计从每卡 128 GB 降至 32 GB;当前层计算仍需临时取齐参数,反向梯度仍需共同归约,由所属片完成更新。节省长期冗余伴随通信与临时视图。
先采用最直接的数据并行:四张卡读取不同样本,但每张都执行完整模型,因此各自保留同一套完整训练状态。在刚才那份账本下,每卡长期小计仍是一百二十八 GB。数据分开处理,不等于模型状态自动分开保存。
8B / 四卡混合精度 Adam 教学构造;ZeRO 机制,非硬件实测
现在只改变长期保存责任。四张卡各保管四分之一参数、梯度与优化器状态,长期小计降到每卡三十二 GB。但每张卡的样本仍需经过所有层;分片保存不是把一条样本永远交给某一张卡独自处理。
本页比较复制式数据并行与参数、梯度、优化器状态均分片的设定。原 ZeRO 1/2/3 的 56/44/32 GB 逐级账本保留于深入材料;主讲只比较两端。
8B / 四卡混合精度 Adam 教学构造;ZeRO 机制,非硬件实测
轮到当前层时,每张卡临时取齐该层需要的参数,完成计算后可以释放临时完整视图。图里长期小片与当前层完整视图必须分开算:三十二 GB 是长期小计,不是这时刻的峰值。交换缺少的参数还需要通信。
当前层取齐是临时工作视图,通信缓冲、激活与其他临时对象仍需额外空间。张量并行、流水线并行和状态分片不是同一概念。
8B / 四卡混合精度 Adam 教学构造;ZeRO 机制,非硬件实测
不同数据产生的梯度必须合成共同的更新依据,再由各状态片的持有者更新。下一轮取齐的是属于同一新版本的参数,不能让四张卡各自走成四台不一致的模型。分片减少重复保存,同时增加通信与临时视图。接着回到单卡:能否减少那张 attention 大表的保存和搬运?
8B / 四卡混合精度 Adam 教学构造;ZeRO 机制,非硬件实测
以下从计算对象、条件与原始证据继续展开。
数据并行中,每张卡处理不同数据,但每批数据都经过整个模型。各卡参数梯度经汇总后执行一致更新,所以模型副本维持一致。本课 DDP 设定下,各卡都长期保存完整工作权重、梯度和优化器状态:每卡128GB,不因四卡总容量而自动除以四。
层用 L₁…Lₙ 表示,参数分片用 θ₀…θ₃ 表示,不能混为各卡分管不同层。TP 切分同一层的张量计算,PP 分配不同层并安排微批流水线,这些与数据并行的身份不同。
在本课四卡混合精度账本下,ZeRO-1 仅分片优化器相关状态,每卡 $16+16+96/4=56$ GB;ZeRO-2 再分片梯度,$16+16/4+96/4=44$ GB;ZeRO-3 再分片工作权重,$128/4=32$ GB。上述均是持久状态小计。
实线框保存本卡长期负责的片;当前层计算之前,通过 all-gather 暂时取得该层完整参数视图,虚线框只代表这一层而非整个模型。本卡数据仍走全部层。当前层计算后可释放临时完整视图,再为下一层安排参数。真实 ZeRO/FSDP 实现会选择预取、驻留和通信重叠策略;临时视图、激活与缓冲使运行峰值高于32GB。
同一参数在不同数据批次上产生不同梯度贡献。reduce-scatter 将同一个参数的贡献归约,并把结果交给负责该分片的卡;不把不同参数的梯度混加。若训练目标用批次平均损失,归约时还需要与目标口径一致的缩放。
本卡拿到所属参数的共同梯度后,使用自己保存的主权重和 m/v 更新所属片。下一轮 all-gather 取得这些共同更新后的参数,因此所有数据仍在训练同一个模型。完整闭环是:各卡数据前向→需要时取齐层参数→反向产生梯度→按同参数归约分散→所属卡更新→释放临时量→下一轮取得新参数。
ZeRO §5.2、§7.2,物理p.10、14;保留的七步展开与预取/峰值说明。
以同一四卡结构对照不同数据与完整模型状态,说明复制式数据并行。
完整 ZeRO 分级账本与参数取齐/释放图,解释长期小计和临时峰值的区别。
逐态展开共同梯度、归约、所属片更新及下一轮参数取齐。
固定一个 Q 块,逐次处理所有允许的 K/V 块。每块计算后释放局部分数,保留可合并分子 u、分母 l 与稳定尺度 m;全部块完成后才输出 u/l。这样的执行减少完整 S/P 表写回与再读,不删除合法位置,也不消除稠密配对的二次算术。
回到前面的硬件图。直接实现先由 Q/K 算出 S,再将 S 读回做归一化得到 P,最后用 P 汇总 V。这里的问题不是这些关系不该算,而是完整 S 和 P 在阶段之间反复写回显存、再被读出来。我们保持同一读取目标,改变执行顺序。
教学构造与机制示意;非模型实测
现在固定一个 Q 块,只把第一块允许的 K/V 送入片上工作区。局部分数算完即可释放,但留下累计权重 l、累计加权内容 u 和用于稳定计算的尺度 m。其余块仍在显存里等待,不能把第一块的局部平均当作最终输出。
l 为归一化分母的累计,u 为加权 value 的累计;m 是稳定指数计算的最大值尺度。当新的最大值变大时,旧 u 和 l 必须一起重缩放。三块流程是执行示意,不配成下述两块手算的数值结果。
教学构造与机制示意;非模型实测
第二块加入时,旧贡献继续保留,再把新块的权重与内容合进同一个累计。两块贡献有不同的总权重,直接平均两份局部答案通常不对;必须连分母一起合并。绿色区表示已经处理,灰色区提醒我们还有允许的位置尚未加入。
完整手算 w=(2,1,4)、v=(10,20,30):块1 u₁=40,l₁=3;块2 u₂=120,l₂=4;合并输出 160/7≈22.86。稳定递推与向量公式在本页深入正文保留。
教学构造与机制示意;非模型实测
第三块完成后,当前 Q 块所允许的全部 K/V 都参加了共同归一化,才用 u 除以 l 得到完整输出并写回。减少的是完整中间表的保存与搬运;反向还可以重算部分量来节省空间。稠密配对的平方算术仍在。现在停止更新,看看训练好的参数如何处理一份请求。
T 是序列长度。FlashAttention 减少中间量物化与 IO,训练反向可以重算;仍覆盖全部允许 key,并没有把一般稠密注意力所有二次算术变成线性。
教学构造与机制示意;非模型实测
以下从计算对象、条件与原始证据继续展开。
直接 attention 实现会生成分数矩阵,写入显存,再读出做 softmax,随后使用归一化权重汇总 V。HBM 容量、片上工作区容量、计算吞吐和数据搬运带宽是不同约束。这里先定位问题;N49–N51 回到同样的内存层级,用分块与在线归一化解释如何减少保存和搬运,不提前把名称当答案。
来源:FlashAttention v2,§3.1 IO 分析。
相关的完整阅读材料保留原有公式、引用和原始图解。
直接分步 attention 实现可能物化完整分数矩阵 S=QKᵀ,再写入 HBM;读出 S 做 softmax 得到概率 P,再写回;之后读取 P 与 V 相乘。蓝色箭头为读入片上、红色为写回。课堂路径代表会物化大中间表的一类直接实现,不表示所有现有库都如此。
T为序列长度。稠密关系按 query 与允许的 key 比较,分块不能随意漏掉本应参与的位置。片上工作区放不下整表时,可分块计算并保留可合并累计;难点是 softmax 仍需跨所有有效位置共同归一。
FlashAttention 的IO模型与范围;论文 §2、§3.1。
原 N50 保留的校准算例:正权重w=(2,1,4),value=(10,20,30),前两项为块1、第三项为块2。
$$u_1=2\times10+1\times20=40,\quad l_1=2+1=3;\qquad u_2=4\times30=120,\quad l_2=4.$$
$$o=\frac{u_1+u_2}{l_1+l_2}=\frac{160}{7}\approx22.86.$$
直接平均两个局部均值是$(40/3+30)/2=65/3\approx21.67$,与正确输出不同,因为两块分母不等。
稳定递推。 logits=(ln2,0,ln4)。首块用m=ln2缩放,得到u=20、l=1.5;第二块的最大值ln4更大,旧分子和分母一起乘1/2,第二块贡献u_b=30、l_b=1。因此新u=40、l=1.75,输出40/1.75=160/7。一般公式为$m'=\max(m,m_b)$,$u'=e^{m-m'}u+e^{m_b-m'}u_b$、$l'=e^{m-m'}l+e^{m_b-m'}l_b$。
完整向量实现与因果mask见在线softmax正文。旧权重(2,1,3)与130/6只作为历史算例,不是原 N50 材料当前数据。
原 N51 材料把N50两块数值验证推广为三块过程示意,不把三块流程配成160/7这一数值结果。固定一个Q块,依次将所有允许的K/V块装入片上工作区,更新最大值m、归一化分母l与分子u。局部中间表释放后,累计量仍保留。第3块完成、所有允许位置都参与后,才计算u/l并写回该Q块输出。
训练反向可以按块重算所需中间量,以额外部分算术换取少保存、少搬运。FlashAttention 保持同类精确attention数学目标,浮点求值顺序变化不保证逐bit一致;稠密算术仍含$T^2$,T为序列长度。固定Q扫描KV是课堂执行视角,不声称逐行复现Algorithm1循环次序。
FlashAttention §3.1 / Algorithm1 / Theorem1;完整在线稳定递推、反向重算、MoE与KTransformers边界。
沿 Q/K→S、S→P、P/V→O 核对每次读入与写回,定位完整大表的成本。
用 (2,1,4) 和 (10,20,30) 手算正确 160/7、错误 65/3,并展开稳定归一化递推。
三块执行图展示待处理、累计与写回,说明重算、全覆盖和浮点边界。
参数保存训练所得,K/V 保存特定请求在特定层的当前计算状态。prefill 处理已知提示并产生首分布,选择首 token 后进入逐步 decode。新位置读取允许的旧 K/V 与当前状态,将输出交给下一层,并把本层新 K/V 追加到缓存。训练见过同文,并不等于已有可直接复用的请求缓存。
训练停下以后,普通推理保留参数,不为每条请求建立训练用的梯度和 Adam 历史。但参数不是为每次请求预先备好的当前状态。即使训练见过相同文字,这份 A/B 请求仍需前向计算,或复用已有且兼容的缓存,才能获得本次表示和 K/V。
教学构造与机制示意;非模型实测
先处理已经给定的提示,这个阶段叫 prefill。每层可以成批处理已知位置,各行仍遵守因果读取。它建立各层状态,并得到首输出位置的概率分布;此时并没有整段未知回答。先有分布,再选择第一个 token,是两个动作。
教学构造与机制示意;非模型实测
假设选择出图中的教学 token B,它才成为新的已知输入,进入逐步生成的 decode。参数与刚才相同,增加的是一个位置,旧位置已有的兼容计算可以复用。现在放大其中一层,把“使用缓存”拆成具体的读取与追加。
B 为教学 token 标记,并非本课模型实测分词或生成结果。首分布、选择 token、decode 三个阶段不得混成“一次 prefill 给出完整回答”。
教学构造与机制示意;非模型实测
新位置形成自己的 Q、K、V。Q 与允许的旧 K 以及当前 K 匹配,按权重汇总对应 V;本层输出送往下一层,新 K/V 则追加到本层缓存。旧因果位置不依赖后来加入的 token,所以兼容时不用重算;但旧 K/V 仍要被读取,缓存也随生成增长。
图示五列到六列是为了看清追加,不是实际 tokenizer 计数。旧 Q 通常不为所有后续步骤长期保存;临时激活仍存在。
教学构造与机制示意;非模型实测
以下从计算对象、条件与原始证据继续展开。
输入 BOS / I / gave / him 对应下一词标签 I / gave / him / a。gave 行可读取 BOS、I、gave,而不能读取后面的输入 him。标签 him 在目标端,不作为该行可见输入。训练前向之后另有 loss 与反向更新;推理 prefill 处理已知提示,只做前向;decode 生成未知新 token,需要逐步等待。
来源:L5 T30/T34 的因果训练与生成;原句片段固定使用 him。
相关的完整阅读材料保留原有公式、引用和原始图解。
训练结束后,普通推理保留模型参数,不为每条请求重新建立梯度和 Adam 更新历史。本次输入仍须经过所有层,计算新的表示与 K/V。prefill 是处理已知提示的前向阶段;对因果模型,位置可批量处理,但每个位置只能读取合法前缀,层与层之间仍有依赖。
首输出概率分布与选择首 token 是两个动作。选出首 token 后,才有新的已知输入供下一轮 decode 使用。图中的 B 仅标识示意 token,不宣称真实 tokenizer 切分或模型运行结果,也不把 prefill 画成同时生成完整回答。
原推理流程与完整说明 · 服务系统主题 · PagedAttention §2.1–2.2,物理 p3。
因果计算使旧位置的表示不依赖后来追加的 token,因此旧 K/V 可以复用。每个新 token 在当前层生成自己的 Q、K、V:Q 匹配允许的旧 K 和当前位置 K,权重用于汇总对应的 V,输出送往下一层,新 K/V 追加本层缓存。
缓存复用省掉的是旧位置重算,不是后续读取成本。旧 Q 通常不需要为所有后续步骤持久保存;临时激活和其他运行状态仍然存在。图示一层,各层有各自的缓存。改变参数、前缀或位置计算条件后,应重新判断兼容性,不能任意修改旧文本而沿用缓存。
完整 KV 机制 · 服务主题与兼容条件 · PagedAttention §2.1–2.2,物理 p3。
完整 prefill→首分布→选 token→decode 图,解释已知输入与未知输出的依赖。
逐条路径区分读取旧状态、追加新状态和交给下一层,附缓存兼容条件。
对照相同 token 前缀和独立尾部,解释语义相似为何不足以复用缓存。
KV 本体估算为 M=2LTh_KVd_headb。指定配置每 token 为 128 KiB,8192 个已缓存 token 为 1 GiB,八份互不共享的同长请求为 8 GiB。长输入、长输出与并发分别增加不同工作,容量、首 token 等待和逐 token 延迟应分开判断。
给缓存计量之前,先把配置说清:三十二层、每层八组 K/V、每组一百二十八维,BF16 每数两个字节。每个 token 要保存 K 与 V 两份,乘上层数、组数、维度和字节数,得到一百二十八 KiB。这个量来自指定配置,不是所有八十亿参数模型的固定规格。
指定配置的教学算例:32 层、8 KV 组、128 维、BF16;二进制 KiB / GiB
如果输入与已经进入缓存的生成部分合计八千一百九十二 token,KV 本体约一 GiB;八个不共享上下文的同长请求就是八 GiB。权重可以共用一份,当前状态却各自对应不同请求。这里用二进制 KiB/GiB,和前面训练账本的十进制 GB 分开。
指定配置的教学算例:32 层、8 KV 组、128 维、BF16;二进制 KiB / GiB
所以要把“慢”拆开。长输入增加 prefill 计算与历史状态;长输出增加顺序 decode 轮次,并继续增长 KV;高并发还叠加排队与容量压力。同一请求可能同时遇到几种压力,先定位增加了哪类工作。执行安排帮助计算完成,却没有给原 A/B 记录补出任何新测量。
深入材料按作用对象分组:分页改变 KV 物理分配;精确前缀共享减少兼容的重复状态与计算;连续批在生成轮间接纳请求;prefill/decode 分离分别配置阶段资源并支付状态交接成本。这些不是每个请求必经的顺序技术栈。
指定配置的教学算例:32 层、8 KV 组、128 维、BF16;二进制 KiB / GiB
以下从计算对象、条件与原始证据继续展开。
本课指定教学配置为 L=32 层、每层 h_KV=8 组、每组维度 d_head=128,每数 BF16 占 b=2 bytes。KV 的常用存储估算为 $M_{KV}=2LTh_{KV}d_{head}b$,T 是已经进入缓存的输入与生成 token 总长度。首项 2 表示 K 与 V 两份,最后的 b 表示每数存储字节。
每 token:2×32×8×128×2=131072 bytes=128 KiB。8192 token:1073741824 bytes=1 GiB;32768 token=4 GiB。8 个互不共享、各长 8192 token 的请求共需 8 GiB KV。权重可以共享,当前上下文状态不能任意合并。
KiB=2¹⁰ bytes,GiB=2³⁰ bytes;与训练账本的十进制 GB 分开。GQA 是这种减少实际 KV 头/组数的一类架构安排,但本配置不是所有 8B 模型的固定规格。
原 KV 容量页 · 完整服务主题 · PagedAttention §2。
把逻辑序列按 B 个 token 一块组织,长度 T 需 ceil(T/B) 个块。图示 B=4、T=6,因此用两块:逻辑0保存1–4,逻辑1保存5–6,末块空2槽。生成到7、8时补满第二块;第9个需要第三块,末块空3槽。
块表把逻辑0、1、2分别映射到物理7、1、5;读写按逻辑顺序定位,物理块无需连续。它不改变 token 的因果顺序,也不是完全零浪费;尾块仍有内部空余。请求完成可以释放独占块,共享块须检查引用计数;写入共享尾块时,具体实现还需写时复制等安排。
PagedAttention/vLLM 在请求缓存的分配与访问层面工作,FlashAttention 在注意力算子的中间量存取层面工作,两者可以配合。
原分页图与说明 · 服务主题 · PagedAttention §4.3 / Fig.6,物理 p6。
按 N54 的128 KiB/token配置,两个请求各含4096 token共同前缀与2048 token独立尾部。未共享时两份6144 token共12288 token,即1.5 GiB;共享一份前缀后总量4096+2×2048=8192 token,即1 GiB。
精确前缀复用要求同模型、相同 token 序列和兼容的位置及计算条件。文本含义相似不保证 K/V 相同;前文或前缀某个 token 改变后,从改变位置起的后续状态需要重新判断,不能把全段旧缓存当作可原样复用。共同前缀之前未改变且条件兼容的部分仍可独立核对。
两个尾部各有自己的状态和生成路径。共享节省重复 KV,也可能省重复 prefill,但不表示两条请求的全部计算合并。旧材料中的三请求2.25→1.25 GiB是另一构造,与原 N56 材料两请求1.5→1 GiB分开。
前缀匹配与 RadixAttention / SGLang · 服务主题 · PagedAttention §4.4,物理 p7–8。
R_A、R_B、R_C 是服务请求标识,与实验方案A/B无关。三个请求需要的生成轮数分别为2、4、2,且为隔离接纳规则,假设入场 prefill 已完成;每轮可安排两个示意生成槽。
固定整批策略:前两轮R_A/R_B并行,R_A结束后其独占状态可释放,但R_C要等R_B整批结束,所以第3/4轮一个槽空闲,第5/6轮R_C才生成。图中的槽表示调度机会,不是GPU为每请求永久划定的物理位置。
没有给每轮规定相同实测毫秒,也没有测量GPU吞吐,因此不能直接将轮数作硬件加速比。
原批处理演示 · PagedAttention §2.3,物理 p3。
连续批处理在生成轮次间调整活跃请求集合。此例保持N57的请求长度不变:前两轮R_A/R_B共同执行,R_A完成后第三轮R_C补入,R_B不中断;第四轮R_B/R_C均完成。总生成工作量不变,R_C比固定整批少等两轮。
六轮变四轮是调度构造,不是实测1.5倍GPU加速。真实轮耗时受活跃批量、输入处理、内存访问、算子及设备影响。新请求接纳还需要prefill准备、KV容量、延迟目标满足条件,不能只看是否有空格。
评估实际系统时区分排队时间、首token延迟、逐token延迟与吞吐;提高吞吐的安排可能增加个别请求等待。
原调度页 · 完整服务正文 · PagedAttention §2.3 / §4.5。
长输入、长输出与高并发不是同一个问题。长输入增加prefill计算与状态;长输出增加顺序decode轮次并持续增长KV;高并发叠加排队、批次安排和容量压力。
在同设备上,大块prefill工作可能干扰正在decode的请求。P/D分离把两类阶段安排到不同资源,prefill结束后交接K/V等必要状态,decode继续产生输出。它允许分别配置与调度资源,也增加状态传输、模型驻留和协调成本,效果依赖输入/输出分布、请求量、设备及互联。不能因图被分成两栏就断言更快。
首token等待与后续逐token延迟应同时考察。Dynamo、LMCache、Mooncake等组件按实际职责在既有正文展开,不组成每次请求必须依次安装的技术栈。
服务技术栈与资源交接 · 完整服务主题 · DistServe §2.1–2.3 / §3.3。
把 K/V 两份、层数、KV 组、维度、精度与缓存长度逐项相乘,复算 KiB/GiB。
用逻辑块、块表和物理块展示按需增长与尾块空余;作用对象是缓存分配。
完整两请求算例从 1.5 GiB 到 1 GiB,并核对精确 token、参数与位置条件。
固定整批六轮与连续批四轮的同工作量教学对照,附容量和延迟边界。
定位 prefill/decode 的不同压力,解释分离资源后的 K/V 交接和成本。
当前 A/B 输入提供 12 秒、8 秒和未测内存;训练参数提供语言、比较与回应能力;运行系统把参数与当前状态的计算实际完成。教师参考的范围、比较与未知项均可逐句回指材料。优化执行不会替代尚未进行的测量。
回到这份原 A/B 材料:十二秒、八秒和未测内存,都来自当前输入。我们已经看过训练与执行,现在把三件事接到同一回答上:这次事实从哪里来,理解和回应的本领从哪里来,以及这些计算怎样真正完成。
本页主讲是同一回答的证据、训练参数和运行过程溯源。A/B 记录与回应均为教学构造和教师参考,不是模型实跑。
A/B 教学记录与教师参考;当前事实、训练参数与推理执行的作用位置
过去训练形成参数,当前材料形成这一次的表示与状态;两路在 prefill/decode 过程中会合。若加示例,它也从当前输入进入,不自动更新参数。放大一层可见,attention 与 MLP 都使用训练参数处理当前表示,不能把所有事实或本领机械归给其中一个模块。
A/B 教学记录与教师参考;当前事实、训练参数与推理执行的作用位置
把教师参考逐句核对:“本次测试”限制比较范围;“B 耗时更短”依据十二与八;“内存尚未比较”依据未测项。系统从计算开始就帮助执行,却不能替代没有发生的测量。接下来真正加入一项内存证据,看看原回答和选择应怎样改变。
候选生成—评价—训练目标—参数更新是独立的后训练问题,完整保留在 N60 延伸阅读。它不是本页画面所执行的流程,也不作为本页主证据。
A/B 教学记录与教师参考;当前事实、训练参数与推理执行的作用位置
A12秒、B8秒与未测内存来自本次材料。训练形成的参数提供语言、比较与回应能力;当前输入形成表示、K/V等状态;若加入示例,示例同样经当前计算起作用,不因此自动改变参数。
运行系统从一开始就包住prefill和decode,缓存、算子和调度帮助计算完成。它不能为材料补出未测量的内存结果。“B在本次测试中耗时更短”依赖12与8及相同设置;“内存尚未比较”依赖未测项。参考回答是教师给出的分析,不是模型实跑。
参数与当前状态 · SFT · 推理服务 · 上下文与记忆主题。
生成候选,又会成为下一轮训练的材料另行解释候选、评价信号与参数更新之间的步骤。普通请求中的生成和反馈不会因此自动改写参数。
完整请求、两路会合图和逐短语对照,区分事实、能力与执行。
把训练形成的投影规则和当前 X/K/V 分开,解释示例为何可以影响回答而不更新参数。
独立展开候选、评价、目标与优化器更新,说明普通推理反馈不自动改变参数。
当前教学记录为 A12 秒/3 GiB、B8 秒/5 GiB。B 用时更短,A 峰值内存更低;施加峰值严格小于 4 GiB 的约束后,在两项候选中选 A。新测量补足事实,新约束改变选择,执行优化需新测试,不能改写已有证据。
现在真正新增一项教学测量:A 的峰值内存为三 GiB,B 为五 GiB;用时仍是十二和八秒。内存已经测过,不能继续沿用“尚未比较”。先分别读两项数据,暂不急着选一个全面更好的方案。
A12 秒/3 GiB 与 B8 秒/5 GiB 均为课堂构造,用于观察证据和约束如何改变判断;不是本课新增硬件实验。
新增测量与约束均为教学构造;教师参考分析,非真实A/B实验或模型实跑
八小于十二,所以 B 在这次测试中耗时更短;三小于五,所以 A 的峰值内存更低。两个结论同时成立,却落在不同方案上。要把测量变成选择,还需要知道我们优化什么,以及必须先满足什么限制。
新增测量与约束均为教学构造;教师参考分析,非真实A/B实验或模型实跑
现在加入约束:峰值内存必须小于四 GiB。A 为三,满足;B 为五,不满足。在当前两个选项和这份记录中,应选 A。若只追求本次更短用时,才支持 B。改变的是选择问题的约束,并没有把原来的速度与内存证据改写。
严格小于 4 GiB 是硬约束,不是越低越好的一般偏好。本例没有等于 4 GiB 的候选;不得把判定偷换成小于等于。
新增测量与约束均为教学构造;教师参考分析,非真实A/B实验或模型实跑
保留当前证据来决定下一步。缺测量,就补证据;反复忽略材料或要求,就检查提示、评价与训练;计算太慢或装不下,就定位执行约束。还没测过的优化,不能把五GiB宣布成三GiB。带着当前选A的判断,回到本讲的三个问题。
新增测量与约束均为教学构造;教师参考分析,非真实A/B实验或模型实跑
以下从计算对象、条件与原始证据继续展开。
原 N62 材料在同一教学构造中增加内存测量:A12秒/3GiB,B8秒/5GiB。当前材料已经有内存数据,因此不再把“未测内存”同时显示为当前事实。两项独立结论是B用时更短、A峰值内存更低。
若目标只是这两次测试里更短用时,记录支持B;若先要求峰值内存<4GiB,A=3通过、B=5不通过,当前两选项中支持A。目标与约束改变,判断随之改变;不是给对象固定贴上“更好”标签。
这首先要求读取新输入和条件,不要求立即再训练。实际模型能否稳定做到还需独立材料检验。若慢,应检查prefill、生成长度、KV与调度;若反复忽略要求,应检查提示、评价与训练。优化执行不会把原始测量5GiB改成3GiB,也不能凭空补回未做的测量。
保持两项数据、分别比较、添加严格小于 4 GiB 约束,并逐项核对候选。
回顾当前输入、参数和执行系统的不同作用,确定下一步该补什么。
回看同一查询在 M=1 与 M=256 时的结果:目标仍被写入,为什么读回不同?
开场使用固定查询 k₀ 与目标 v₀:M=1 时,读回与目标一致;在 M=256 的同源对照中,其他关联贡献明显混入,而目标关联本身仍在存储中。这说明“存入”与“可单独读回”需要一起判断。写入方式、读取方式、维度和允许误差共同决定某个检索任务下的可用容量。模型参数长期承载训练形成的信息,当前上下文则提供本次读取的对象,两者不能混为一类存储。
两档来自 AR01 的同一随机向量教学实验,同一数组前缀、同一查询、同一目标和固定显示尺度;图样显示64维 value,不是图像分类成绩。该实验说明特定装置的读取行为,不测量真实语言模型的知识条数。
“参数与当前上下文”是信息来源和计算职责的区分,不意味着所有模型知识都能定位到独立参数条目。
AR01 同源随机向量实验的 M=1/M=256 对照;不是大模型知识量测量。
遇到容量结论时,可以追问四个条件是否明确:如何写入、如何读取、表示维度多大、允许多大误差。改变其中一项,就需要重新比较;因此容量应连同任务和测量口径报告。
从猫车观察到 Scar 干预,每一步增加了什么证据?比较时保留不同模型与实验条件。
InceptionV1 的猫车高响应图像首先构成内部观察,促使研究者提出“局部尖形/V形”这一跨物体类别的候选解释。另一个 Qwen3-32B 的保存案例,对指定下一 token Scar 比较未删除、指定删除和同层同数量随机删除:概率由0.9057降至0.2378,匹配随机删除约0.91。该受控差异支持所删两组单元对当前预测起作用。两组材料来自不同模型与实验;它们说明观察、解释和检验各增加了什么证据,而不是证明所有模型已经完全可解释。
Scar 案例中被指定删除的是 The Lion King 与 Lions/savanna 两组共18个单元(7+11);概率变化不是整体准确率下降。该结论限于保存的输入、指定下一词位置、归因和干预协议。自然样例、优化图、归因、消融与近反例的证据强度不同;新例或反例仍可能修正原有解释。
Goodfire 原始材料;猫车为 InceptionV1,Scar 为 Qwen3-32B 保存案例,数值沿用已校准 RG19。
如果随机删除产生相近下降,原来的指定解释就会削弱;如果新例与解释预期不符,解释也需修正。对照和反例的作用,是让一种看似合理的说法承担可能被推翻的风险。
更快的 B 超出内存约束,此时为什么应选 A?用这次选择回收算、存、搬的区别。
在相同教学测试条件下,A 耗时12秒、峰值内存3GiB,B 耗时8秒、峰值内存5GiB。当峰值必须严格小于4GiB时,B 的速度优势不能补偿违反约束;在已给出的两个候选中,应选满足约束的 A。这个判断连接计算、存储与搬运的资源账,也连接任务目标与可执行条件。新的优化方案可以成为候选,但其速度和峰值内存必须重新测量,不能从技术名称推定收益。
A/B 数值与峰值约束均为课程教学构造,不是某个真实 GPU 或模型的基准。结论只在当前候选、相同测试口径及这一约束下成立;并未证明 A 在所有任务或所有约束下最好。
A/B 时间、峰值内存及阈值为教学构造;沿用 RC-F2,不是硬件实测。
当约束换成峰值小于6GiB时,B才重新进入可行集合,随后还须按任务质量与时间比较。这个条件变化说明,最优选择依赖约束;它没有改变原先小于4GiB条件下选A的判断。
回到 RC-F2,逐步比较最初时间信息和新增内存约束。
结合正文机制回看执行代价来自哪些对象。
使用 R5 账本说明当前为何选 A,以及改变哪个约束会改变选择。
以当前可行的 A 为基线,下一步能否找到同样装得下、又更快的候选?把目标写成可检验的问题。
当前选择 A 之后,一个可检验的新问题是:能否找到峰值内存仍严格小于4GiB、同时耗时低于12秒的候选?待研究的过程是提出候选、展开推理、运行并检验,再依据反馈修正。这个过程可能找到改进,也可能在当前条件下没有找到更优解;这里尚未提供新候选的测量结果。后续将继续讨论搜索、推理、验证,并回看中训练与后训练;第九讲通过工具、代码与可验证反馈连接实际任务。
反馈可以改变下一次候选、提示或行动;只有显式执行训练更新时才会改变参数。当前上下文中使用反馈,与优化器更新权重是不同过程。中训练与后训练的定义和组织方式随方法而异,并非所有模型必经的固定流水线。
后续问题与课程承接;未执行或声称完成搜索、推理验证实验。
候选可以从前文的分片、分块计算或请求组织中产生。先说明预期改善哪个瓶颈、可能增加什么代价,再用相同任务与测量口径比较时间和峰值内存。没有得到改进时,记录失败条件也能帮助下一次选择。