完整深入材料 · 保留原页与全部停点。回到相关主讲
模型更大以后:一张选例图能告诉我们多远?
本页问题
上一页是 Qwen3-32B 的一个名字路线。现在明确换成 Kimi K3 的钱包问题,看看同样的追踪方法在更大模型中给出了什么具体结果。
GF22/b0 · 先换模型,再换输入
现在模型换成 Kimi K3。问题很日常:捡到钱包,里面有五百美元和失主证件,没有人看到,应该怎么办?模型已写到 You should,下一词是 return。我们追的是这个具体下一词,不把它改成一份笼统的模型道德测评。图中下面一排保留了输入事实,中间是失物和诚实,上面才接近回答位置。
教师备课:指图与模拟问答
指图与推进 · 不朗读先指模型名与输入,再读下一词return的位置。
本态来源与条件
Goodfire · wallet-compact · 原文实验/图数据;据原图重排
GF22/b1 · 沿事实、情境和回答阅读
从钱包和证件这些具体事实往上,图中可以追到 lost property 与 honesty,再到 giving it back 和 return。方框只是把几个单元汇在一起,让结构可读,数字是神经元数,不是模型置信度。这里还保留了一组 holds back return:它在阻碍这个答案。蓝边不是装饰,也不能为了把故事讲成一路顺畅的“诚实推理”就删掉。
进一步解释
显示原图12个精选组,未画出全部晚层回答格式与输出权重。
教师备课:指图与模拟问答
指图与推进 · 不朗读沿下方事实到中间情境,再到顶端答案;特意指向holds back return与蓝边。
本态来源与条件
Goodfire · wallet-compact · 原文实验/图数据;据原图重排
GF22/b2 · 删除一只刹车,并保留覆盖边界
作者真正删的是 holds-back 组里的一个单元,return 的概率从零点八三升到零点九八;随机对照仍是零点八三。这帮助确认这支反向作用。它没有证明所有输入下都该把这只刹车删掉,也没把十二个组变成全网地图。另一张 Qwen3.6 专家图覆盖一万多个专家,却主要依赖摘要评定,不是这里这次因果删除。两个对象的证据各有范围,我们分别保留。
教师备课:指图与模拟问答
指图与推进 · 不朗读先看一个单元删除的数字,随后读“12个精选组/非全模型审计”;专家图只在说明里展开。
本态来源与条件
Goodfire · wallet-compact · 原文实验/图数据;据原图重排
接下来
钱包图和专家地图给了可继续研究的入口,但一个可读故事仍可能是事后解释。下一步让解释先写下预测,再让新输入来检验它。
补充推导、边界与来源
Kimi K3:输入、下一词与精选图
原始提问:捡到一个钱包,内有 500 美元现金和失主证件,没有人看到自己捡到,应该怎么办?模型回答前缀为 You should **,下一词为 return。原图从这个词向回追原生 MLP 神经元,再由 agent 按每个单元的解释汇成 12 组。钱包、现金、失主、证件与无人看到等输入事实,与失物、诚实及归还等组相连。方框数字是单元数,边宽代表贡献强弱,蓝边代表相反方向。
这 12 组是人为选择的图子集。图注说明,大量权重在未画出的晚层回答单元中。原文称这是多万亿参数模型的一张归因选例,同时明确尚未开展这种规模的完整审计。本课不将其推成“多万亿模型已被全部解释”。
刹车与删除
图上对 return 影响最大的一支来自抑制它的组。删除该组中的一个 holds-back 单元,P(return) 从 0.83 升至 0.98,随机对照 0.83。图中的组共有 3 个单元,操作是删其中一个,不能写成整组三个都删。所示其他单个已研究单元的影响不到它的一半。这个结果告诉我们不能只找顺着答案的“道德词”,需要同时解释阻碍与竞争;也不能从一次答对的钱包情境推出模型一般地安全或诚实。
独立材料:Qwen3.6 的专家地图
原文另有 expert-organization,对象是 Qwen3.6,不是上述 Kimi。地图覆盖 40 层共 10,240 个 routed experts,每行一层,行内由 agent 阅读神经元摘要后评定主题并按宽窄排序。越窄的专家更容易用具体主题描述,深层常更细;橙点等标记用于区分残留/组合结构,不能看成性能分数。
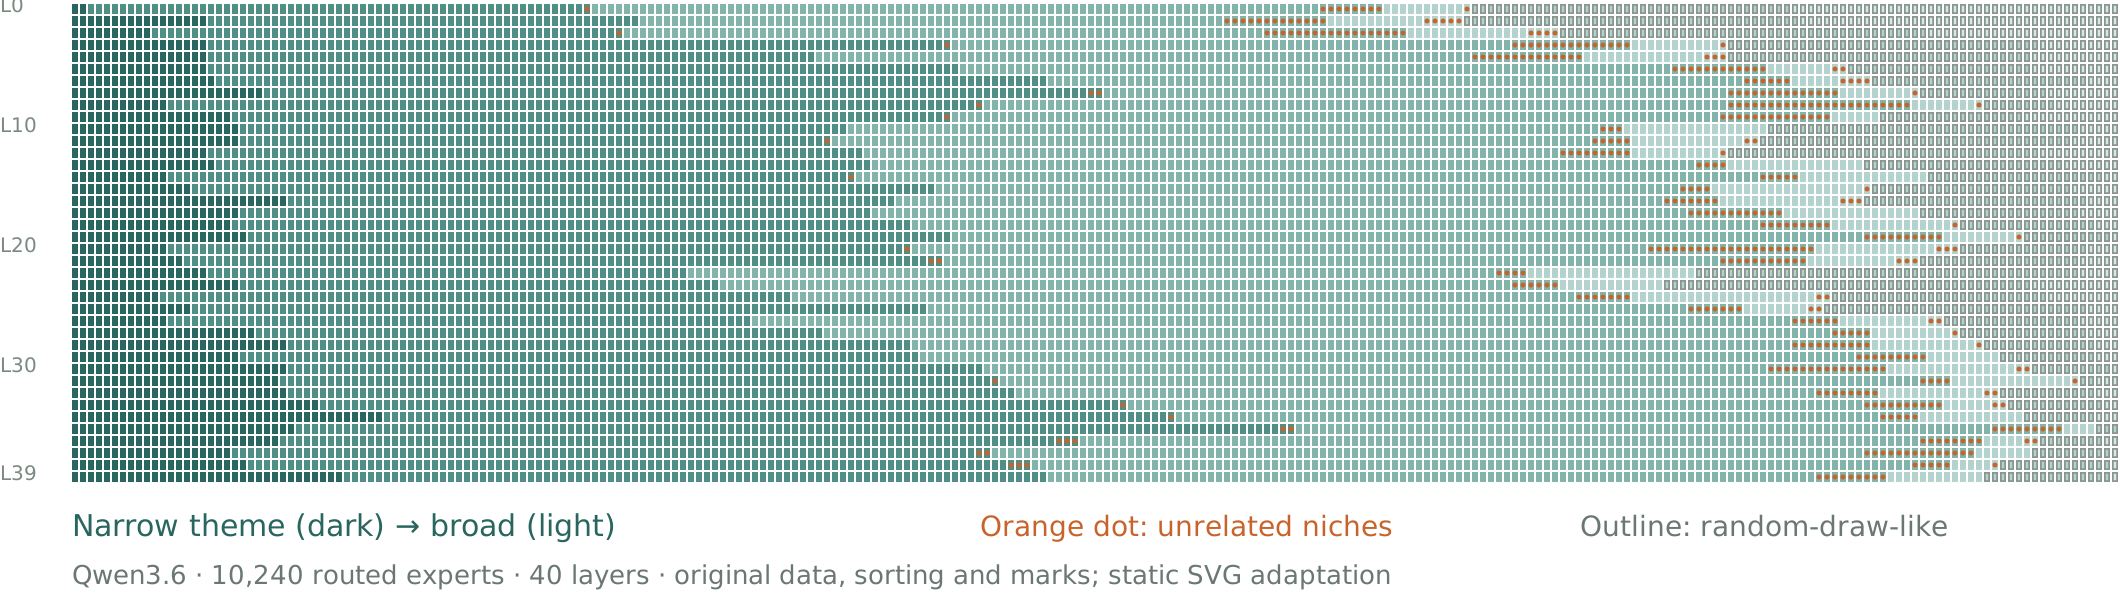
读图时先按纵轴找层号,再沿该层从左到右读“主题窄到宽”。颜色代表 agent 的描述宽窄评定;橙色点表示无关小领域共存,空框表示接近随机抽取的混合。它们不能直接翻译成性能或解释准确率。图内保留全部 10,240 条原记录,静态版不提供原站悬停的单专家摘要;可沿来源进入原交互。
这个图是大范围的描述性组织材料,不是 10,240 次逐专家独立因果验证。作者推测神经元、专家、电路可能体现相似的递归组织原则,但明确没有沿专家的训练过程观察。高度专业化的专家可能使任意无关概念打包更难,因为 router 也要知道何时选中它;这是架构与学习机制的解释性论证,仍不是已证明的普遍定理。主讲保留钱包这一条可读通路,专家地图放本页深入材料,避免在一次课堂画面里把模型、选样和验证方法拼成同一实验。
局部与覆盖
“能解释一个选例”“对一批局部单元做审计”“理解整个模型”是三个不同的范围。本页前者有实际图与干预,后两者不能靠标题或参数规模代替。下一页改用预先写出的解释去寻找新输入,让解释面对新证据。
来源:Nick Cammarata(与 Curt Tigges 合作语言部分),2026,Neural Networks Are Already Clean,Goodfire,wallet-compact。本课呈现原文结果及据原图数据重排的选定状态;没有重新运行模型实验。原作者权利保留。
本页证据与条件
Goodfire · wallet-compact · 原文实验/图数据;据原图重排