示例有效吗?看独立的完整翻译评价
本页问题
GPT-3 Table3.4报告同一175B模型在WMT’14英语到法语任务上的BLEU:zero-shot 25.2、one-shot 28.3、few-shot 32.6。评测仅前向、不更新模型参数。few-shot采用K=64的设置并受2048上下文窗口限制。该结果是指定翻译任务的证据,与A/B课堂构造例分开。
RC-A3/b0 · 先辨明测量对象
换看真实完整句翻译:GPT-3的175B模型,WMT英语到法语。BLEU衡量译文与参考译文的匹配,不是正确率;这也不是刚才的A/B实验。
进一步解释
原文为GPT-3 Table3.4,175B模型,WMT’14 English→French;采用multi-bleu.perl口径。完整六方向原表保留在阅读正文。
教师备课:指图与模拟问答
指图与推进 · 不朗读指任务卡的模型、方向、数据集、指标。
本态来源与条件
GPT-3 Table3.4原始翻译评测:175B、WMT’14 En→Fr、BLEU;固定参数仅前向。
RC-A3/b1 · 比较同模型三条件
同一模型固定参数:零例25.2,一例28.3,少样例32.6,提升7.4分。少样例上限K=64,还受2048 token窗口限制。
进一步解释
论文§3.3与Appendix H给出1/64个成对示例等设置;K=64与有限上下文窗口须一起解释,不能把它改成任意长度的64句保证。
K=64是论文少样例设置,受上下文窗口约束;不能解释为每个请求保证装入64个任意长度的句对。
教师备课:指图与模拟问答
指图与推进 · 不朗读读三根柱与K=64条件,不将7.4分说成百分比。
本态来源与条件
GPT-3 Table3.4原始翻译评测:175B、WMT’14 En→Fr、BLEU;固定参数仅前向。
RC-A3/b2 · 收益带着条件和代价
证据支持这个任务与配置中的收益,不能推广成示例越多越好。若希望每次不附示例也能按要求回应,可以进一步训练参数。
进一步解释
这个评价把机制可能性推进为指定配置下的收益证据。示例选择、上下文占用和执行成本仍需分别评价。
教师备课:指图与模拟问答
指图与推进 · 不朗读指固定权重、窗口限制及任务边界,转回AB请求。
本态来源与条件
GPT-3 Table3.4原始翻译评测:175B、WMT’14 En→Fr、BLEU;固定参数仅前向。
接下来
希望不必每次给示范,就把回应方式训练进去。
补充推导、边界与来源
| 示例条件 | BLEU |
|---|---|
| Zero-shot | 25.2 |
| One-shot | 28.3 |
| Few-shot,K=64设置 | 32.6 |
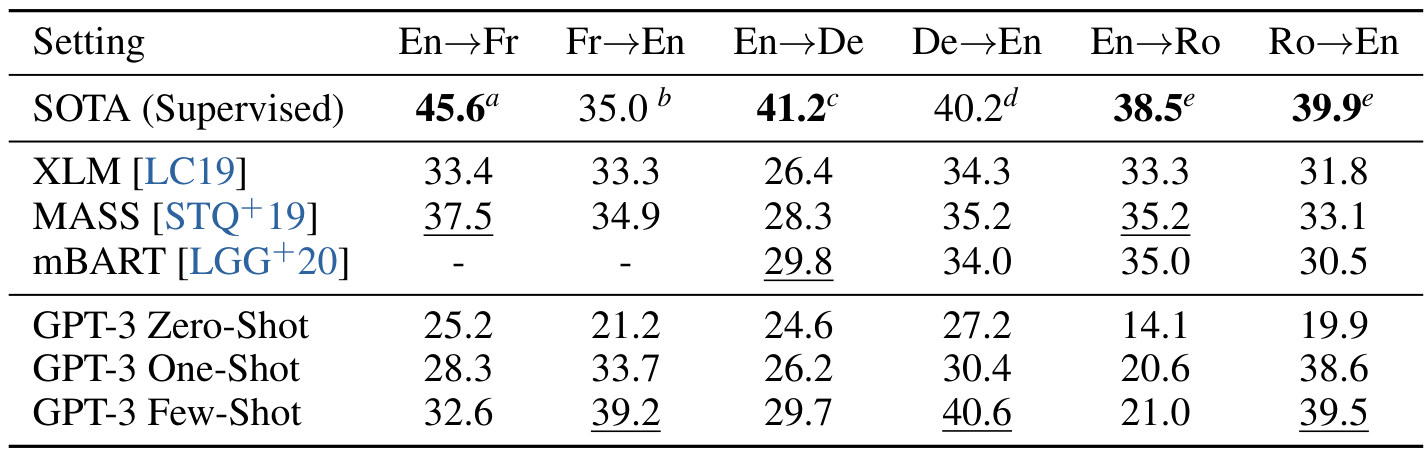
这些数值来自真实论文评价,BLEU不是准确率。本课未重跑模型,也未将此结果改写成A/B任务效果。
深入解释与来源
示例的作用,要在完整翻译任务上看
这里仅采用GPT-3 Table3.4的175B模型在WMT’14 English→French方向的BLEU:zero-shot25.2、one-shot28.3、few-shot32.6,采用multi-bleu.perl口径。论文设置K=64,并受2048上下文窗口约束,不假定每条输入完整装下64个长句。BLEU不是准确率,7.4分差不能写作准确率提高7.4%。
结果仅支持指定模型、任务、示例与预算条件,不能推广为示例越多越好或超越全部监督模型。
来源与材料身份
- 原始入口:Table3.4,PDF物理第15页;§3.3物理第14页说明1/64个成对示例;Appendix H物理第63页En→Fr14的K=64及175B结果
本页证据与条件
GPT-3 Table3.4原始翻译评测:175B、WMT’14 En→Fr、BLEU;固定参数仅前向。