完整深入材料 · 保留原页与全部停点。回到相关主讲
在这个条件下,做大 ViT 没有换来更好成绩
N13/b0 · 保持 B/16 与 L/16
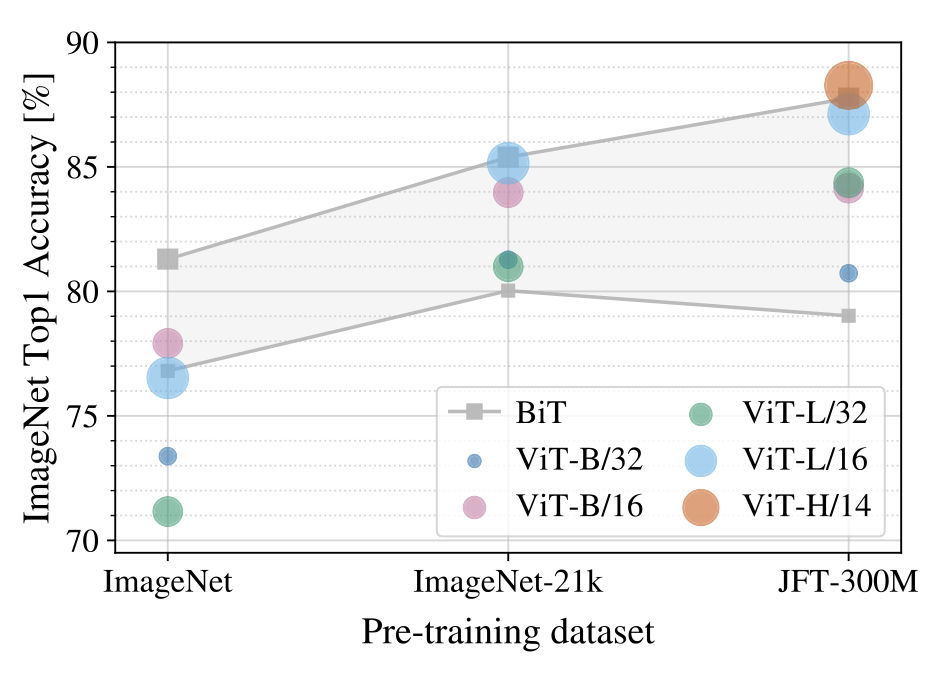
保留上一页已经认清的坐标和图例,现在只看左边 ImageNet 这一列。先找同为16×16像素patch的 B/16 与 L/16;它们仍在同一个 ImageNet 分类指标上比较,先不移到右列。
教师备课:指图与模拟问答
指图与推进 · 不朗读定位左列 B/16 与 L/16,核对三条比较条件。
N13/b1 · 左列大模型更低
L/16 ↓ B/16同样用 16×16 像素的 patch,L 比 B 大,但它在这里的准确率反而更低。
教师备课:指图与模拟问答
指图与推进 · 不朗读沿 L/16↓B/16 标记比较两点高低,维持同一评测口径。
N13/b2 · 与 BiT 范围比较
L/16 ↓ B/16灰色的卷积基线也有明显优势。如果我们只做这一组实验,然后立刻决定未来几年的结构方向,很容易得出“ViT 做大没什么用”的判断。这个判断对眼前条件并非毫无根据。模型更大意味着有更多可调整的自由度,但训练是否能把它们用起来,还受材料、任务、正则化和优化过程影响。这里的观察只是告诉我们:在这一套实验条件下,增加模型大小没有兑现为更好的下游结果。我们还没有从一张图里识别出所有原因。现在保留 B/16 和 L/16 的身份,也保留同一个测试指标,只把视线移向扩大后的预训练条件。问题不是要替大模型找借口,而是判断它的表现曲线:小条件下没有用起来的容量,换一套实际训练条件以后,会不会变得有价值?下一页用相同的两个颜色追过去。
教师备课:指图与模拟问答
指图与推进 · 不朗读再看灰色 BiT 范围;提出条件化判断,沿相同颜色转到下一页右列。
本页证据与条件
ViT v2 · Figure 3 · ImageNet 微调评测;数据集数量与组成同时变化