视觉里的规模扩展:结构、材料与学习任务怎样配合
在开场,我们把 Transformer 看成两类信息的共同计算场所:训练形成的参数提供可复用的结构,当前输入形成的 K/V 让这次计算读取具体材料。这个视角帮助解释机制,却还没有证明加大训练投入一定有用。视觉段因此接入两项实证:ViT 检查架构的排序怎样随训练条件变化,MAE 检查从图片自身构造的任务能否让更大模型获得收益。
这两个问题和后面的 Chinchilla 预算问题不同。这里问“扩大条件以后会怎样”;后面问“计算预算已经给定,怎样分给模型与训练数据”。将二者混成一句“越大越好”,会丢掉选择条件。
先把图像接成序列
图像可以切成固定大小的块。每块像素展平、线性投影为向量,再加位置信息,就得到 Transformer 可处理的向量序列。ViT 使用这一输入组织方式,其 encoder 仍包含 self-attention 与 MLP。它保留的是熟悉的计算接口,不意味着图像和语言的任务、数据分布或所需先验完全相同。
课堂校车的 4×4 网格是教学示意。ViT-B/16 中的 16 表示 patch 边长;在 224×224 图片上,每边有14块,合计196块,不是16块。课堂重复使用 MAE 原图,是为了让分块与稍后的遮挡任务有共同对象,不能据此声称是 ViT 论文的实验样本。
ViT:不要只依据小规模条件选架构
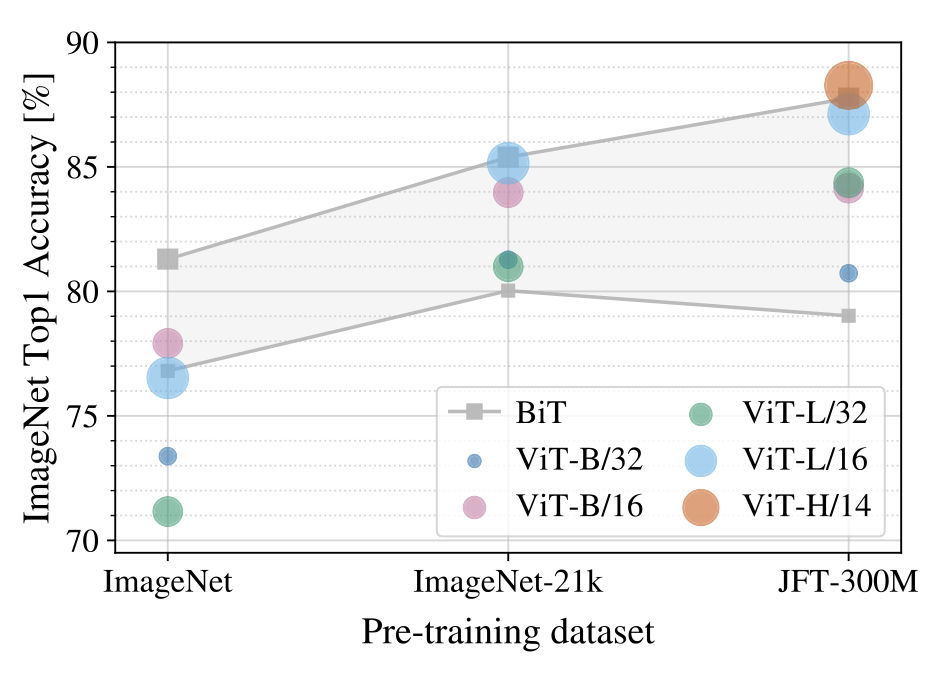
本图里的 ViT 先在指定数据集上做带标签的监督分类预训练,再把参数带到 ImageNet 目标任务进行带标签微调与评价。预训练指流程中的位置,本身不等于无标签;后面 MAE 才改变训练目标。
Figure 3 的纵轴是预训练并微调后的 ImageNet top-1 准确率,单位是百分比;横轴为 ImageNet、ImageNet-21k 与 JFT-300M,不是纯粹的样本量坐标。灰色范围来自不同规模的 BiT(ResNet)模型,彩色圆点来自 ViT 变体。
在 ImageNet 一列,卷积基线整体更有优势,同为 /16 的 ViT-L 还低于 ViT-B;在 JFT-300M 一列,两者排序反转,最大的 ViT 超过图中 BiT 范围。这是选择方法时值得保留的信息:一种结构在小数据条件下的表现,不必然代表扩展后能达到的位置。
但图上三种数据集同时改变数量和组成,小数据设置还采用了相应正则化选择。因此,图不能把收益唯一分给某个变量。原图保留而不目测重造精确点值,也是为了避免把视觉趋势加工成不存在的精确数据。
更受控的子集比较,与不同的评测协议
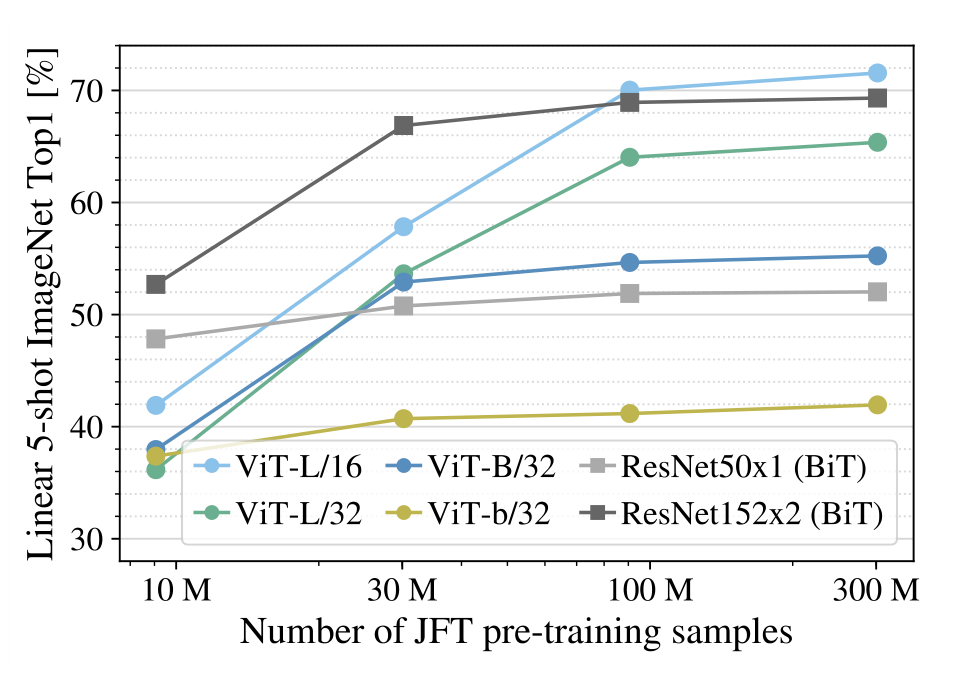
Figure 4 将数据来源固定到 JFT 的随机子集,实际比较 9M、30M、90M 和完整 JFT。图使用对数横轴;纵轴为线性5-shot ImageNet准确率。这里会在冻结表征上拟合一个线性分类器,且采用早停、报告训练期间最佳验证结果。它不是把五条文字示例放进模型上下文,也不是后面要讲的 LLM ICL。
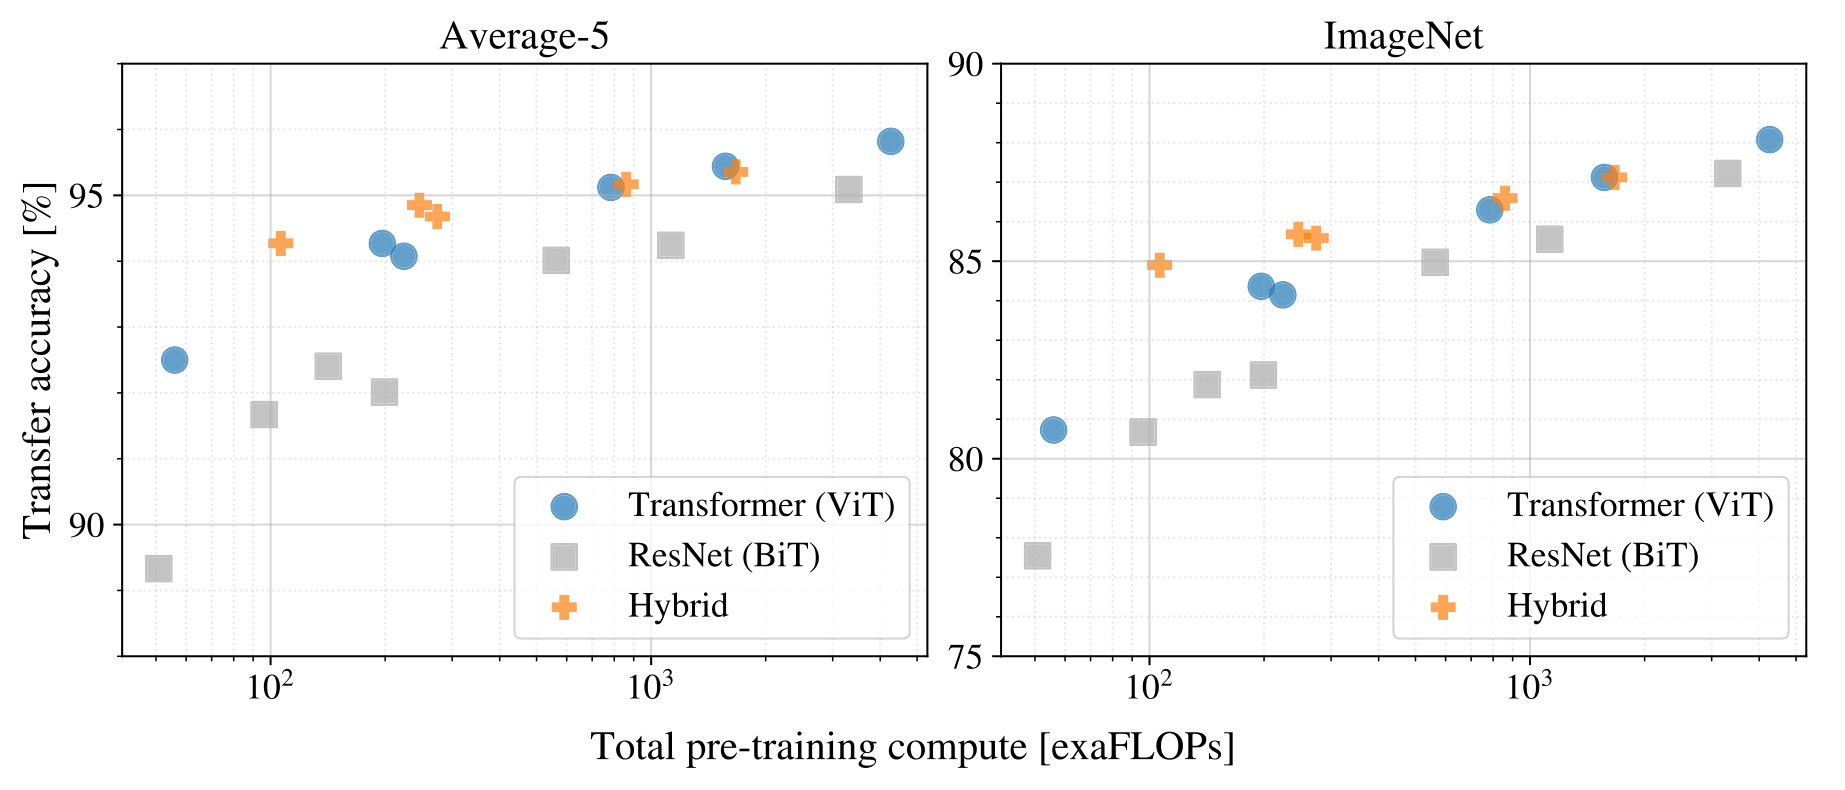
Figure 5 再把问题换成计算预算:横轴是预训练计算 exaFLOPs,纵轴分别是 Average-5 和 ImageNet 迁移准确率。比较范围内 ViT 的表现支持其扩展潜力;这个图不授权把计算量直接换成墙钟时间、费用或所有架构的普遍效率排名。
保留反证:卷积也能扩展
ConvNeXt 通过调整卷积结构和训练配方,在更大模型、更多预训练数据下仍然取得收益。其 Table 1 的 ImageNet-22K 预训练部分,在224分辨率下给出 ConvNeXt-T/S/B/L/XL 的 ImageNet-1K top-1 结果82.9/84.6/85.8/86.6/87.0。这个系列包含不同容量模型,不能当成只改变单个变量的严格因果隔离;但它足以推翻“卷积本质不能 scaling”的断言。
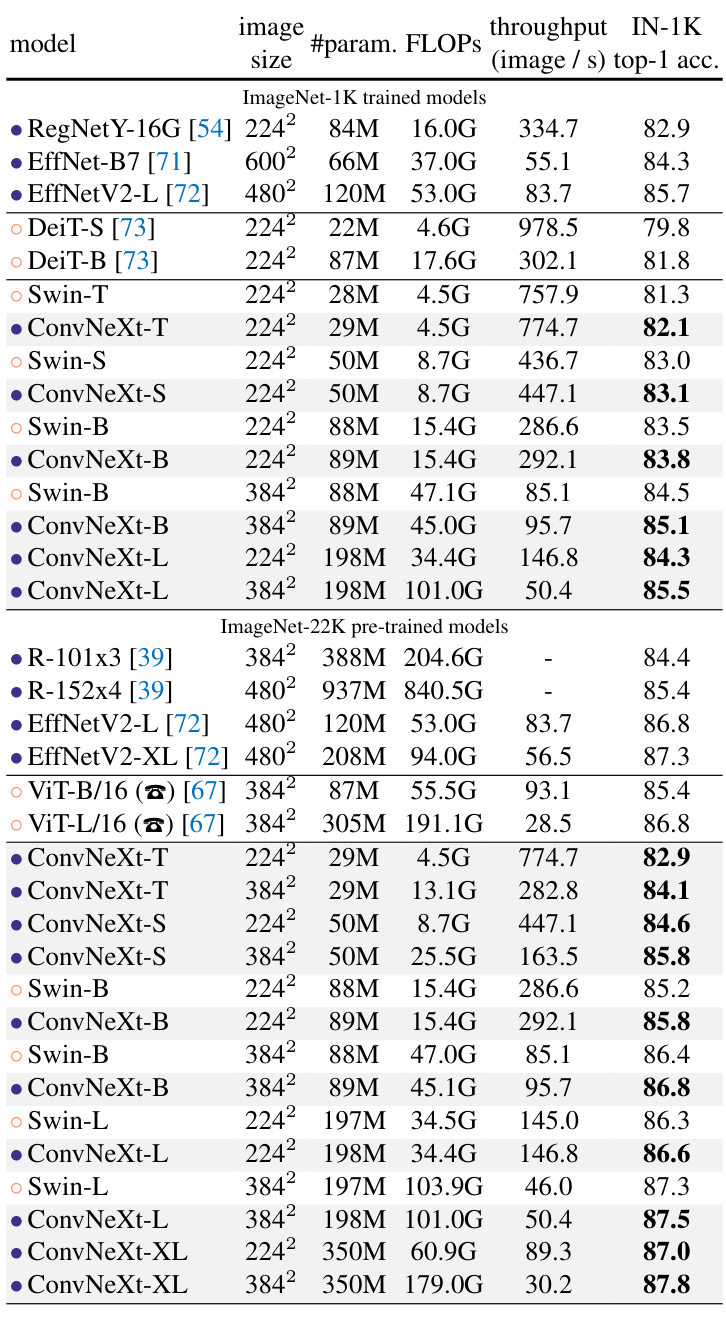
因此,课堂选择 ViT 来讲 Transformer 的扩展证据,并不是把结构史写成唯一胜者的必然道路。我们关心的是在明确条件下怎样做研究判断。
MAE:原始图片怎样持续提供训练目标
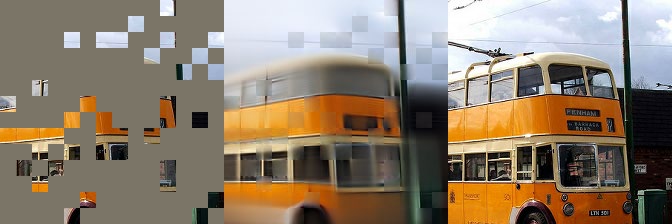
左侧给模型可见的局部,中间是论文报告的重建,右侧是原图。这个展示使用80%遮挡,只见196个patch中的39个。图的条件需要与常见的75%训练遮挡例子分开记。
监督不必来自人工逐张写好的问答:遮挡以前就拥有完整图片,被遮部分的像素能够提供预测目标。重建与目标的差异形成训练误差。大编码器只处理可见patch,较轻的解码器加入mask token后恢复缺失内容,因此任务设计也影响运行成本。
重建不是原图的复印。车窗和车身细节存在可见误差,且论文没有将可见原图块覆盖回模型重建,本课保留同样的原始像素。这样才能分清模型实际给出了什么。单个重建样例提供直观机制,不能代替独立任务评测。
从重建转到分类,保留与替换什么
重建以后,带去分类的是训练过的 encoder。重建 decoder 被丢弃,分类时把完整图片的全部 patch 送进保留的 encoder,接上分类头,再用带标签训练图片微调;最后在独立验证集评价分类结果。完整路径是“完整图像/全部 patch→保留 encoder→分类头→带标签微调→独立分类评价”。课堂先前看过原图,不意味着遮挡重建那一次的模型输入也看过全图;而分类阶段确实改为完整输入。
所以“图补得像不像”与“分类能做多好”是两个评价。不能只删掉 decoder 就直接跳出准确率,更不能把某张重建图当成下游分类成绩。
同一图片池,更大模型能否获得更多收益
| ImageNet-1K,224×224,top-1准确率(%) | ViT-B/16 | ViT-L/16 | ViT-H/14 |
|---|---|---|---|
| 从头监督训练,同文实现 | 82.3 | 82.6 | 83.1 |
| MAE预训练后微调 | 83.6 | 85.9 | 86.9 |
| 差值,百分点 | 1.3 | 3.3 | 3.8 |
表值来自 MAE Table 3。模型更大时,MAE后微调相对该文监督实现的差值也更大。两组用同一ImageNet-1K训练图片池,分类成绩由独立验证集取得,但MAE增加1600 epoch预训练,之后再微调,属于非等计算比较。不能把差值全归因于一个结构改动,也不能声称免费提升。论文还有ViT-H在448分辨率下87.8的结果,因条件不同没有放入本表。
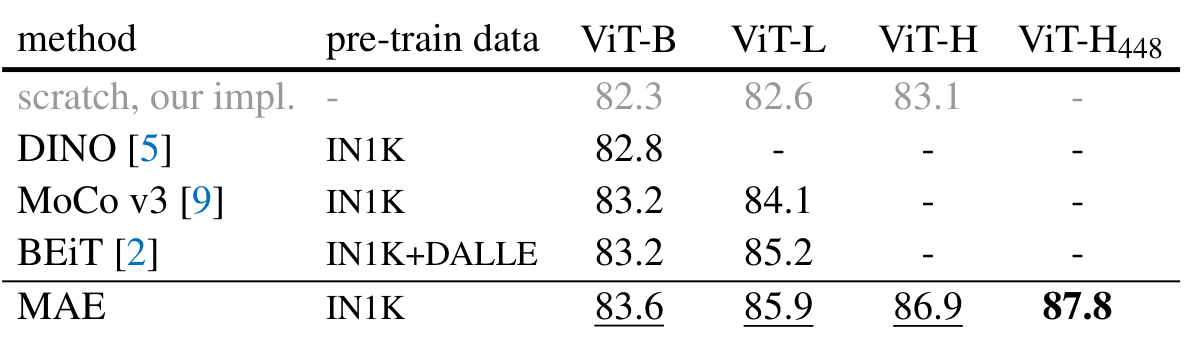
这里回到一个比“模型更大”更完整的结论:结构提供潜力,任务组织和训练投入使潜力得到利用;是否有用需要适当的下游评测。这既不是 attention 记忆容量测试,也不是模型已经理解所有视觉关系的证明。
从任务收益追到内部机制,再回到计算
分类成绩说明训练后的表示能够帮助新任务,却没有告诉我们网络内部正在区分什么。接下来换一组研究对象,从 InceptionV1 中同时响应猫和汽车的单元出发,观察共同结构、训练轨迹和可检验的解释。Goodfire 的这些案例不是对前面 MAE checkpoint 的内部审计,而是另一组模型的机制证据。
从猫和汽车读内部区分之后,再把问题放回 MAE encoder 的可见 patch:向量排成 X,共享参数 W 怎样处理这些输入,哪些位置可以并行,计算、保存和搬运各受什么约束。
最后把预测对象换为文字。next-token prediction 从原始序列构造前缀和目标,本课沿 A/B 记录完成概率、损失和参数更新,再用关系任务与真实迁移评测检查学到了什么。图像重建提供了理解训练闭环的入口;语言模型是否可靠处理关系,仍需要它自己的证据。
课堂入口与一级来源
- 图像成为序列 · ViT实验条件 · 扩展对照 · MAE重建 · 分类迁移 · 分类比较
- Dosovitskiy 等,An Image is Worth 16×16 Words,固定v2,Figure 1(p3)、Figure 3/4/5(p7),§3.1、§4.3–4.4。
- He 等,Masked Autoencoders Are Scalable Vision Learners,固定v3,Figure 2(p2)、Table 3/Figure 8(p7);MAE作者归属不与ViT或ConvNeXt混写。
- Liu 等,A ConvNet for the 2020s,固定v2,Table 1(p7),§3.1–3.2。
以上为公开论文结果、原图裁取和课堂重绘。本次没有重训这些模型;校车图不是新推理输出。