小数据上的赢家,扩大训练后还一样吗?
X02/b0 · 先看 ImageNet
横轴:真实预训练数据集
先看 ImageNet
小数据上的排序,
大模型并不占优
灰色区域是不同规模 BiT 卷积模型的范围。
ViT-L/16 低于 ViT-B/16。
灰色方点/阴影:BiT(ResNet)
彩色圆点:不同规模的 ViT
Dosovitskiy 等 · ViT Figure 3 · 预训练后在 ImageNet 微调;数据集的数量与组成都变化,非只改变样本数的实验。
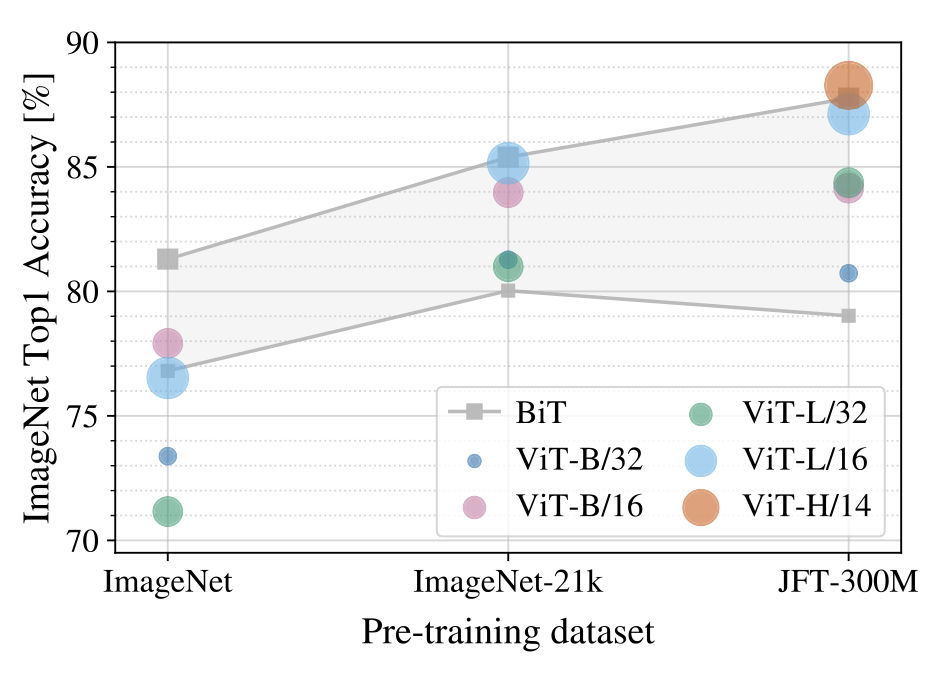
先只看左边 ImageNet 这一列。纵轴是迁移并微调后的 ImageNet 准确率,越高越好;灰色区域是不同规模 BiT 卷积模型的范围。这里卷积基线整体更有优势。再找同样用十六像素 patch 的两个圆点:较大的 ViT-L/16 反而低于 ViT-B/16。如果我们只在这个条件下选架构,很容易认为继续做大 ViT 没有价值。
教师备课:指图与模拟问答
指图与推进 · 不朗读指原图左列金框,先读灰色范围,再对照 B/16 与 L/16 图例。
X02/b1 · 移到 JFT-300M
横轴:真实预训练数据集
再看 JFT-300M
扩大训练以后,
排序变了
较大的 ViT 获得明显收益;
ViT-H/14 超过图中 BiT 范围。
灰色方点/阴影:BiT(ResNet)
彩色圆点:不同规模的 ViT
Dosovitskiy 等 · ViT Figure 3 · 预训练后在 ImageNet 微调;数据集的数量与组成都变化,非只改变样本数的实验。
现在不换模型定义,把视线移到右侧 JFT-300M。较大的 ViT 得到明显收益,ViT-H/14 已经超过图中卷积基线的范围。这个变化告诉我们:在较小条件下没有兑现的容量,可能在扩大训练以后变得有用。不过横轴是不同数据集,数量和组成一起变了,我们不能把这张图说成只增加样本数的干净实验。
教师备课:指图与模拟问答
指图与推进 · 不朗读把焦点移到右列,指出最大 ViT 与 BiT 上沿。
X02/b2 · 读出判断条件
横轴:真实预训练数据集
再比较同为 /16 的 B 与 L
扩展条件,
会改变架构选择
ViT-L/16 从低于 B/16,
到高于 B/16。
卷积也能从现代结构与训练配方中受益。
Dosovitskiy 等 · ViT Figure 3 · 预训练后在 ImageNet 微调;数据集的数量与组成都变化,非只改变样本数的实验。
最后再看同为十六像素 patch 的 B 和 L:在 ImageNet 上,大模型落后;在 JFT 上,大模型领先。所以选架构要看它在我们准备投入的条件下能走多远,不只看小实验当下的赢家。也别把这个故事讲成卷积不能扩展。后来的 ConvNeXt 表明,现代结构和训练配方同样能让卷积受益。这里真正需要保留的是判断方法:扩大结构和训练条件,再用清楚的任务指标看是否兑现。
教师备课:指图与模拟问答
指图与推进 · 不朗读保留全图;沿 B/16、L/16 左右两列各指一次,再转向学习信号。
补充推导、边界与来源
这张图来自 ViT 原论文 Figure 3。纵轴是预训练后微调所得的 ImageNet top-1 准确率(百分比),横轴依次为 ImageNet、ImageNet-21k、JFT-300M 三种真实预训练数据集;灰色阴影与方点表示不同规模的 BiT(ResNet)基线,彩色圆点表示 ViT 变体。
先读 ImageNet 一列:卷积基线整体更有优势,且同为 16 像素 patch 时,ViT-L/16 低于 ViT-B/16。再看 JFT-300M 一列,较大 ViT 的收益明显,ViT-H/14 超过图中的 BiT 范围。对同为 /16 的 B 与 L,排序也发生反转。这里支持的是“架构比较受训练条件影响”,而不是模型更大就总会更好。
横轴没有被改为纯数据量:三种数据集的数量与组成都变化。论文还对小数据条件调整了正则化,因此 Figure 3 不能单独识别每个因素的因果效应。课堂保留原坐标与点,不按肉眼估值重造数字。
进一步分开看:样本量与计算量
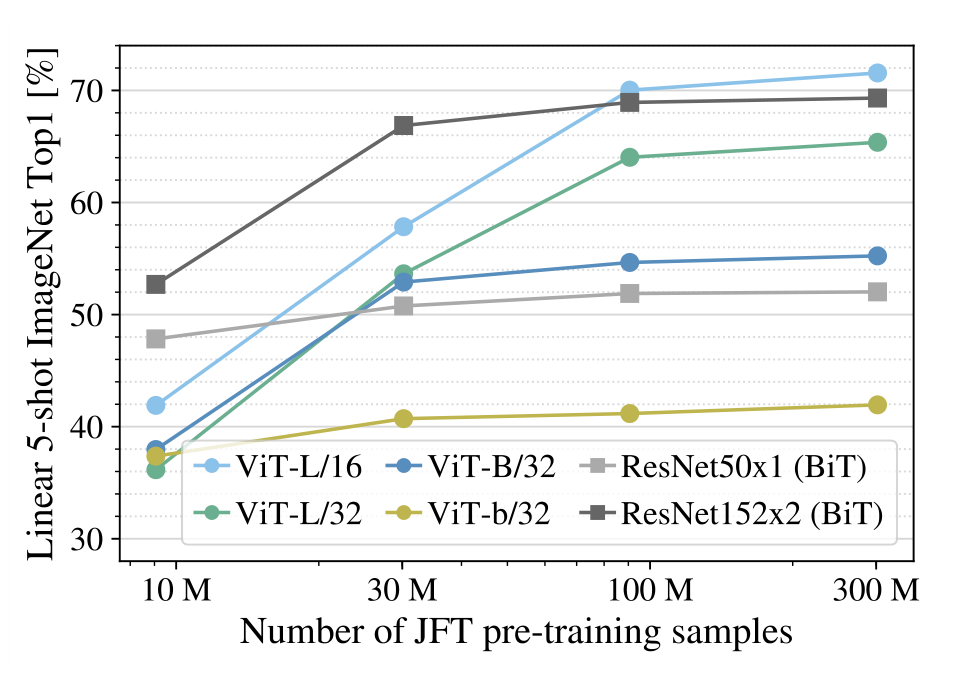
Figure 4 在 JFT 随机子集上比较;样本数为 9M、30M、90M 与完整 JFT,图轴用对数尺度标出近邻刻度。其纵轴是线性 5-shot ImageNet 准确率:在冻结表征上拟合线性分类器,包含任务训练,不是后面 LLM 的 in-context learning。论文采用早停并报告训练期间最佳验证结果。这组对照较好地固定了数据来源,但仍须保留评测协议。
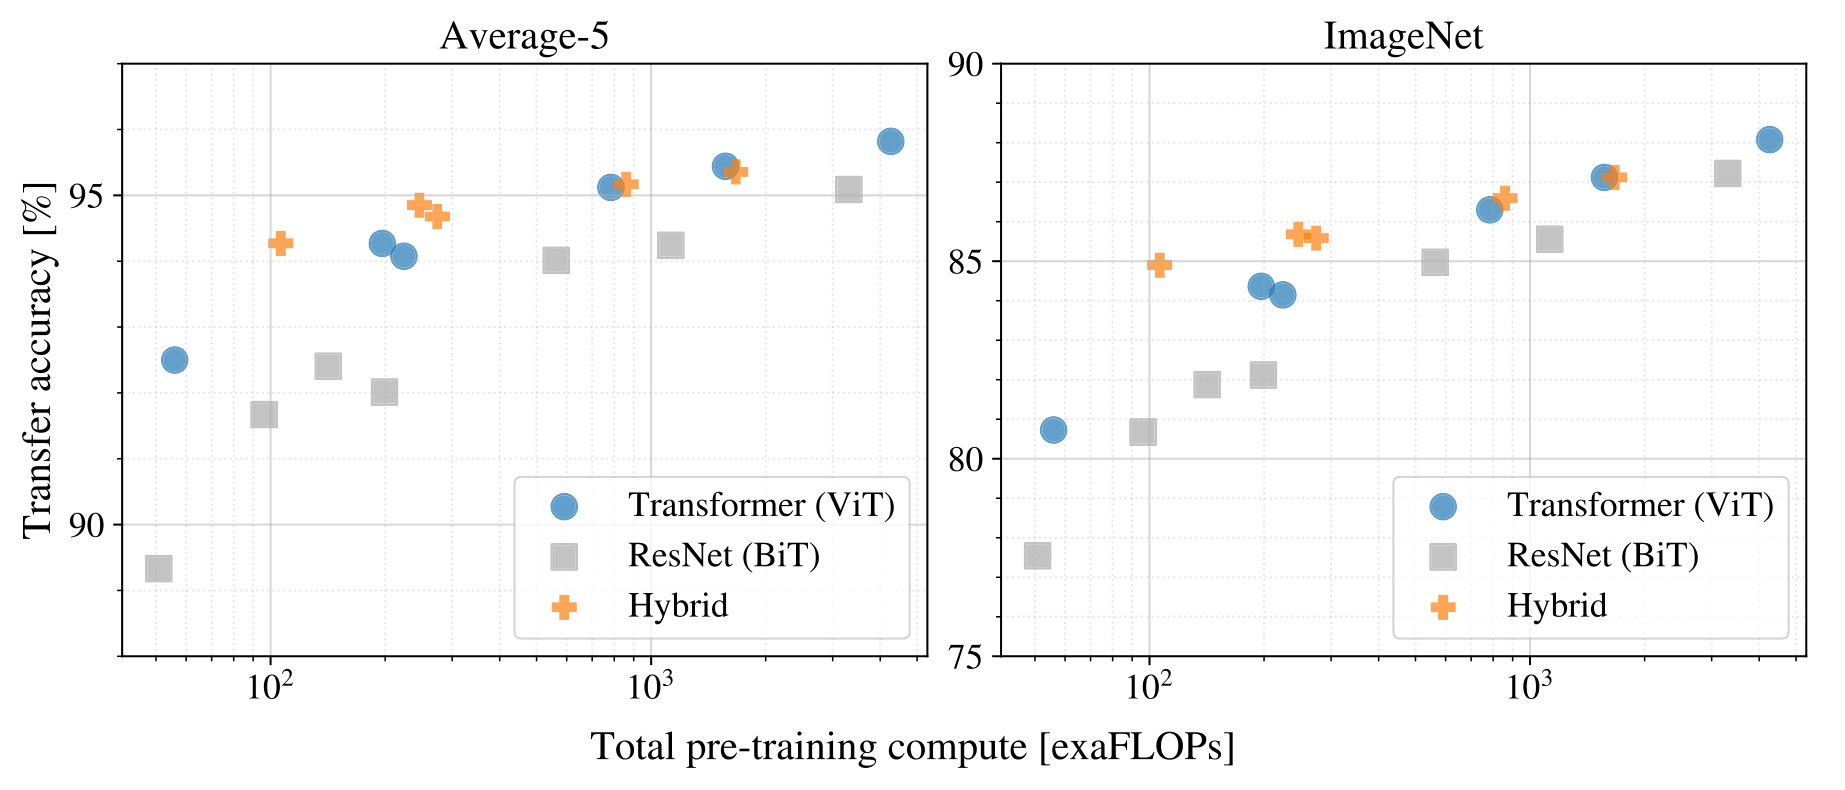
Figure 5 将横轴换成预训练计算 exaFLOPs,分别展示 Average-5 和 ImageNet 迁移准确率;它回答相近计算预算下的比较,不能与 Figure 3 的数据集横轴互换。课堂不把这些观测外推成所有模型、所有预算的排名。
为什么这不是“CNN 不能扩展”的证明
ConvNeXt 原论文 Table 1 与 §3.2 给出采用现代结构与训练配方的卷积模型在更大模型和预训练数据下取得收益的结果。它足以反驳“卷积本质不能 scaling”的说法。我们的结论仍是:把结构、数据、任务、训练方法和资源放在明确的比较条件下判断。
本页证据与条件
ViT 2010.11929v2 Figure 3(p7);预训练后 ImageNet 微调;原图裁取,非本课新运行