更大的模型,需要能用好它的任务
X04/b0 · 先看监督训练
ImageNet-1K · 输入分辨率 224 × 224 · top-1 准确率(%)
监督训练从头训练 · 同文实现
MAE Table 3 重绘 · 两组使用同一图片池,非等训练计算比较;MAE 额外预训练 1600 epoch。差值为百分点。
刚才我们看到重建任务怎样产生。现在换成一个可比较的下游结果:ImageNet-1K 的分类准确率。三个横轴位置分别是 B、L、H 三种模型,都是二百二十四分辨率。先只看从头监督训练,结果是八十二点三、八十二点六、八十三点一。模型做大了,但这组训练方式下,改善并不大。
教师备课:指图与模拟问答
指图与推进 · 不朗读先读灰线及三个精确值,指明分类指标。
X04/b1 · 加入 MAE 后微调
ImageNet-1K · 输入分辨率 224 × 224 · top-1 准确率(%)
监督训练从头训练 · 同文实现
MAE 后微调先重建,再学习分类
MAE Table 3 重绘 · 两组使用同一图片池,非等训练计算比较;MAE 额外预训练 1600 epoch。差值为百分点。
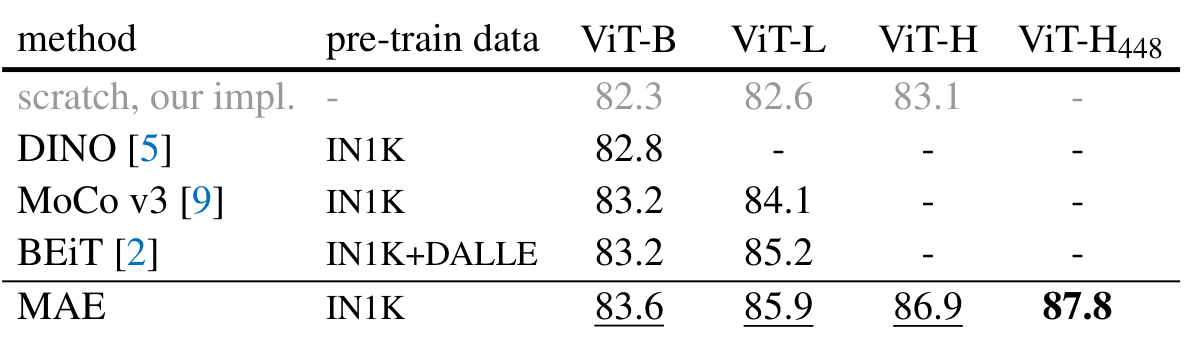
再把 MAE 预训练后微调的结果加上来:八十三点六、八十五点九、八十六点九。两组用同一图片池,但蓝线先做了一千六百轮重建预训练,再进行分类微调,所以训练计算并不相等。我们不能把它讲成不付出成本就提高了能力。它显示的是,换成能够利用原始材料的训练过程,大模型的潜能更能表现出来。
教师备课:指图与模拟问答
指图与推进 · 不朗读显出蓝线与图例,口述非等计算条件。
X04/b2 · 读出模型与任务的配合
ImageNet-1K · 输入分辨率 224 × 224 · top-1 准确率(%)
监督训练从头训练 · 同文实现
MAE 后微调先重建,再学习分类
更大模型的潜能,
需要训练任务来兑现。
MAE Table 3 重绘 · 两组使用同一图片池,非等训练计算比较;MAE 额外预训练 1600 epoch。差值为百分点。
三个差值分别是一点三、三点三、三点八个百分点。这次比较里,大模型从预训练中获得了更多收益。于是我们有一条更完整的判断:结构能做大还不够,还要有能用好容量的任务与训练投入。到这里,结构、数据和学习信号已经接起来。下一步很实际:这些计算必须放在硬件上运行;能并行,是否就意味着算得起?
教师备课:指图与模拟问答
指图与推进 · 不朗读显出差值,最后指向下一段计算与硬件问题。
补充推导、边界与来源
本页将 MAE Table 3 的两行重绘为比较图。模型依次为 ViT-B/16、ViT-L/16、ViT-H/14;指标统一为 ImageNet-1K 的 top-1 准确率(%),输入分辨率统一为 224×224。横轴是模型类别,不是等距离的参数数量。
| 训练方式 | ViT-B/16 | ViT-L/16 | ViT-H/14 |
|---|---|---|---|
| 监督训练,从头训练,同文实现 | 82.3 | 82.6 | 83.1 |
| MAE 预训练后微调 | 83.6 | 85.9 | 86.9 |
| 差值,百分点 | 1.3 | 3.3 | 3.8 |
先看监督组,模型变大带来的改善有限;加入 MAE 预训练后,L 与 H 得到更大的提升。两组使用同一 ImageNet-1K 图片池,但这不是等计算比较:MAE 多了 1600 epoch 预训练,之后再端到端微调。不能把所有提升唯一归因于某一个结构变化,也不能说这是“免费”增加能力。论文另报告 ViT-H 在 448 分辨率下的 87.8;那个条件没有混入本图。
这里的观察接回前一页:可以从原始材料持续构造训练任务,但任务应当让网络形成在目标使用场景中有用的表示。我们用分类成绩检验了这个局部问题;它不等价于证明 attention 的记忆容量,也不是 Transformer 历史上唯一可行的证明。下一段暂时保留模型、材料和任务,转向使这一训练能够运行的计算、存储与搬运。
MAE 固定 v3 原文,Table 3/Figure 8,物理第7页。数值与条件据原文;图和差值为本课可复算重绘。
本页证据与条件
MAE 2111.06377v3 Table 3(p7)重绘;ImageNet-1K,224;同图片池、非等训练计算