完整深入材料 · 保留原页与全部停点。回到相关主讲
示例的作用,要在完整翻译任务上看
N35/b0 · 先定义翻译测量
现在看真正的任务结果。这里测的不是刚才两个单词,而是完整句子的英语到法语翻译。任务卡列明:GPT-3 论文 Table 3.4,同一个一千七百五十亿参数模型,WMT 二零一四英译法,指标是 BLEU。BLEU 是按译文和参考译文的匹配等规则得到的分数,不是句子答对的百分比。先认清这个测量对象,再读三种输入条件。
教师备课:指图与模拟问答
指图与推进 · 不朗读只读任务卡:模型规模、英译法方向、测试集和 BLEU;不提前指尚未显示的柱。
N35/b1 · 读取同模型三条件
零示例是二十五点二,一个示例是二十八点三,少样例设置是三十二点六。论文这项少样例设置将示例数设为六十四,并受上下文长度限制;不能假定每条输入都完整装下六十四个长句,测试时仍不更新权重。
这组比较支持的是:对这个模型、这个翻译方向和这些评测条件,当前上下文中的任务示例确实改变了总体表现。它不是“全体翻译任务平均”,也不是把单词fromage猜对一次就得到的分数。我们把输入机制与任务结果分开看,才知道前面那张图解释了什么,这张表又补了什么证据。
教师备课:指图与模拟问答
指图与推进 · 不朗读推进,依次读三根柱与示例数,指 K=64 的设置;同时说明同模型参数固定。
N35/b2 · 限定证据范围
这里还有一个实际代价:示例需要选择,放入上下文还会占用长度与计算;不同任务也不保证例子越多越好。所以,遇到自己的科研任务,应该把提示形式、样例数量和评价标准一起试,而不是背住一个通用示例数。现在回到我们的AB实验,不借助法语知识,看看一个示例究竟能把什么要求告诉模型。
进一步解释
采用 GPT-3 Table 3.4 的 multi-bleu.perl 口径。K=64 是论文的设置并受 2048 上下文窗口约束,不意味着每条输入完整装下 64 个长句。25.2→32.6 是 BLEU 分数变化,不能称准确率提高 7.4%。
教师备课:指图与模拟问答
指图与推进 · 不朗读推进,指单一任务与上下文窗口条件;讲完回到 AB 记录,说明接下来换的是任务而不是模型结构。
补充推导、边界与来源
这里仅采用GPT-3 Table3.4的175B模型在WMT’14 English→French方向的BLEU:zero-shot25.2、one-shot28.3、few-shot32.6,采用multi-bleu.perl口径。论文设置K=64,并受2048上下文窗口约束,不假定每条输入完整装下64个长句。BLEU不是准确率,7.4分差不能写作准确率提高7.4%。
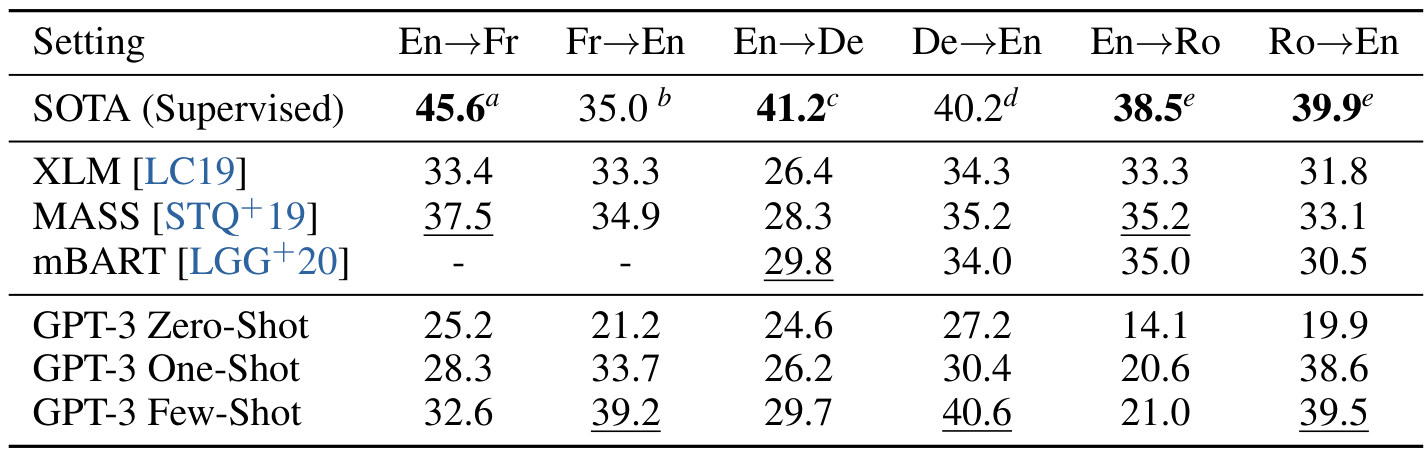
结果仅支持指定模型、任务、示例与预算条件,不能推广为示例越多越好或超越全部监督模型。
来源与材料身份
- 原始入口:Table3.4,PDF物理第15页;§3.3物理第14页说明1/64个成对示例;Appendix H物理第63页En→Fr14的K=64及175B结果
本页证据与条件
GPT-3 · Table 3.4 · 175B · WMT’14 En→Fr · BLEU