完整深入材料 · 保留原页与全部停点。回到相关主讲
一个神经元的负侧,可能藏着真正的工作
本页问题
刚才读图时,我们已经看见促进和抑制不是同一件事。现在还要区分:神经元取值的正负、门控乘积的来源,以及最终对输出的作用。
GF20/b0 · Santa 在负极
这个例子仍是 Qwen3-32B。十二月二十五日,饼干和牛奶没了,烟囱下有煤灰,夜里传来雪橇铃声。图里的语义分组并不由我们自己添出来,节点来自原文的神经元分组。现在只关注两框:Santa lore 的负极有五个,Santa Claus comes next 的负极有三个。它们工作时是强负值,但这不等于它们在否认圣诞老人;还要看下游怎样使用这个方向。
教师备课:指图与模拟问答
指图与推进 · 不朗读从输入线索进入右侧图,定位标有 negative poles 的五个与三个单元。
本态来源与条件
Goodfire · double-negative-example · 原文实验/图数据;据原图重排
GF20/b1 · 对照删除:标签和机制的差别
作者删掉刚才这八个负极单元,Santa 的概率降到零点零五九,回答变成家里的宠物;同层同数量随机删,仍约零点九九七。只按自动标签找出二十个写着 Santa 或 Christmas 的单元去删,概率却仍有百分之七十六。后一个不是等数量对照,却揭示了找对象的方法会改变你看见什么。一个正侧标签并不是这个单元的完整说明书。
进一步解释
匹配随机比较是 8 个对 8 个,并按层匹配;20 个标签单元是另一实验。
教师备课:指图与模拟问答
指图与推进 · 不朗读先读8单元与随机对照,再读单独列出的20个标签单元结果;不把两行作等预算比较。
本态来源与条件
Goodfire · double-negative-example · 原文实验/图数据;据原图重排
GF20/b2 · 正输出也可能来自双负
但正负问题还没有结束。先暂时离开 Santa 的图,打开现代 MLP 常见的 SwiGLU 通道。输出是 SiLU 门控因子乘 value。第一行是我们熟悉的正乘正;最后一行却也输出正数。原因是 SiLU 在负区不是严格零,留下一个小负值,再乘一个负的 value,结果翻回正。只把最后乘积从大到小排序,会把这两条产生方式混在一起。
进一步解释
完整式为 a=gσ(g)v。前台四种符号组合是代数关系示意,不是新实验。
教师备课:指图与模拟问答
指图与推进 · 不朗读依次指公式的 g、SiLU(g)、v,再比较符号表第一行与最后一行。
本态来源与条件
Goodfire · double-negative-example · 原文实验/图数据;据原图重排
GF20/b3 · 回到一个具体单元
现在看 Qwen3-32B 的 L1/N20736。只读最强正激活列表,会以为它在看 Colossians 的书名结尾。把 gate 和 value 分开,却发现这组正响应约一,来自负门控乘负 value。另一条 Speak russian 的例子,门控为正,value 为负,输出约负十二点五。更强的负例也围绕俄罗斯或俄语的拼写完成。这里不是靠换一个漂亮名字解决问题,而是改变记录的变量,让两种计算路线分开。
教师备课:指图与模拟问答
指图与推进 · 不朗读读两条原图记录,再指右边负侧例子与“Russia/Russian拼写完成”的候选解释。
本态来源与条件
Goodfire · double-negative-example · 原文实验/图数据;据原图重排
接下来
负侧和门控让我们看到,给一个节点起名字需要理解它怎样计算。带着这个要求,再读一个看似专有名字、实际由通用片段组成的例子。
补充推导、边界与来源
Santa:标签漏掉了什么
研究对象仍是 Qwen3-32B。原轮播的输入写到 12 月 25 日早晨、壁炉旁饼干与牛奶消失、烟囱煤灰和夜间雪橇铃,预测位置位于回答前缀之后。关键单元中,Santa lore 的负极组有 5 个,预测 Santa Claus 的负极组有 3 个。删除这 8 个负极单元后,P(Santa) 约 0.059,回答转向家里的宠物;同层同数量随机删除为 0.997。另一个实验按自动标签删除 20 个标作 Santa/Christmas 的单元,目标概率仍约 76%;这不是与“删 8 个”完全等规模的对照,而是说明只按正侧标签找对象会漏掉关键单元。
负极指单元在这些输入上取很强的负值。它不等于“反对 Santa”。最终贡献还取决于下游读出方向。图中的蓝边表示相反方向贡献,是另一层概念。作者的说法是正侧与负侧都值得看;课堂不把每个负数直接翻译成反事实抑制。
SwiGLU:同一个正输出有两条符号路线
现代 MLP 的一个 SwiGLU 通道写成 $a=\mathrm{SiLU}(g)\,v$,其中 $\mathrm{SiLU}(g)=g\sigma(g)$。$g$ 是门控预激活,$v$ 是 value 分支。$g<0$ 时,SiLU 仍是一个小负数,不会像理想硬门一样变成零;若 $v<0$,两者乘积又为正。
因此四种组合为:$g>0,v>0\Rightarrow a>0$;$g>0,v<0\Rightarrow a<0$;$g<0,v>0\Rightarrow a<0$(门控因子较小);$g<0,v<0\Rightarrow a>0$(双负)。这只是代数分区,不是四种语义的自动分类,也不是输出概率的正负。
原文主图 Qwen3-32B L1/N20736 的 top-positive 列表都出现 Colossians 结尾,正值约 0.98—0.99。分离门控后,这些是小的双负泄漏,而开放门控下的强负例包括 russian、ru 和俄语拼写片段。原表在 Coloss|ians 上给出 $g=-1.2,v=-3.5,a\approx+1.0$;Speak russian 为 $g=+4.4,v=-2.9,a\approx-12.5$。数字来自原图、经四舍五入,非本课构造。这并不意味着所有双负都无意义:作者的全网络消融使多数基准变好、部分推理基准下降,原因尚未深查。
附录的独立审计,不与主文单元混用
Separating the Sign Regimes 中另一例为 Qwen 3.6 35B-A3B,L36/E206/N103。分位抽样 750 个样本,626 个保留 routing;p75—p99 区间的 133 个响应中 131 个为双负,而 p99.99 及以上的 93 个均为双正。每根柱子的分母是该激活分位带中的 replay 数,不是全网络神经元数。原完整图如下,主讲只取其代数机制,审计作为进一步阅读。
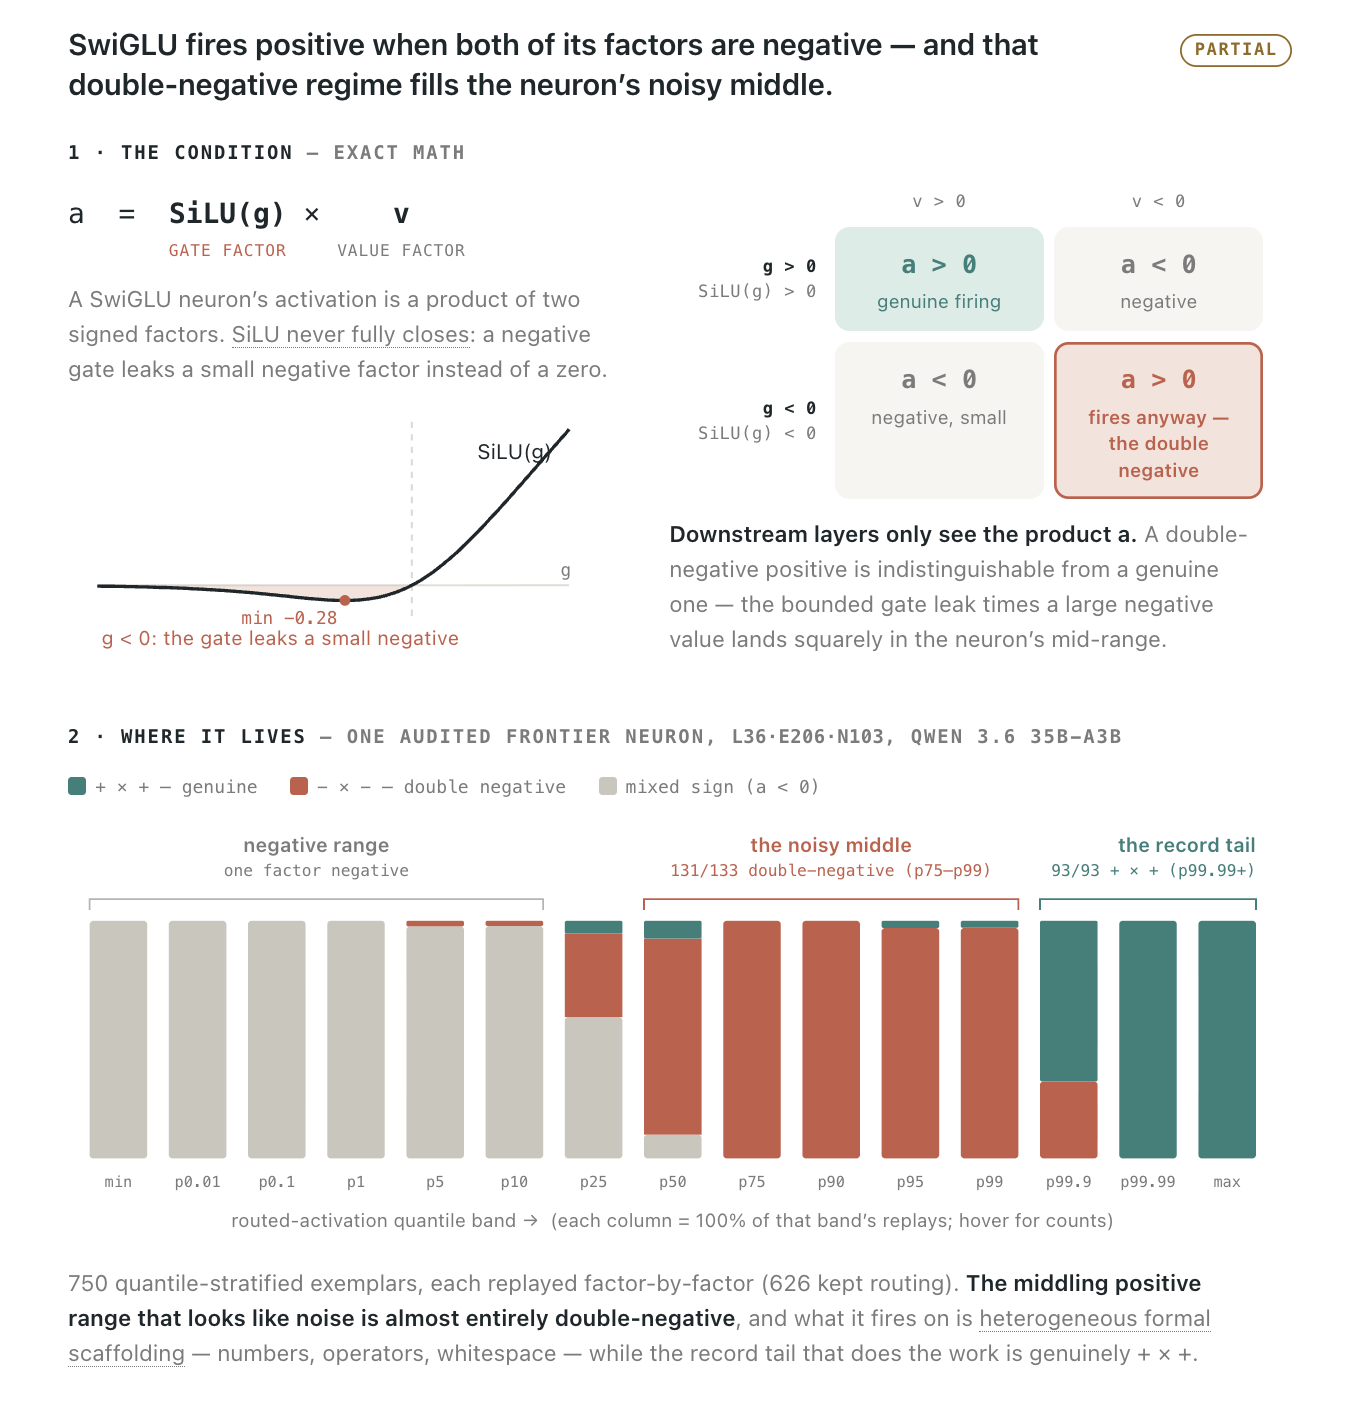
主文还提到约 4% 单元的正激活 top-list 被这类现象占据,这是作者研究样本下的估计,不能当成普适常数。
来源:Nick Cammarata(与 Curt Tigges 合作语言部分),2026,Neural Networks Are Already Clean,Goodfire,double-negative-example。本课呈现原文结果及据原图数据重排的选定状态;没有重新运行模型实验。原作者权利保留。
与本页相关的深入阅读
A04|SwiGLU 的正输出为什么有两种来源
SwiGLU 的输出是 $a=\operatorname{SiLU}(g)\,v$。这里的有效门是经过 SiLU 的值;当门与 value 都为负,乘积仍为正。因此只按乘积排序,可能把双正和双负来源放进同一个正侧列表。Qwen3.6 的 L36/E206/N103 抽样 750 个分位分层例子,626 个保留 routing;p75–p99 中 131/133 为双负,而 p99.99 及以上 93/93 为双正。该局部审计与主文 Qwen3-32B L1/N20736 的示例不是同一个单元。本节四格表只说明符号分区;GF20 展示的 Colossians 与 russian 数值则来自原图的具体测量,两种材料分别读取。
把四个符号区间分开后,观察规则就明确了:
| 有效门 $\operatorname{SiLU}(g)$ | value $v$ | 乘积 $a$ | 需要另外检查什么 |
|---|---|---|---|
| 正 | 正 | 正 | 正侧正常路线的自然输入 |
| 正 | 负 | 负 | value的负侧及后续输出权重 |
| 负 | 正 | 负 | 小的负门是否只留下弱响应 |
| 负 | 负 | 正 | 是否把另一条来源混进正侧列表 |
SiLU满足 $\operatorname{SiLU}(g)=g\sigma(g)$,其中 $\sigma(g)=1/(1+e^{-g})$。负的 $g$ 不会被严格截成零,因此双负乘积可能出现。这里按运算符号分区;最终对某个答案的支持或抑制还取决于后续读出权重,不能从 $a>0$ 直接推出“支持该答案”。
本页证据与条件
Goodfire · double-negative-example · 原文实验/图数据;据原图重排