完整深入材料 · 保留原页与全部停点。回到相关主讲
目标相同,材料让模型反复遇见的关系不同
N30/b0 · 相同目标,不同材料
同一接口:合法前缀 → 实际后续
The trophy would not fit in the suitcase
because it was too big.
在相同设置下,A用时12秒,B用时8秒。未测量内存。
方案 / 数值 / 未测范围times = {'A': 12, 'B': 8}
faster = min(times, key=times.get)
文档① ② ③→过滤 / 抽样 / 重复→实际训练消费
① ② ① ③ ① ②
教学材料示意;非模型生成结果。
刚才那句英文让模型遇到物体与容器的关系。开场的实验记录把数字、方案和没有测量的范围连在一起。代码又要求变量名、数据结构和操作前后保持一致。
教师备课:指图与模拟问答
指图与推进 · 不朗读依次读关系句、实验记录和代码三行;指共同的前缀预测接口。
N30/b1 · 圈出各自依赖
同一接口:合法前缀 → 实际后续
The trophy would not fit in the suitcase
because it was too big.
在相同设置下,A用时12秒,B用时8秒。未测量内存。
方案 / 数值 / 未测范围times = {'A': 12, 'B': 8}
faster = min(times, key=times.get)
文档① ② ③→过滤 / 抽样 / 重复→实际训练消费
① ② ① ③ ① ②
教学材料示意;非模型生成结果。
它们都能组织成“给前缀,预测实际后续”,但这个相同目标面对的内容并不相同。模型要在怎样的材料上减少误差,决定了哪些规律被反复要求,哪些信息可能一直没有机会出现。
教师备课:指图与模拟问答
指图与推进 · 不朗读推进,只指每行新出现的依赖标签;不把标签说成已测得的能力。
N30/b2 · 区分库存和消费
同一接口:合法前缀 → 实际后续
The trophy would not fit in the suitcase
because it was too big.
在相同设置下,A用时12秒,B用时8秒。未测量内存。
方案 / 数值 / 未测范围times = {'A': 12, 'B': 8}
faster = min(times, key=times.get)
文档① ② ③→过滤 / 抽样 / 重复→实际训练消费
① ② ① ③ ① ②
教学材料示意;非模型生成结果。
这时容易把另两件事混起来:我们手里有多少资料,和训练实际消费了多少资料。请看下面的采样带。一份文档可以被多次抽到,另一份虽然已经下载,却可能还没进入这轮训练。过滤、去重、采样比例、顺序和重复次数,都会改变模型真正经历的序列。硬盘里保存的token总量,并不自动等于训练步数消耗的token总量。
这不是说找到一种漂亮配比就一定能造出所需能力。数据质量、模型、计算量和评价任务仍然共同起作用。我们先把因果链说具体:材料经过训练目标产生误差,误差更新参数,参数是否留下可迁移的能力,需要换到有独立评价的任务去检查。接下来先看懂那个评价任务,再看分数,否则一张81.8和75.7的表,对我们只是两个不知道在量什么的数字。
进一步解释
GPT-3 原始语料配比表在本页补充材料中保留。库存、混合抽样权重与实际 300B token 消费对应的近似 epoch 是不同口径;原表四舍五入后的权重合计不强改为 100%。
教师备课:指图与模拟问答
指图与推进 · 不朗读推进,沿库存→过滤/抽样/重复→实际消费的编号文档读一遍;以重复的①说明库存与消费不同。
补充推导、边界与来源
相同的下一项预测目标可以面对物体关系、记录字段或代码操作等不同内容。材料选择改变反复要求模型处理的规律,但不能仅凭材料类别宣布能力已经获得。库存是可用语料;过滤、去重、抽样比例和重复决定实际训练消费。GPT-3训练300B tokens的语料表区分库存、混合权重与近似epoch,原论文四舍五入后的权重合计不强改为100%。
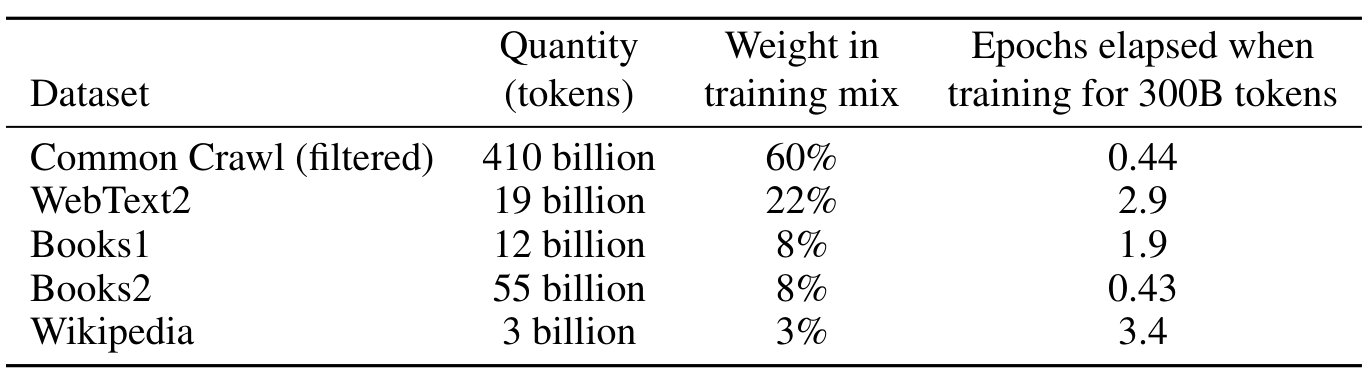
完整数据配比解释 · Goodfire五步局部表示观察。后者是InceptionV1案例,不是LLM能力证明。
来源与材料身份
- 原始入口:§2.2、Table2.2,PDF物理第9页:库存、训练混合权重、消费/重复分别列示
本页证据与条件
教学构造与教师参考;不是模型运行结果