为什么一个单元既响应猫,也响应车?
P05/b0 · 类别上的困惑
Goodfire 作者案例 · 视觉网络 InceptionV1 · 单元 4e:55
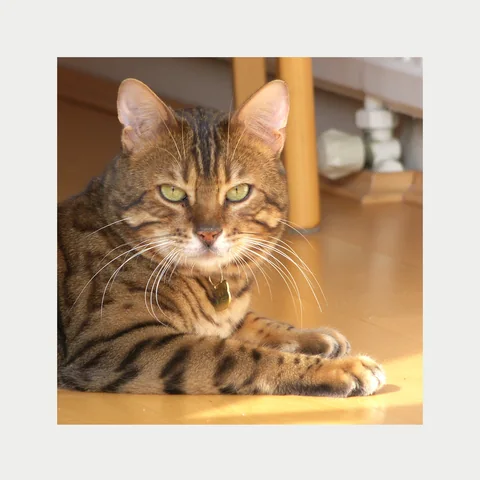
为什么两种类别
会一起出现?
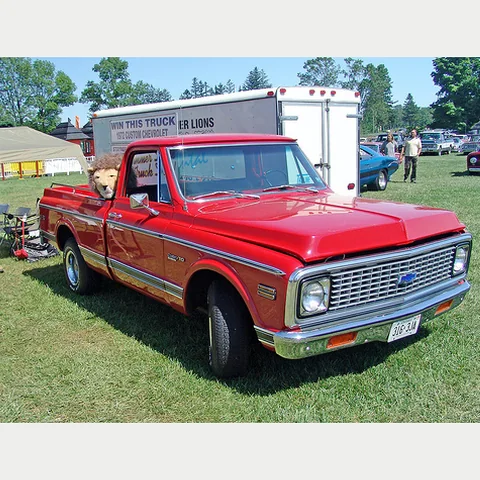
原始照片属于作者选取的响应示例,本图不是激活热图。
这里我们暂时离开语言模型,进入一个视觉网络。来源是Goodfire对InceptionV1的分析,研究对象是编号四e五十五的单元。作者先给出一些猫脸和车头的例子。如果只拿物体类别给它起名,会觉得很奇怪:它到底是认猫,还是认车?这一步我们先不急着给神经元一个概念名字。屏幕上的照片帮助我们认识输入对象,但照片本身不等于激活图。真正要追问的是,网络响应落在什么结构上,而不是这些照片被人分在哪个文件夹。
教师备课:指图与模拟问答
指图与推进 · 不朗读指作者原图中的猫脸与车头;明确原照片与响应证据的身份。
P05/b1 · 移向局部
先把视线从类别名字移到局部形状;下图为原始照片与特征可视化。
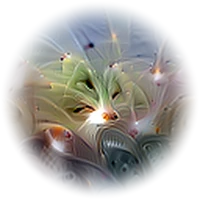
非自然照片,非激活叠图
作者提出的候选解释:共享的 V 形结构。
接下来把视线从整个物体移到局部。猫脸中的某些轮廓,车头中的某些结构,都可能形成尖锐、向两边展开的形状。这样就出现了一个候选解释:这个单元并不需要把猫和车混成同一个物体概念,它可能响应的是二者共享的局部形状。这里要克制一点。人非常擅长在图片里找相似轮廓,如果只是我自己在照片上画一个V,那只能说明我找到了一个解释,不能说明网络确实用了它。所以要继续看作者提供的更直接证据。
教师备课:指图与模拟问答
指图与推进 · 不朗读推进到作者局部或特征图;只对已有证据作读图,不自造热图。
P05/b2 · 查看连接
连接证据:上游形成可组合的结构,下游在不同对象中读取它。
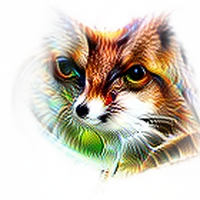
尖鼻
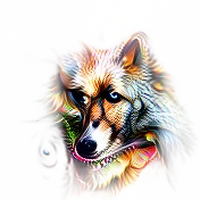
尖耳面部
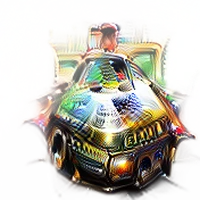
车辆正面
 4e:55尖形/V 形解释
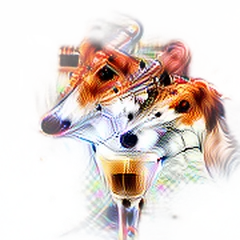
长鼻/V 形杯
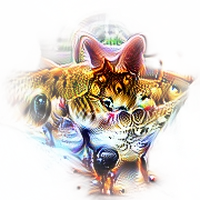
尖形面部
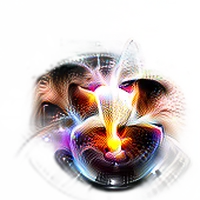
火焰/水柱
连接按作者公开结构重排;箭头不编码权重。图为特征可视化,未报告本课因果干预。
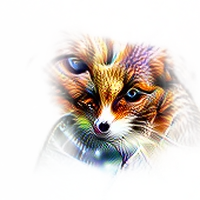
作者接着检查这个单元从上游哪些特征接收输入,又被下游哪些单元读取。为什么这有帮助?因为一个好的解释不应只适合两张精选图片,也应当与网络里的计算关系相容。如果上游形成的边缘和形状能组合成这种结构,而下游又在相应对象中利用它,我们对解释的信心就增加。这里的连接和可视化提供了不同侧面的约束,但并不是只要画出一根线,就已经证明所有输入都遵循同一种因果过程。我们是在逐步排除过于随意的命名。例如作者图中,上游有狐狸吻部、狼脸和车头相关单元,下游有火焰或喷流、郊狼脸、马提尼杯等不同对象。物体名字还是很多样;正因为如此,共同形状这一解释才值得认真检查,而不是直接按一个类别命名。
教师备课:指图与模拟问答
指图与推进 · 不朗读指上游→4e:55→下游的真实图;保持单元编号稳定。
P05/b3 · 比较相反形状
正反响应一起检查解释 · Goodfire “Cars and Animals”
作者特征可视化
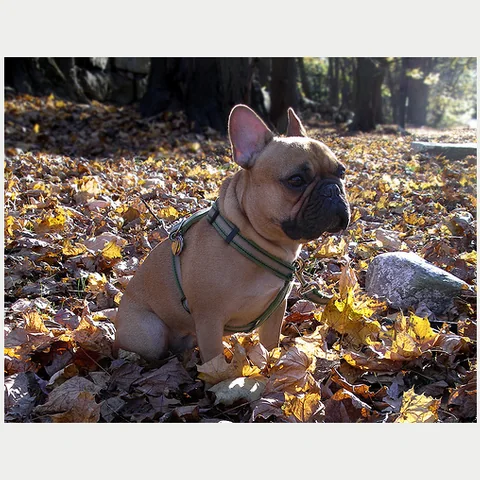
作者选取的自然照片
这是视觉网络的一个解释案例,不等于语言概念都有单个对应神经元。
再看相反的一侧。作者报告,尖形对这个单元提供正向响应,较圆的结构提供负向响应。负向不是简单的“什么都没发生”,而是对这个特征的表达方向相反。这组对照比只看几张看起来像V的照片更有约束力:如果我们提出的是尖形或V形结构解释,那么圆形的一侧也应该能在证据里得到说明。把局部形状、输入输出连接和正负对照放在一起,才得到作者的解释。我们没有在本课重新训练这个网络,也没有声称完成了新的因果干预。
教师备课:指图与模拟问答
指图与推进 · 不朗读对照作者尖形/圆形图;分别指正与负,不演示伪造状态。
P05/b4 · 回收发现
把不同证据放在一起,才逐步约束解释。
训练出的中间特征,可以跨越人类命名的物体类别。
视觉网络的作者研究案例;不推出所有语言概念对应单个神经元。
这个发现最值得带走的,不是记住某个单元编号,而是改变我们看表示的方式。一个对多种对象都好用的中间特征,可能是局部结构,而不是“猫神经元”或“车神经元”。训练为了完成目标,形成了可以复用的计算材料。回到语言模型,我们也可以提出类似研究问题:哪些关系被表示,怎样参与任务?但不能把视觉网络这一例直接扩写成每个语言概念都对应一个单元,也不能从博客标题推出所有网络都已经解释完了。任务成绩和内部机制要各自拿证据。下一页把这个边界带回我们最初那份文字材料。
教师备课:指图与模拟问答
指图与推进 · 不朗读回到模型流程图的训练所得位置;下一页回语言模型。
补充推导、边界与来源
Goodfire分析视觉网络InceptionV1的4e:55单元时,先展示了猫脸和车头等看似类别混杂的高响应例子。沿着局部形状、上游输入、下游读取以及正负响应继续看,作者提出它更接近一个V形结构探测器:尖形提供正向支持,圆形提供相反响应。类别名称不同,并不妨碍局部视觉结构相似。
这里使用作者发布的固定图像证据与文字解释。原照片、特征可视化、局部激活或连接图各有不同身份;对照片加人工标记不构成激活测量,相关图像和连接也不等于我们完成了因果干预。本例帮助理解中间表示未必沿人类物体类别划分,不证明语言模型每个概念都有对应的单个神经元。
本例现已在默认主讲中完整展开:GF02 类别困惑、GF03 全图与局部、GF04 正负与连接。本页五个旧停点和返回原课堂语义继续保留;全文路线与附录见Goodfire 内部表示。
本页证据与条件
Goodfire:Neural Networks Are Already Clean,InceptionV1 4e:55 / Cars and Animals;作者原图与解释