返回课堂

完整深入材料 · 保留原页与全部停点。回到相关主讲

预训练之后,能否把所得用于另一项任务?

N32/b0 · 两条下游学习路线

评价对象:前提 + 假设 → 蕴含 / 矛盾 / 中立文本语言模型预训练普通文本 → 学到参数MNLI监督微调带标签句对 → 更新参数MNLI评价Transformer full + aux LM不做预训练从下游监督任务开始MNLI监督训练带标签句对 → 更新参数同指标评价w/o pre-training两条路线都进行了下游监督学习。
两条下游学习路线

这里是早期GPT论文的一项消融比较。先看路线:上面先用普通文本做语言模型预训练,再用带标签的数据学习MNLI;下面省掉预训练,从下游监督任务开始。最终都在自然语言推断任务上评价,不是让一个模型参加考试、另一个只背单词。

教师备课:指图与模拟问答

指图与推进 · 不朗读按从左到右分别读上下两条训练路线,先不报尚未显示的分数。

N32/b1 · 读同一消融表

评价对象:前提 + 假设 → 蕴含 / 矛盾 / 中立文本语言模型预训练普通文本 → 学到参数MNLI监督微调带标签句对 → 更新参数81.8%Transformer full + aux LM不做预训练从下游监督任务开始MNLI监督训练带标签句对 → 更新参数75.7%w/o pre-training同一Table 5 MNLI列:相差6.1个百分点两条路线都进行了下游监督学习。
读同一消融表

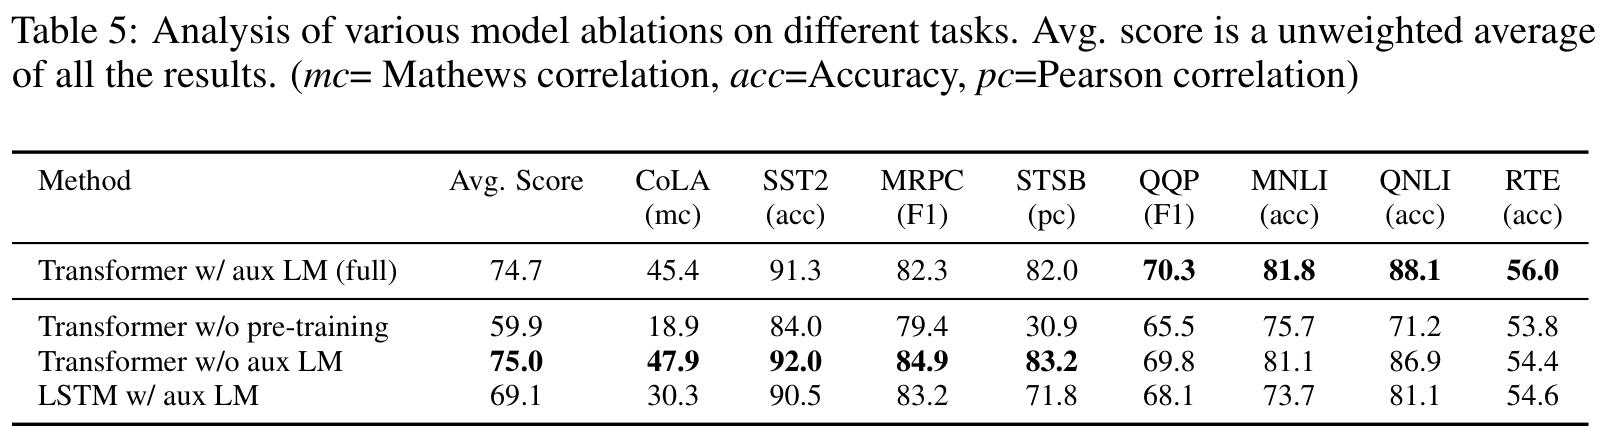
原论文Table5中,完整Transformer方案在MNLI这一列是八十一点八,没有预训练的方案是七十五点七,相差六点一个百分点。这支持一个具体判断:在这套实验中,语言模型预训练得到的参数,对后续的关系判断任务有价值。它让我们有理由把普通文本训练看成能力形成的一部分,而不只是训练一种文档续写器。

教师备课:指图与模拟问答

指图与推进 · 不朗读推进,指同一 MNLI 指标下的 81.8 与 75.7,再读 6.1 个百分点。

N32/b2 · 保留比较条件

评价对象:前提 + 假设 → 蕴含 / 矛盾 / 中立文本语言模型预训练普通文本 → 学到参数MNLI监督微调带标签句对 → 更新参数81.8%Transformer full + aux LM不做预训练从下游监督任务开始MNLI监督训练带标签句对 → 更新参数75.7%w/o pre-training同一Table 5 MNLI列:相差6.1个百分点比较条件额外预训练数据与计算;两路均下游监督;非等总预算。
保留比较条件

但条件也要一起读。完整方案带有论文所用的辅助语言模型目标,预训练还增加了数据与计算;这不是同样总预算下所有方案的终极排名,更不是说模型未见任务标签就拿到八十一点八。刚才的结果经过了下游监督微调。于是新的问题自然出现了:如果参数已经训练好,我们这一次不再运行优化器,只把任务说明或几个例子放到输入里,能不能让同一模型开始处理一个任务?这是下一段要观察的另一种改变。

进一步解释

论文 full 行含辅助语言模型目标;w/o aux LM 行为 81.1。这里采用 Table 5 的 MNLI 消融列,不与 Table 2 的 MNLI-m/mm 82.1/81.4 混用。

教师备课:指图与模拟问答

指图与推进 · 不朗读推进,指额外预训练数据/计算与两条下游监督路线;讲完后明确下一页取消优化器。
补充推导、边界与来源

GPT-1 Table5的MNLI列:Transformer w/ aux LM (full)为81.8,Transformer w/o pre-training为75.7,差6.1个百分点。两条路线都有下游监督学习;full还包含辅助语言模型目标,w/o aux LM一行为81.1。本页比较预训练消融,不是纯提示zero-shot,也不是相同总训练预算,不与Table2的MNLI-m/mm 82.1/81.4混用。

GPT-1 Table5原表

完整迁移比较。

来源与材料身份

  • 原始入口:Table5,PDF物理第8页;§3.2–3.3说明下游监督微调与输入转换
本页证据与条件

GPT-1 · Table 5 · MNLI下游监督微调;非零样本/等预算

进入主题正文