模型预测在这里,目标也在这里
本页问题
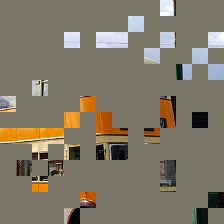
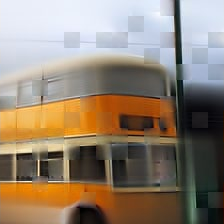
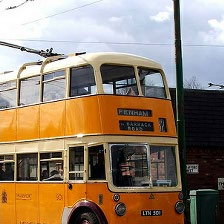
MAE重建示例由同一原始校车图产生输入和目标:模型收到39/196个可见patch,根据它们预测被遮位置的像素。预测保留黄色车身、两层轮廓和窗户大致位置,但车窗边界和车头文字与原图有差异。目标像素来自遮挡前的原图,可以给误差定量计分。这个示例约80%遮挡,与常用75%训练设置分开;重建相似不等于下游分类已经有效。
VR03/b0 · 先看模型实际收到的39块
由完整图片构造任务:根据可见部分,预测被遮像素
此图约80%遮挡;方法常用75%。比较的是被遮位置的预测与目标。
我们见过完整校车照片,但模型这一轮只收到左边的零散块:一百九十六块中可见三十九块,约百分之八十被遮住。任务是根据可见部分,预测被遮像素。先有全图、再做遮挡,输入与目标就都能从材料本身产生;观众看到的全图不等于模型输入。
进一步解释
此Figure2示例约80%遮挡;MAE常见方法配置为75%,两者分开。这里mask是造训练题,不是因果attention mask。
教师备课:指图与模拟问答
指图与推进 · 不朗读只指已显露的遮挡输入;将观众视野与模型输入分开。
VR03/b1 · 先揭预测,不提前引用目标细节
先看真实预测;下一步再用同位置目标检查
此图约80%遮挡;方法常用75%。比较的是被遮位置的预测与目标。
中间出现论文报告的重建。可以认出黄色车身、上下两层和窗户的大致位置,但窗框边界和车头文字还不清楚。现在看到的是预测结果,还不能只凭轮廓相似就说它每处都补对。下一步揭开原图,在相同位置检查哪些结构恢复了、哪些细节仍错了。
进一步解释
此图来自MAE v3 Figure2的原始预测,未把可见原图块覆盖回重建图。该制作与来源事实用于解释预测身份,不作为主讲结论。示例39/196可见块约80%遮挡;常用方法训练设置75%须另分。
教师备课:指图与模拟问答
指图与推进 · 不朗读指中间重建,右侧仍隐藏;不先讲尚未出现的对照细节。
VR03/b2 · 同位置比较误差,监督从原图来
车窗、文字与边缘的差异 → 明确的像素误差
此图约80%遮挡;方法常用75%。比较的是被遮位置的预测与目标。
原图里车窗框和车头文字更清晰;预测保留了车身的大结构,却没有恢复这些具体像素。两图中的同一位置因此给出可计算的误差。原图在遮挡之前已经存在,训练能从被遮位置的真实像素获得目标,不需要另请人逐张写答案。重建是否准确与表示能否用于分类仍是两个问题;下一页先沿这项误差看参数怎样更新,再看留下的表示怎样转用。
进一步解释
像素重建loss只计被遮位置,常用patch像素归一化。重建像不像与表示能否迁移分类需分别评价。
教师备课:指图与模拟问答
指图与推进 · 不朗读对齐两图同坐标框,比较车窗与边缘;不改变裁切或重建像素。
接下来
误差怎样改变参数?之后留下的是补图结果,还是可转用的表示?
补充推导、边界与来源
三图均来自MAE v3 Figure2校车行,固定身份与尺寸。真实重建不作美化;输入限制、预测、目标与后续独立评价分开。
与本页直接相关的完整材料
- N15 · 只看这些碎片,模型要补回什么?:原图、逐态说明与已校准推导。
- N16 · 重建可以不完美,监督却可以很明确:原图、逐态说明与已校准推导。
条件、推导与来源
N15 · 只看这些碎片,模型要补回什么?
本页左图是 MAE v3 Figure 2 校车行的真实遮挡输入,196 个 patch 中可见 39 个,约 80% 被遮住。观众之前见过全图,不代表模型该轮得到全图。遮挡人为构造了输入限制,原始图片同时提供预测目标;这里的 mask 是构造重建训练题,不是因果 attention mask。
来源:MAE v3,物理 p.2 Figure 2 校车行。
相关的完整阅读材料保留原有公式、引用和原始图解。
N16 · 重建可以不完美,监督却可以很明确
三张图片固定为论文遮挡输入、论文重建、原始图像。重建图保留原始误差,不贴回可见区域,也不进行生成式美化。训练时只对被遮位置计算像素重建损失;原论文还讨论 patch 像素归一化等实现条件。重建是否像原图与预训练表征是否能迁移分类,是需要分别评价的两个问题。
来源:MAE v3,Figure 2 与 §3。
相关的完整阅读材料保留原有公式、引用和原始图解。
本页证据与条件
MAE v3 Figure2校车原始遮挡、预测与目标