完整深入材料 · 保留原页与全部停点。回到相关主讲
重建可以不完美,监督却可以很明确
N16/b0 · 揭示论文重建
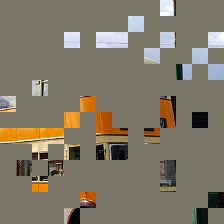
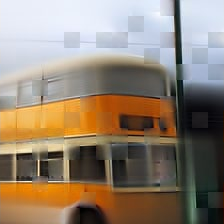
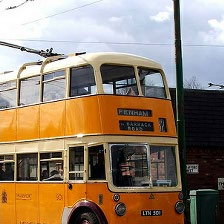
MAE 论文原图与重建 · 重建 loss 只计被遮位置
现在只揭开中间这一幅。它是论文实际给出的重建结果,已经能看到车身、黄色区域与一些轮廓。右侧目标图还没有揭开,先记录眼前预测的样子;下一次推进再做同位置比较。
教师备课:指图与模拟问答
指图与推进 · 不朗读只揭示中间论文重建;先观察形状和颜色,不指尚未显示的右图。
N16/b1 · 揭示原图目标
MAE 论文原图与重建 · 重建 loss 只计被遮位置
右边再放出原图,这时我们可以直接比较预测与实际像素。
教师备课:指图与模拟问答
指图与推进 · 不朗读指右侧原图,与中间重建同位置比较。
N16/b2 · 局部重建仍有误差
MAE 论文原图与重建 · 重建 loss 只计被遮位置
现在两图都有了,再看框出的车窗、文字和边缘。中间重建比右侧原图模糊,有些细节并不准确;它不是原图的复制品。我们不必靠一句“模型很懂”来评价它,因为训练时目标像素原本就在原始图片中。
教师备课:指图与模拟问答
指图与推进 · 不朗读指两图框出的车窗/文字/边缘,指出具体差异。
N16/b3 · 被遮位置提供损失
被遮位置:预测像素 − 目标像素 → loss → 参数更新
MAE 论文原图与重建 · 重建 loss 只计被遮位置
遮挡只是让模型不能直接拿到那部分输入;在计算误差时,我们仍然知道被遮位置的目标像素。预测与目标的差异可以产生损失,损失再约束参数更新。材料自己提供目标,这就是这里自监督学习的含义,并不是没有监督信号。还要再分开两个问题:把图补得像不像,是这项重建任务的结果;学到的表示能不能帮助识别新图片,是另一个需要测试的问题。不能只看这辆车大致成形,就宣布已经获得通用视觉能力。下一页把重建系统打开,看看训练过程中哪部分表示被保留下来,又怎样拿去做后面的分类评测。
进一步解释
保留论文实际重建,不把可见原像素重新贴回重建图。重建损失在被遮位置计算;像素目标的具体归一化等实现细节见相关阅读。
教师备课:指图与模拟问答
指图与推进 · 不朗读沿被遮位置的预测→目标→loss→更新短链;接下一页保留 encoder 的过程。
本页证据与条件
MAE v3 · Figure 2 · 真实遮挡输入/重建/原图;本图约 80% 遮挡