固定计算,看模型与数据怎样分配
S03/b0 · 固定预算曲线
Chinchilla(2022)Figure 3 · 固定训练 FLOPs,联合分配 N 与 D。
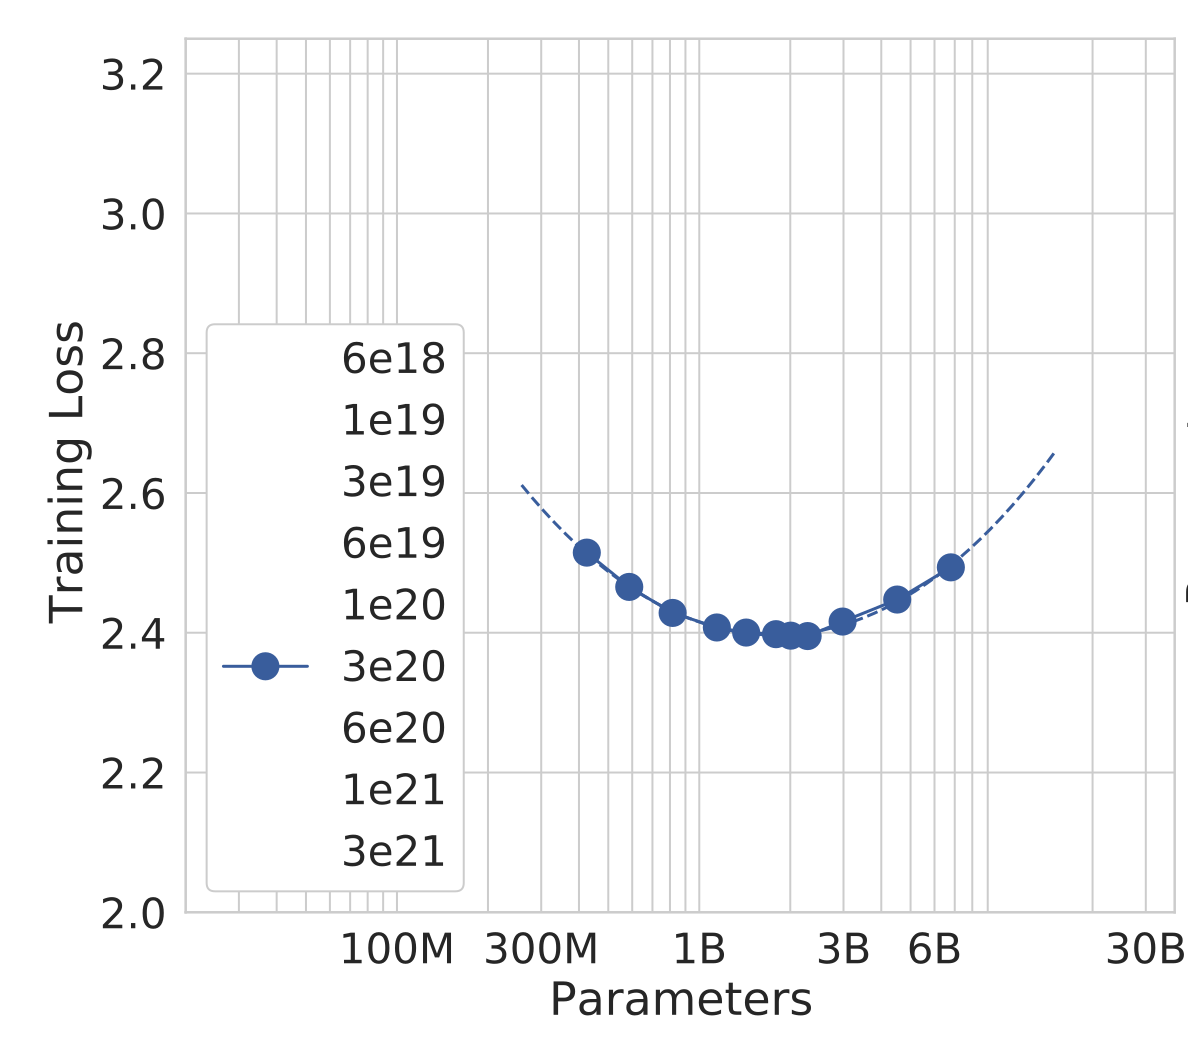
保持同一计算预算
- 横轴
- 参数 N(对数轴)
- 纵轴
- 训练 loss
- 保持不变
- C = 3×10²⁰ FLOPs
沿深蓝预算线读点与拟合;同一 C 下,模型大小改变时训练量也改变。
这张 Chinchilla 图的横轴是参数数量,纵轴是训练损失。先沿三乘十的二十次方 FLOPs 这一条预算线移动。同一条线上的模型大小不同,但计算预算相同,所以更大的模型要搭配更少的训练 token。点来自训练实验,虚线用来拟合趋势。我们先不跨到别的颜色,避免把增加预算的效果误当成分配更好的效果。
教师备课:指图与模拟问答
指图与推进 · 不朗读单预算原图;逐一指Parameters、Training Loss与3×10²⁰ FLOPs。
S03/b1 · 模型太小
Chinchilla(2022)Figure 3 · 固定训练 FLOPs,联合分配 N 与 D。
模型太小的一侧
- 横轴
- 参数 N(对数轴)
- 纵轴
- 训练 loss
- 保持不变
- C = 3×10²⁰ FLOPs
N 太小:即使能读更多 token,也受模型容量限制。
左侧的模型较小,一个 token 的成本低,所以能读更多材料。但在这组训练条件下,小模型的表示容量仍可能限制损失的继续下降。这里不是说小模型没有价值,而是在问:用这笔预训练计算,怎样得到更低的图中损失。
教师备课:指图与模拟问答
指图与推进 · 不朗读指左侧;保留较小N/较多D。
S03/b2 · 数据太少
Chinchilla(2022)Figure 3 · 固定训练 FLOPs,联合分配 N 与 D。
数据太少的一侧
- 横轴
- 参数 N(对数轴)
- 纵轴
- 训练 loss
- 保持不变
- C = 3×10²⁰ FLOPs
N 太大:同一计算预算下 D 变少。谷底平衡两侧代价。
移到右侧,参数更多,但每个 token 更贵。在固定预算下,它读到的材料减少,可能在充分训练之前预算就耗尽了。谷底附近因而不是越大越好,也不是一句适中最好,而是这组同预算训练给出的配置证据。换数据、目标或训练方法,仍要重新检查。
教师备课:指图与模拟问答
指图与推进 · 不朗读指右侧与谷底;不标未提供的精确最优坐标。
S03/b3 · 跨预算最优
Chinchilla(2022)Figure 3 · 固定训练 FLOPs,联合分配 N 与 D。
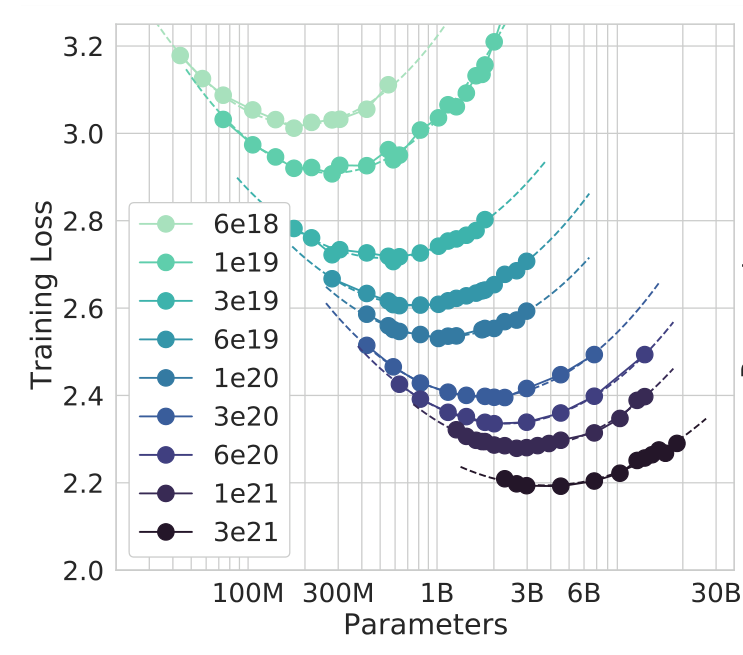
谷底怎样移动?
- 横轴
- 参数 N(对数轴)
- 纵轴
- 训练 loss
- 保持不变
- 每一条曲线各自的 FLOPs
更大的预算,允许联合增加模型和训练量;再用目标任务验证。
把其他预算恢复出来,较合适的模型规模也随预算移动,训练 token 应当一起考虑。这个结果指导训练配置,不是一个永恒配方,更不是服务生命周期的总成本最优。完整历史训练对比和长期调用成本可以在说明里展开。现在带着一个具体模型配置,往设备里放一次:权重文件装得下,就能训练了吗?
教师备课:指图与模拟问答
指图与推进 · 不朗读恢复多预算图及最优分配面板;指出实测点与虚线拟合。
补充推导、边界与来源
Chinchilla Figure 3左图的IsoFLOP分析,在固定训练计算预算下改变模型规模,并调整训练token。横轴为Parameters,纵轴为Training Loss。同预算曲线的较低区域,表示在比较的设置中,模型容量与训练量配置更合适。
左侧模型较小,可以读更多token,但容量可能限制收益;右侧模型较大,每token更贵,能读的token较少,可能未充分训练。再看不同预算的最优点,模型和数据的较合适规模都随预算改变。原图实测点与虚线拟合有不同身份;这种计算最优还受目标、数据和架构范围限制,并不等同部署时总成本最优。
本页的前台比较限于固定预训练计算。较大规模的 Chinchilla/Gopher 历史配置、Kaplan 的不同横轴及长期调用成本分别在 扩展历史比较、横轴与指标、生命周期预算 和 规模扩展主题 中保留。
本页证据与条件
Hoffmann et al. 2022 Chinchilla Figure 3,IsoFLOP profiles