同样的训练,横轴决定在问什么
S02/b0 · token横轴
Kaplan 等(2020)Figure 2 · 同一批训练曲线,颜色表示非嵌入参数数量。
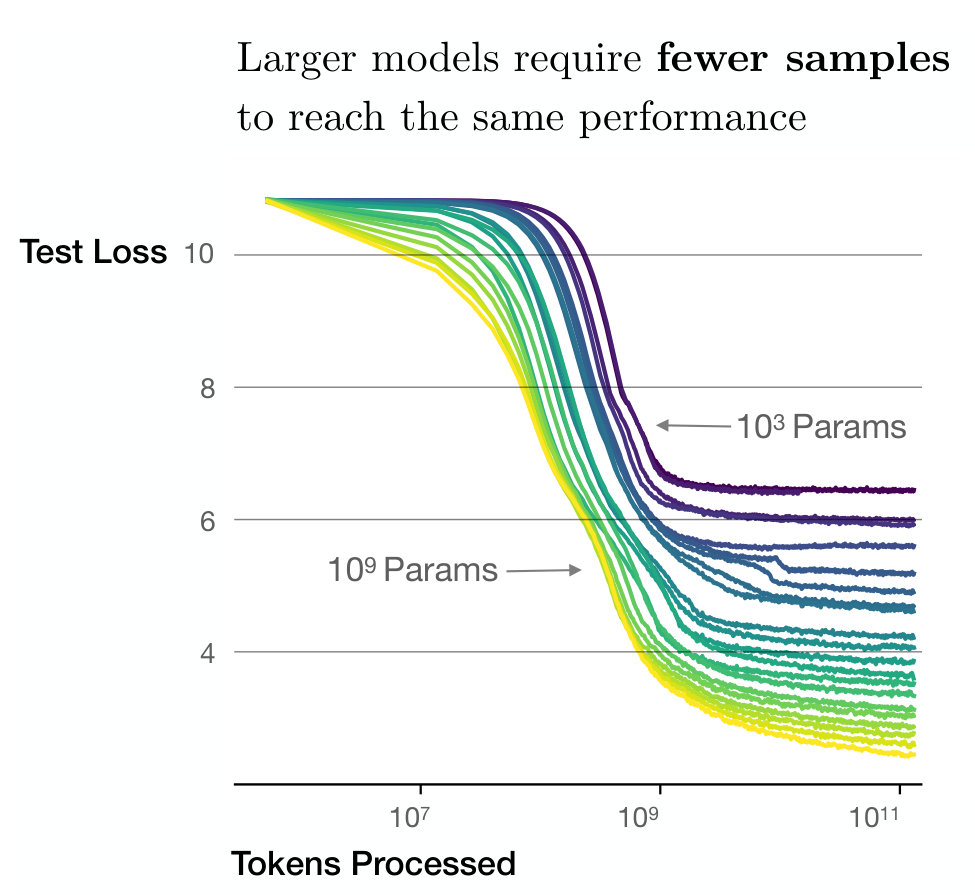
读了多少 token?
- 纵轴
- 测试 loss,越低越好
- 横轴
- Tokens Processed
处理过的 token(对数轴) - 颜色
- 非嵌入参数数量
紫色 10³ → 黄色 10⁹
沿同一颜色读训练推进;达到同一 loss,大模型可能需要更少样本。
先看这张图的横轴,英文Tokens Processed,就是训练读过多少token。纵轴Test Loss是测试损失,越低代表在这个评价分布上给真实后续分配的概率总体更好。不同颜色对应不同规模,图例特别注明不包括embedding参数。请沿同一个横坐标向上看,意思是它们已经读过大致相同数量的token,然后再比较损失。作者在这一视角下强调较大模型的样本效率:同样材料消费,它可能达到更低损失。这里按原图趋势读,不从截图自己编出未标注点的精确数值。更低损失仍然需要在同一评价分布和相容的分词口径下比较。如果评价文本或token定义变了,不能看到数字较低就直接当成模型更好。保留这些条件,曲线比较才有意义。
教师备课:指图与模拟问答
指图与推进 · 不朗读只显示token面板;指横轴、纵轴、图例,再作竖向比较。
S02/b1 · 计算横轴
Kaplan 等(2020)Figure 2 · 同一批训练曲线,颜色表示非嵌入参数数量。
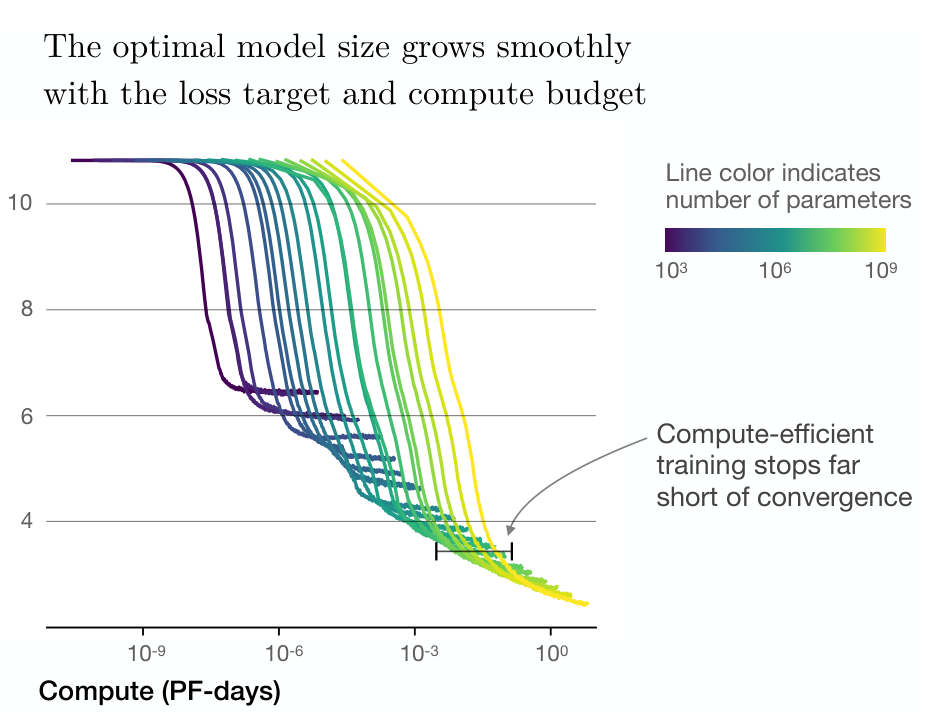
付出了多少计算?
- 纵轴
- 测试 loss,越低越好
- 横轴
- Compute(PF-days)
训练计算量(对数轴) - 颜色
- 非嵌入参数数量
紫色 10³ → 黄色 10⁹
同一批曲线换计算横轴;每个 token 的成本随模型大小改变。
现在换到计算量横轴,单位是PF-days,表示以每秒千万亿次浮点运算持续一天来计量的计算量单位,不是这次训练实际用了一天。训练还是那些模型,但一个大模型处理同一个token通常要做更多计算。因此刚才横坐标相同的两个位置,在计算预算上未必相同。这个面板回答的是付出相近计算能得到怎样的损失。样本效率好,说明材料用得有效;计算效率好,说明计算资源花得有效。两者可能一致,也可能因模型规模不同而分开。这就是为什么必须先读横轴。如果我们实际只有一笔固定预算,就应在计算横轴画一条竖向比较线,看看哪些训练记录能走到那里,以及各自的损失。不能拿一个模型训练结束后的点,与另一个模型更早或更晚、花费不同的点直接比完,就说规模决定胜负。即使比较的是同一任务,只要成本条件没固定,结论所回答的问题就已经变了。
教师备课:指图与模拟问答
指图与推进 · 不朗读切计算面板;指PF-days单位,并保持原图图例。
S02/b2 · 证据与边界
Kaplan 等(2020)Figure 2 · 同一批训练曲线,颜色表示非嵌入参数数量。
付出了多少计算?
- 纵轴
- 测试 loss,越低越好
- 横轴
- Compute(PF-days)
训练计算量(对数轴) - 颜色
- 非嵌入参数数量
紫色 10³ → 黄色 10⁹
固定预算时比较可达 loss;这些是该论文条件下的经验曲线。
两张图还有共同要求:只能在它们实际实验和拟合的条件内读结论。论文会用规律描述观察到的趋势,也可能向更大规模外推;但外推不等于已经跑过那个训练。横轴采用对数刻度,屏幕相同距离通常表示倍率变化,并不是简单多了同样数量的token。最后,测试损失很重要,却不是我们研究项目的全部目标。损失更低之后,仍应检查目标任务是否改善。这一页要带走的是比较方法,而不是记住某种模型永远最好。下面把总计算固定下来,比较模型与数据的不同分配。所以先说清比较条件,再读趋势,最后才形成选择,这是读这类图时可以复用的方法。
教师备课:指图与模拟问答
指图与推进 · 不朗读指刻度与图注,接同预算比较。
补充推导、边界与来源
Kaplan Figure 2左图横轴为Tokens Processed,右图为Compute (PF-days),纵轴均为Test Loss。颜色区分不含embedding的参数规模。看token横轴时,比较在读过相同数量材料后,不同规模模型达到什么损失;看计算横轴时,则把每个token随模型规模变化的代价计入比较。
模型较大可能更具样本效率,但不自动保证每一种计算预算下都占优。读图应保留对数刻度,区别实际训练曲线、拟合与外推,不从截图编造未标注点的精确值。此图属于特定历史训练范围,帮助建立条件化比较方法,不能替代当前项目测量,测试损失也不是下游任务得分。
本页证据与条件
Kaplan et al. 2020 Figure 2;原图轴与图例保留