同模型的收益,要连同额外训练一起读
本页问题
MAE Table3在ImageNet-1K、224×224评价中比较两条路线。B/16、L/16、H/14从头监督训练为82.3、82.6、83.1;MAE预训练后微调为83.6、85.9、86.9。相同L/16提升3.3个百分点,说明该路线有分类迁移收益。两路共享训练图片池,却非等计算:MAE还使用1600轮预训练。H/14的patch规格与B/L不同,448分辨率结果也不混入本图。
VR05/b0 · 先立同模型的监督训练参照
先分开两个对象:ImageNet一K训练图片池用于学习,独立验证集用于评价。纵轴是二百二十四分辨率下的分类准确率。灰线来自论文自己的从头监督训练。重点追L/16的八十二点六,B与H留作趋势参照。
进一步解释
top-1是模型排名第一的类别与真实标签相同的比例。灰线、蓝线都由独立ImageNet验证图片评价;用于学习的训练图片池与验证集角色不同。
教师备课:指图与模拟问答
指图与推进 · 不朗读指右侧训练池/独立验证集两对象,再找到灰线L/16=82.6。
VR05/b1 · 同一个L/16,82.6到85.9
加入蓝线:先做MAE预训练,再分类微调。同一个L/16从八十二点六到八十五点九,提升三点三个百分点。B和H也显示在图里。这把“学到的表示是否有用”交给另一项明确任务,不再仅凭重建照片作判断。
进一步解释
B/L/H从头82.3/82.6/83.1;MAE后83.6/85.9/86.9;差值1.3/3.3/3.8pp。H/14 patch规格不同;不混入448分辨率87.8。
教师备课:指图与模拟问答
指图与推进 · 不朗读竖着连L/16灰蓝两点,读+3.3个百分点;其余数字不逐项重念。
VR05/b2 · 同样图片池,不是同样计算
蓝线还多做一千六百轮重建预训练。同一图片池不等于同样计算,因此这是任务方式与投入共同改变了结果。我们已经看到可迁移收益,但分数仍没说明内部正在区分什么;这个问题需要换一种观察办法。
教师备课:指图与模拟问答
指图与推进 · 不朗读指额外1600epoch和非等计算条件,再回到两条线留下内部问题。
接下来
结果告诉我们做得怎样,内部究竟形成了什么?
补充推导、边界与来源
按MAE v3 Table3重绘,保留原表核对入口。训练图片池与验证集分开,224评测与448结果分开,同文对照与等计算实验分开。
与本页直接相关的完整材料
- N18 · 先立参照:同一批训练图片,从头训练能做到什么?:原图、逐态说明与已校准推导。
- N19 · 先学重建,再做分类,大模型的收益更明显:原图、逐态说明与已校准推导。
条件、推导与来源
N18 · 先立参照:同一批训练图片,从头训练能做到什么?
指标是独立 ImageNet 验证集上的分类 top-1,输入分辨率统一为 224×224。两条训练路线共享 ImageNet-1K 训练图片池,但验证集与训练图片池分开。论文 Table 3 的从头监督训练基线为 B/16 82.3、L/16 82.6、H/14 83.1;B/L/H 代表不同模型规模,H 的 patch 尺寸也为 /14,不能把跨规模图读成严格只改一个参数的实验。
来源:MAE v3,物理 p.7 Table 3 / Figure 8。
相关的完整阅读材料保留原有公式、引用和原始图解。
N19 · 先学重建,再做分类,大模型的收益更明显
MAE 后微调成绩为 83.6、85.9、86.9,与从头监督训练逐模型差值为 1.3、3.3、3.8 个百分点。MAE 额外预训练 1600 epoch;共同使用训练图片池不等于等计算。ViT-H/448 的 87.8 使用不同分辨率,不混入本图 224 比较。
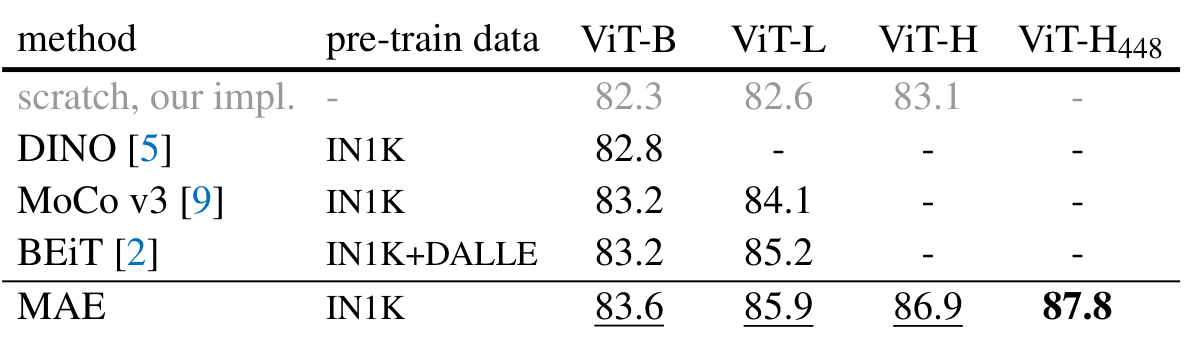
原表保留供核对配置;主屏曲线按 Table 3 重绘,不是新实验。
来源:MAE v3,Table 3;本课按原表重绘。
相关的完整阅读材料保留原有公式、引用和原始图解。
本页证据与条件
MAE v3 Table3原实验数据;224×224分类评价