普通文本训练,能帮助另一项任务吗?
本页问题
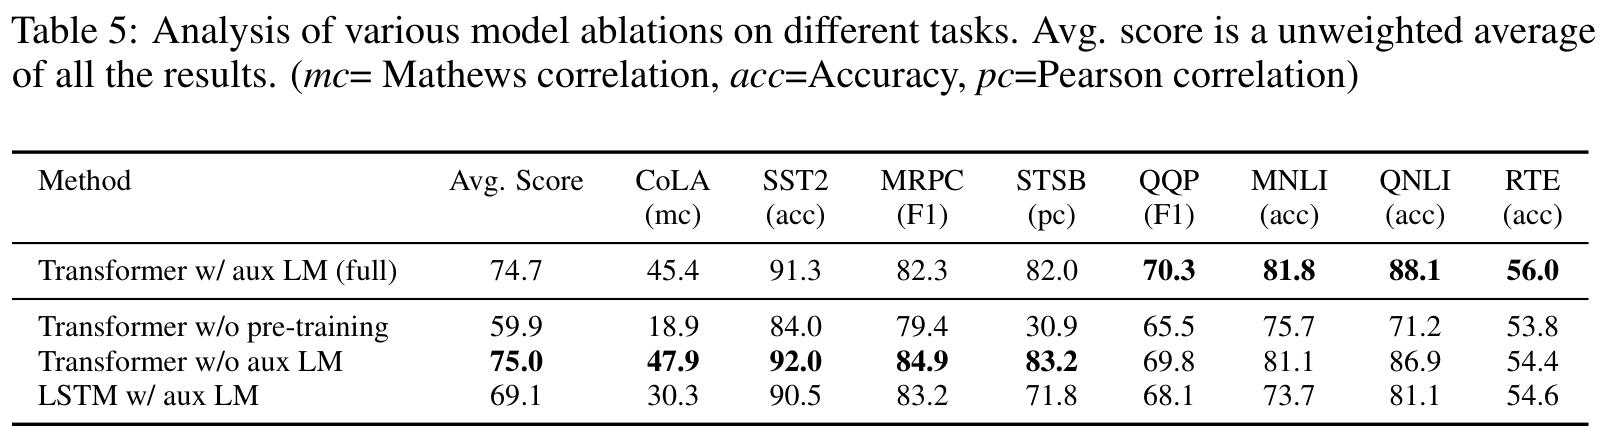
自然语言推断判断一条假设与给定前提的关系:受到支持、与前提冲突,或信息不足。A/B例子只用于解释这三类关系。真实证据来自GPT-1 Table5的MNLI消融:完整方案81.8,无预训练方案75.7,相差6.1个百分点;两条路线均使用下游监督,完整方案含辅助语言模型目标并额外使用预训练资源。
RC-P6/b0 · 三条结论与同一前提
先用熟悉的A/B前提读懂任务:十二和八支持“B在本次测试中耗时更短”,与“A更快”冲突;没有测内存,则“B内存更少”既未得到支持,也未被否定。这三种关系叫蕴含、矛盾、中立,合称自然语言推断,简称NLI。左边三句是课堂构造,用来理解任务,不是论文MNLI数据集中的原题。
教师备课:指图与模拟问答
指图与推进 · 不朗读对同一前提逐行指三条假设、关系与数值依据。
本态来源与条件
A/B句对为教学构造,用于解释NLI三关系;不是MNLI原题。
RC-P6/b1 · 换成真实任务和训练路线
现在把证据换成真实MNLI评价。它在不同体裁的前提与假设句对上判断同样三类关系。上路先用普通文本做语言模型预训练,再用带标签的MNLI数据更新参数;下路省去预训练,直接从下游监督训练开始。两路的终点都是MNLI分类评价,这次比较的是训练经历是否带来可迁移收益。
进一步解释
MNLI为跨体裁自然语言推断任务。此处早期GPT使用下游监督微调及任务输入转换,不应与后面仅前向的ICL或生成式指令SFT混为同一接口。
教师备课:指图与模拟问答
指图与推进 · 不朗读保留左侧构造任务缩略图,沿右侧两条训练路线指读。
本态来源与条件
GPT-1 §3.2–3.3、§4.2与Table5:有/无预训练的下游监督路线。
RC-P6/b2 · 读同一列真实分数
GPT-1 Table5的同一MNLI列,完整方案是百分之八十一点八,去掉预训练是百分之七十五点七,差六点一个百分点。准确率表示许多句对中关系标签判断正确的比例。这些是原论文实验结果,不是左边三道A/B题的得分,也不是本课现场重跑。结果支持指定条件下普通文本预训练对下游任务有帮助。
进一步解释
GPT-1 Table5:Transformer w/ aux LM (full)=81.8;Transformer w/o pre-training=75.7;Transformer w/o aux LM=81.1。这里只主读前两项,不与Table2的MNLI-m/mm 82.1/81.4混用。
教师备课:指图与模拟问答
指图与推进 · 不朗读指同一 MNLI 指标下81.8与75.7,再指差6.1pp。
本态来源与条件
GPT-1 Table5 MNLI原实验:full 81.8、无预训练75.7;差6.1个百分点。
RC-P6/b3 · 把证据条件一起带走
把两条路线的条件也一起读:两路都有下游标签,完整方案还加入辅助语言模型目标,而且多用了预训练材料和计算。因此它不是不改参数的纯提示实验,也不是等总预算比较。到这里我们看的是训练后继续更新参数的迁移。接下来把优化器暂时拿开,只给当前输入加一个示例,看看可以改变什么。
进一步解释
“full + aux LM”中的aux LM是辅助语言模型目标,指下游训练同时保留语言建模辅助项;不能将它改写成另一个没有原文依据的新训练阶段。
教师备课:指图与模拟问答
指图与推进 · 不朗读指两路下游监督与额外预训练条件,再指固定参数进入下一问。
本态来源与条件
GPT-1 Table5条件:两路有下游监督,full含aux LM;额外预训练数据与计算,非等总预算。
接下来
取消优化器,只给本次输入加一个示例。
补充推导、边界与来源
| 材料层 | 比较内容 | 可以回答的问题 |
|---|---|---|
| A/B教学例 | B更快/A更快/B内存更少 | 蕴含、矛盾、中立分别是什么意思 |
| GPT-1 Table5原实验 | full 81.8;w/o pre-training 75.7 | 指定训练配置下预训练是否有迁移收益 |
6.1是准确率的百分点差,不是相对增长率。原表和A/B构造例承担不同职责,不能把整页都标为教学模拟。
深入解释与来源
先看任务:这条结论能从前提推出吗?
NLI判断前提与假设之间的关系:蕴含是被前提支持,矛盾是与前提冲突,中立是信息不足。本例A/B三句是教学构造,并非MNLI原题。未测内存不能推出B更省,也不能推出A更省或两者相等。MNLI是真实跨体裁的自然语言推断数据集,准确率是在许多句对上选对标签的比例。
来源与材料身份
- 原始入口:§4.2 Natural Language Inference,物理第5页;本例AB句对为构造例
预训练之后,能否把所得用于另一项任务?
GPT-1 Table5的MNLI列:Transformer w/ aux LM (full)为81.8,Transformer w/o pre-training为75.7,差6.1个百分点。两条路线都有下游监督学习;full还包含辅助语言模型目标,w/o aux LM一行为81.1。本例比较预训练消融,不是纯提示zero-shot,也不是相同总训练预算,不与Table2的MNLI-m/mm 82.1/81.4混用。
来源与材料身份
- 原始入口:Table5,PDF物理第8页;§3.2–3.3说明下游监督微调与输入转换
本页证据与条件
左侧A/B为教学构造;右侧为GPT-1 Table5 MNLI原实验,含下游监督与既定辅助目标。