完整深入材料 · 保留原页与全部停点。回到相关主讲
谷底随预算移动,不能只追求参数更多
N43/b0 · 沿固定预算看左侧
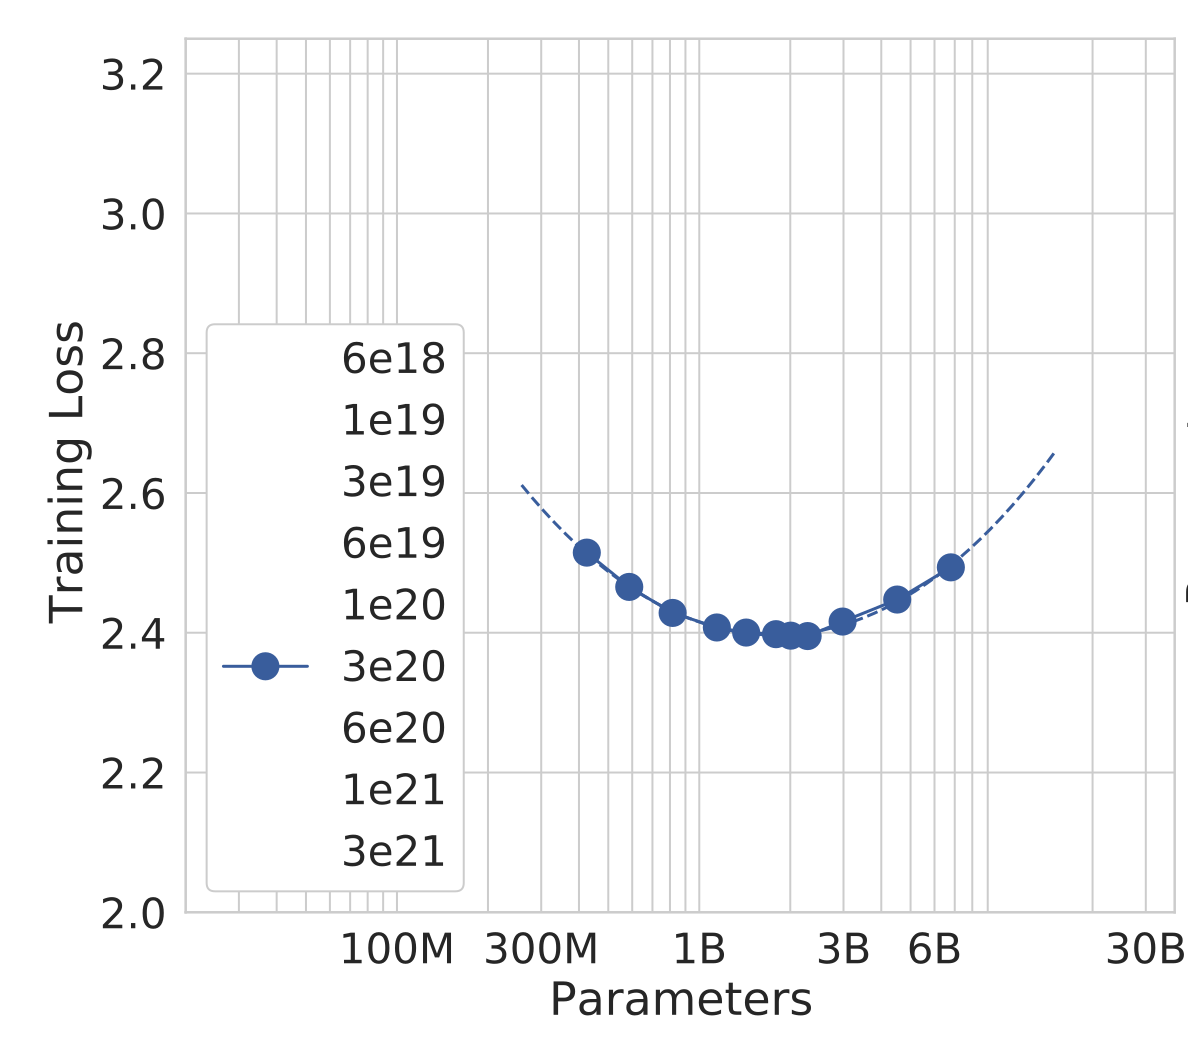
先沿这一条线走。左边模型较小,每个token便宜,因此可以读更多材料;可是在这组条件下,模型本身的表示能力也会限制损失下降。
教师备课:指图与模拟问答
指图与推进 · 不朗读指原图左侧圈定区域。
N43/b1 · 观察谷底附近
再把目光移到谷底附近。在这组预算与实验条件下,它的训练损失比两侧更低,说明模型规模和训练量在这里取得了较好的平衡。注意,我们说的是这条预算线和这组实验,并没有得到一个适用于所有模型的永久比例。
教师备课:指图与模拟问答
指图与推进 · 不朗读指中间圈定范围,并与左右位置作比较;不从像素报精确最优参数量。
N43/b2 · 再看较大模型一侧
右边模型很大,却没有得到同样多的训练消费,预算可能在它充分受训之前就用完了。
教师备课:指图与模拟问答
指图与推进 · 不朗读游标移到较大N一侧,与左侧联动对比。
N43/b3 · 恢复不同预算
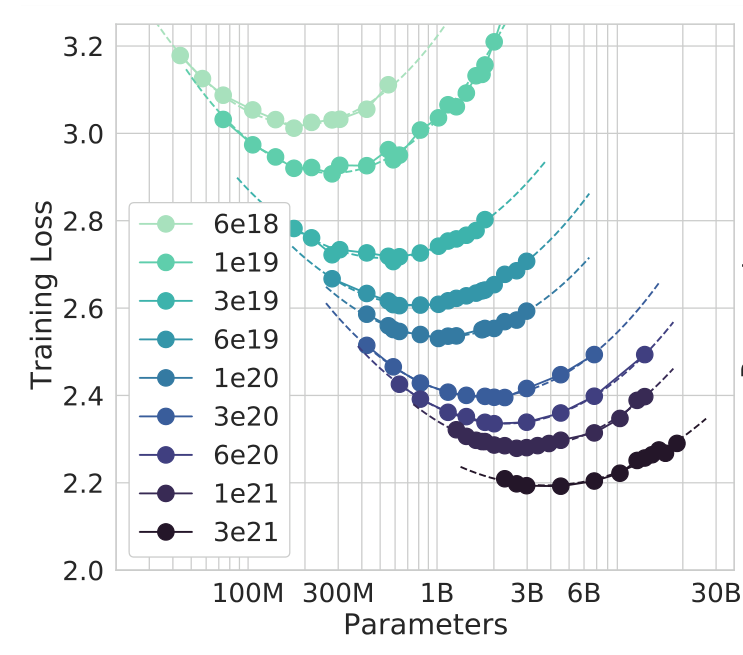
现在才把其他预算线恢复出来。沿一条线移动,研究的是同一笔钱怎样分配;从一条线换到另一条线,才是在增加总投入。这是两个不同动作。预算增加以后,合适的模型规模和训练量都可能增加。我们可以用这些趋势指导下一次训练,再在自己的数据、目标和评测上检查,不能把某个历史比例当成永久配方。
进一步解释
同一条线内移动保持 C 不变,换到另一条线则改变 C。图中只圈定趋势范围;不从像素估读精确最优值。MoE 的总参数和每 token 激活参数不同,不能把稠密 6ND 无条件套到 MoE 总参数上。
教师备课:指图与模拟问答
指图与推进 · 不朗读恢复原多预算图,用圈定范围区分两条预算线。
N43/b4 · 带着配置走入设备
这里的纵轴仍是预训练损失,也没有把将来所有用户的推理费用都算进去。于是,模型选择还要连接实际用途。为了继续把问题讲透,我们先选八十亿参数作为统一的教学模型,不声称它就是某条曲线的精确最优点。纸面上选好了模型,下一步把它放进机器里:一次训练究竟需要保存哪些东西?
教师备课:指图与模拟问答
指图与推进 · 不朗读保留多预算图,在右侧给出8B统一教学配置。
补充推导、边界与来源
沿单条预算线移动,比较的是固定计算预算下模型规模和训练消费的分配。小模型一侧可能受容量限制;大模型一侧则可能在充分受训前耗尽预算。谷底附近是指定模型、数据、训练与评价条件下的证据,不是永久比例,也不是越大越好的证明。
恢复多预算原图后,换曲线表示改变总训练投入。图中不从像素估算未经表值支持的精确最优坐标。8B 是后段统一教学配置,不对应声称的某个最优点。训练 loss 也不是用户满意度;高频使用时还应考虑服务成本。
Kaplan / Chinchilla / Gopher 与生命周期成本;MoE 总参数、激活参数与异构承载。稠密 6ND 不无条件套用 MoE 总参数。
本页证据与条件
Chinchilla v1 Fig.3 / Appendix F;课堂预算构造与论文实验分开