本页学习说明
相同的语言建模目标可以作用在关系句、实验记录和代码上,但三类材料分别要求因果条件、数值对象对应和程序依赖。材料类别并不自动等于获得的能力。资料库存、抽样后的训练消费和重复次数也必须分开:未被抽到的材料不构成这轮训练经历,重复读取则重复消耗计算。
| 材料 |
预测可能需要的依赖 |
| 奖杯/手提箱关系句 |
物体、容器、原因条件 |
| A/B实验记录 |
方案、数值、未测范围 |
| 字典与min调用代码 |
变量、键值对应、函数语义 |
库存①②③与训练流①②①③①②不同:前者有三份独特文档,后者发生六次读取。这只是说明计数身份,不是模型能力或泛化测量。
深入解释与来源
目标相同,材料让模型反复遇见的关系不同
相同的下一项预测目标可以面对物体关系、记录字段或代码操作等不同内容。材料选择改变反复要求模型处理的规律,但不能仅凭材料类别宣布能力已经获得。库存是可用语料;过滤、去重、抽样比例和重复决定实际训练消费。GPT-3训练300B tokens的语料表区分库存、混合权重与近似epoch,原论文四舍五入后的权重合计不强改为100%。
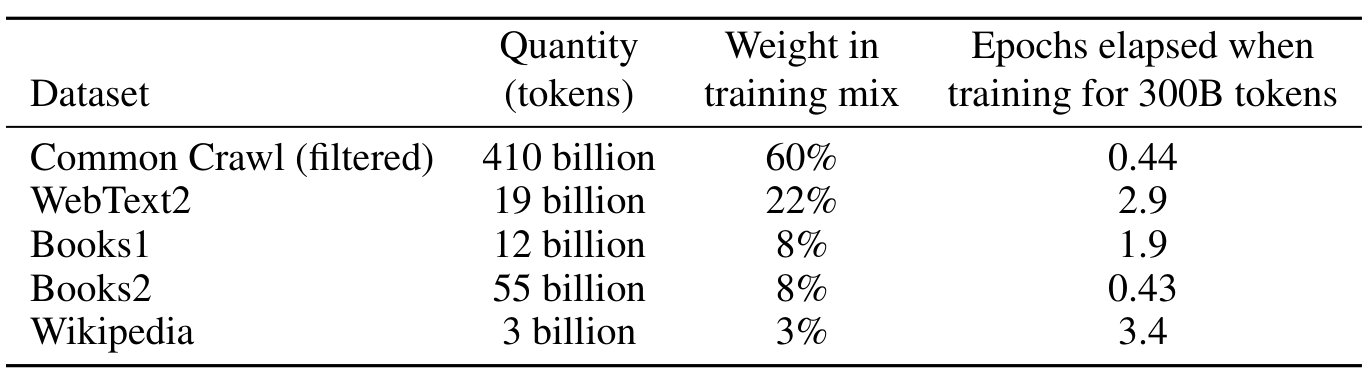
完整数据配比解释 · Goodfire五步局部表示观察。后者是InceptionV1案例,不是LLM能力证明。
来源与材料身份
- 原始入口:§2.2、Table2.2,PDF物理第9页:库存、训练混合权重、消费/重复分别列示
阅读完整讲义