本页学习说明
GPT-3 Table3.4报告同一175B模型在WMT’14英语到法语任务上的BLEU:zero-shot 25.2、one-shot 28.3、few-shot 32.6。评测仅前向、不更新模型参数。few-shot采用K=64的设置并受2048上下文窗口限制。该结果是指定翻译任务的证据,与A/B课堂构造例分开。
| 示例条件 |
BLEU |
| Zero-shot |
25.2 |
| One-shot |
28.3 |
| Few-shot,K=64设置 |
32.6 |
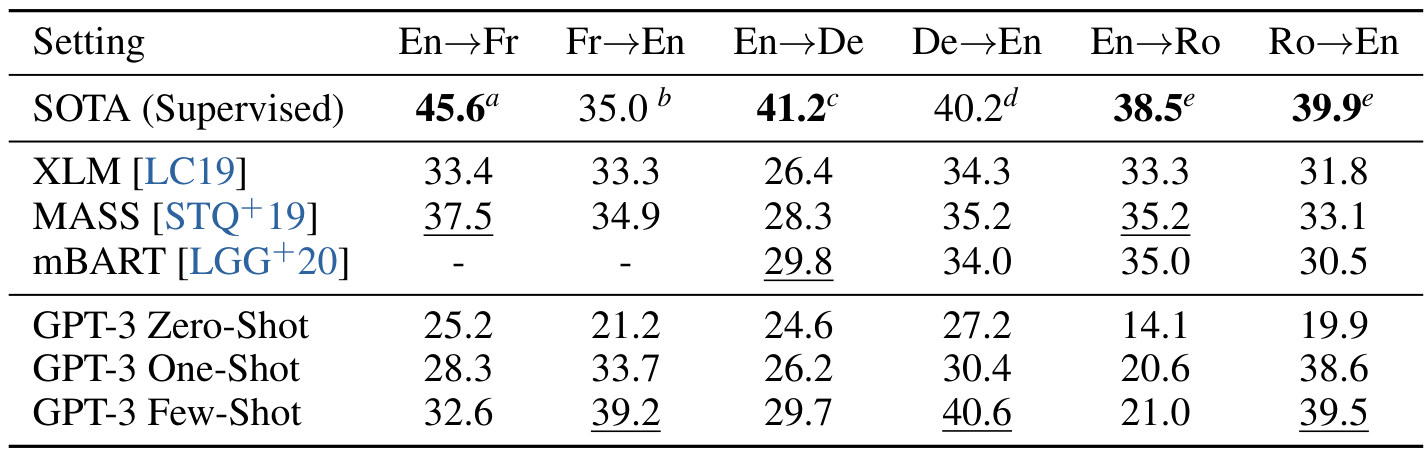
这些数值来自真实论文评价,BLEU不是准确率。本课未重跑模型,也未将此结果改写成A/B任务效果。
深入解释与来源
示例的作用,要在完整翻译任务上看
这里仅采用GPT-3 Table3.4的175B模型在WMT’14 English→French方向的BLEU:zero-shot25.2、one-shot28.3、few-shot32.6,采用multi-bleu.perl口径。论文设置K=64,并受2048上下文窗口约束,不假定每条输入完整装下64个长句。BLEU不是准确率,7.4分差不能写作准确率提高7.4%。
结果仅支持指定模型、任务、示例与预算条件,不能推广为示例越多越好或超越全部监督模型。
来源与材料身份
- 原始入口:Table3.4,PDF物理第15页;§3.3物理第14页说明1/64个成对示例;Appendix H物理第63页En→Fr14的K=64及175B结果
阅读完整讲义