完整深入材料 · 保留原页与全部停点。回到相关主讲
这张图比较的,究竟是哪一次训练?
N12/b0 · 分类准确率轴
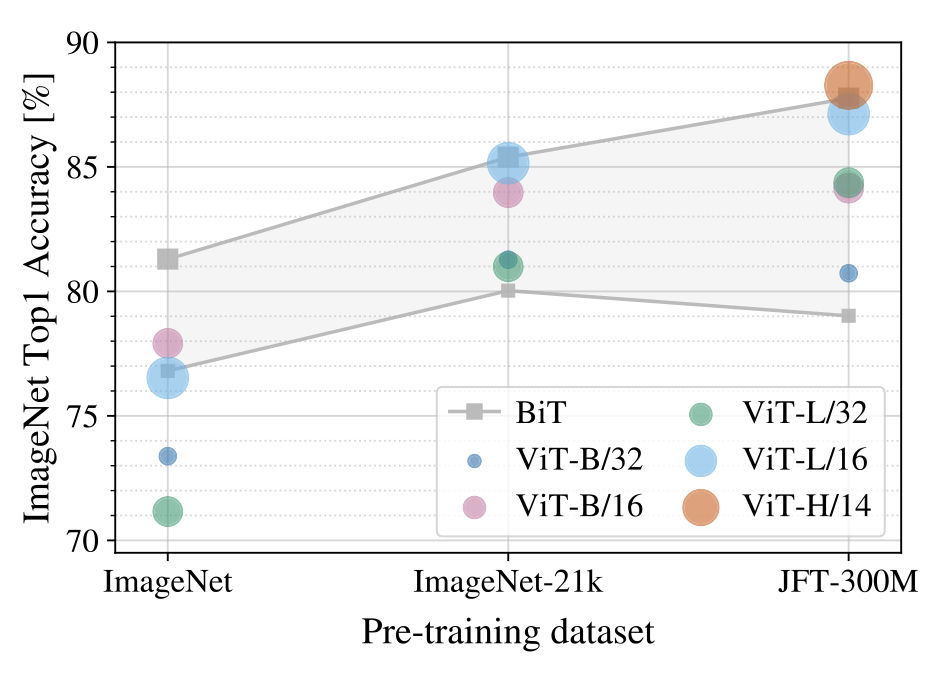
这张图先只读坐标。纵轴是 ImageNet 的分类准确率,越高表示这项识别评测越好;它不是刚才记忆例子的读出误差,也不是语言模型的预测损失。
进一步解释
top-1 accuracy 是预测排名第一的类别与正确标签一致的样本比例;这一页用它解释图的评测口径,不将它与语言模型 loss 或玩具读取误差混在一起。
教师备课:指图与模拟问答
指图与推进 · 不朗读只沿纵轴高亮读 top-1 accuracy,不比较最高点。
N12/b1 · 预训练数据集轴
横轴是用来预训练的三个数据集,名称、规模和组成都不同,不能把它当成一条只改变样本数量的连续刻度。
教师备课:指图与模拟问答
指图与推进 · 不朗读沿横轴三个数据集读名称与类别;指出不是连续等距样本数。
N12/b2 · 预训练、微调与评测
再看一个点。这里的 ViT 先用横轴对应的数据集学习带标签的图像分类,然后带着已经学到的参数,在 ImageNet 上继续训练,最后评测分类准确率。前一个阶段叫预训练,后一个继续适应目标任务的阶段叫微调。预训练说的是它在整个学习流程中的位置,并不意味着一定没有标签。
教师备课:指图与模拟问答
指图与推进 · 不朗读指高亮的一个点,再沿侧边三阶段流程从预训练讲到独立验证。
N12/b3 · 比较模型与图例
比如 ViT-L/16,L 表示一种模型规模,16 表示图像块的边长,即 16×16 像素。我们先盯住 B/16 与 L/16 这一对,避免同时改变太多条件。灰色部分给出不同规模 BiT 卷积模型的表现范围,也不是一个单一的小模型。现在我们终于可以问有意义的问题了:在同一个预训练数据集条件下,大一点的 ViT 是否更好?它相对卷积基线在哪里?先把目光留在左边 ImageNet 这一列,暂时不看右侧最亮眼的结果。
教师备课:指图与模拟问答
指图与推进 · 不朗读指 B/16、L/16 与灰色 BiT 图例;把注意力收回左列。
本页证据与条件
ViT v2 · Figure 3 · ImageNet 微调评测;数据集数量与组成同时变化