图像也能成为输入序列
X01/b0 · 同一张图
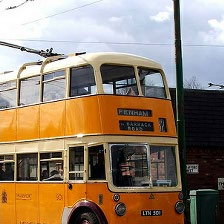
同一套读取与变换,也可以处理图像。
4 × 4 分块仅作序列化教学示意;图像取自 MAE 论文。ViT 的真实 patch 尺寸依模型配置。
刚才我们把输入形成的键和值,与训练形成的参数分开看。现在把输入换成一张图。眼前是同一辆校车,右边仍是 Attention 和 MLP。要把它们接起来,我们不必从头发明另一套计算规则;先解决接口问题:怎样把这张二维图像变成模型可接收的一串向量。
教师备课:指图与模拟问答
指图与推进 · 不朗读指校车图与右侧 Transformer,暂不展开分块。
X01/b1 · 图像块成为序列
每块展平、投影,再加入位置信息
输入变成序列,熟悉的计算结构就能接手。
4 × 4 分块仅作序列化教学示意;图像取自 MAE 论文。ViT 的真实 patch 尺寸依模型配置。
我们把图片分成小块,每块展平、投影成向量,再加入位置。这样输入就成了一串向量,Transformer 可以继续读取和变换它们。屏幕只画十六块,便于追踪,不是论文的固定配置。现在结构上接通了,但这还没有回答“为什么值得采用”。如果只看一个小数据实验,可能会得出一种判断;把训练条件扩大,判断也可能改变。我们直接看论文里的比较。
教师备课:指图与模拟问答
指图与推进 · 不朗读显出分块编号,再沿编号序列指向 Attention 与 MLP。
补充推导、边界与来源
上一段把 Transformer 看成读取与变换信息的结构。接下来先到视觉里检验一个具体问题:相似的结构能否随训练规模扩大而继续受益?为此需要让图像接到这个结构的输入端。
ViT 将图像切成固定大小的 patch,将每块像素展平并线性投影为向量,再加上位置信息,送入 Transformer encoder。这里唤起“输入可以序列化”的共同接口,不重讲完整架构。图中的 4×4 网格只用于解释这个动作,不对应 ViT-B/16 的真实输入配置。B/16 的 16 指 patch 边长为 16 像素;若图片为 224×224,得到的是 14×14=196 个图像块。
本页重复使用下一页 MAE 案例中的校车原图,是为了保持视觉对象连续。它不是 ViT 论文的输入样本或新实验。ViT 的结构依据是 Dosovitskiy 等论文 Figure 1 与 §3.1。能够接上架构不等于已经证明扩展收益;下一页转向实际比较。
本页证据与条件
ViT 2010.11929v2 Figure 1/§3.1;校车图来自 MAE v3 Figure 2;分块为教学示意