训练条件改变,同一对模型的排序也改变
本页问题
ViT Figure3报告带标签预训练、ImageNet微调后的独立分类评价。纵轴为top-1准确率,横轴为ImageNet、ImageNet-21k、JFT-300M三种预训练数据集。粉色B/16与浅蓝L/16保持相同patch边长;在ImageNet列L/16低于B/16,到JFT列则反转。这个结果要求结合训练条件判断结构潜力。数据数量、组成和计算投入同时变化,不能把三个点读成只改样本数的因果实验。
VR02/b0 · 一次读清坐标和一个点的来历
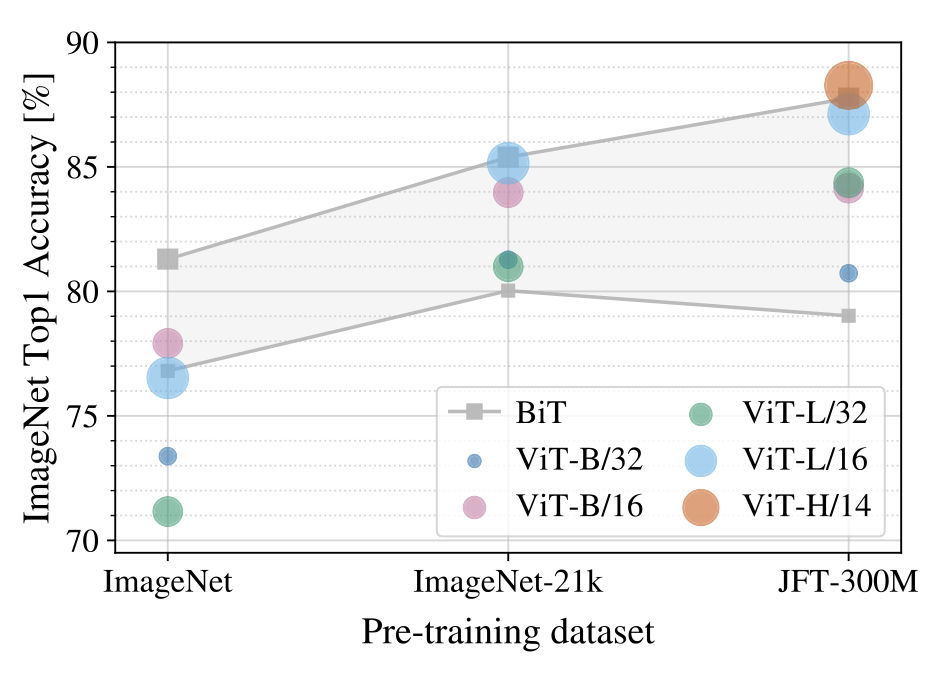
先看一个点的来历:在横轴指定的数据集里,图片和类别目标参与预训练,误差更新模型参数;随后按论文协议到ImageNet做带标签微调,最后用未参与训练的验证图片统计分类top-1正确率。纵轴就是这个百分比,横轴是三个不同预训练数据集。我们固定追踪粉色B/16与浅蓝色L/16,L是更大的配置;16表示相同的patch边长。灰色方点和范围保留为BiT卷积模型参照。
进一步解释
预训练流程中的类别目标来自相应有标签数据集;ImageNet微调继续更新参数,验证阶段统计top-1准确率。课堂校车来自MAE Figure2,仅作输入接口示意,不是此图实验样本。原图未提供供本课逐点复写的精确数表,因此屏幕只比较已确认的相对位置。
教师备课:指图与模拟问答
指图与推进 · 不朗读沿原图纵轴、三个数据集、B/16与L/16图例,再指右侧训练→评价短链。
VR02/b1 · 先看左列,大模型反而更低
只看ImageNet这一列,粉色B/16点高于浅蓝色L/16点:较大的L/16反而较低。两者用同样的patch边长,最终也在同一个ImageNet指标上评价。可见把结构做大,并没有在这套训练条件下自动换来更高正确率。先记住这个排序,保持两种颜色和模型名称不变,再看右列。
教师备课:指图与模拟问答
指图与推进 · 不朗读指左列同一对模型的两个点,用相同颜色保持身份。
VR02/b2 · 同一对模型移到JFT列
在JFT-300M这一列,浅蓝色L/16高于粉色B/16,排序反转。较大的结构在更充分的训练条件下获得更大的相对收益,小条件下的排序因此不能代表它的长期上限。图能直接支持的是这项观察;数据数量、数据组成和训练投入都改变了,仅凭这三个点不能分别算出每个因素的因果贡献。
教师备课:指图与模拟问答
指图与推进 · 不朗读保留原图、颜色和坐标,转向右列的B/L两点。
VR02/b3 · 把这次反转限定在实验实际改变的条件
把两列放在一起,结论是结构与训练条件要共同选择。这里的预训练仍使用类别标签,“预训练”说的是先后阶段,并不等于无标签。三个数据集的数量与组成同时变化,总计算也没有配平;图也没有证明卷积不能扩展。于是自然出现下一问:如果不再额外给每张图片标类别,图片本身还能怎样提供训练目标?
进一步解释
ViT Figure4的同源JFT子集、冻结表示5-shot评价及ConvNeXt反证在相关完整材料。视觉5-shot不是语言提示ICL。
教师备课:指图与模拟问答
指图与推进 · 不朗读指图旁数据/组成/计算条件,保持左右两列可比较;不另读H/14支线。
接下来
标签之外,图像本身能提供怎样的预测任务?
补充推导、边界与来源
采用ViT v2 Figure3原图,保留数据集、模型身份、BiT范围与下游评价流程;不将不同数据集比较变成纯数据量因果实验。
与本页直接相关的完整材料
- N12 · 这张图比较的,究竟是哪一次训练?:原图、逐态说明与已校准推导。
- N13 · 在这个条件下,做大 ViT 没有换来更好成绩:原图、逐态说明与已校准推导。
- N14 · 扩大训练以后,同一对模型的排序变了:原图、逐态说明与已校准推导。
条件、推导与来源
N12 · 这张图比较的,究竟是哪一次训练?
ViT Figure 3 的横轴是 ImageNet、ImageNet-21k、JFT-300M 三个预训练数据集,数量与组成同时变化;纵轴为目标 ImageNet 的 top-1 分类准确率。这里先做带标签预训练,再带着参数到 ImageNet 进行带标签微调与验证集评测。因此“预训练”是学习流程位置,不必然指无标签训练。/16 表示 16×16 像素的 patch。灰色区间来自不同规模 BiT,不是单一小模型。
来源:ViT v2,物理 p.7 Figure 3、§4.3、p.15 Table 5。
相关的完整阅读材料保留原有公式、引用和原始图解。
N13 · 在这个条件下,做大 ViT 没有换来更好成绩
左列比较同一 ImageNet 预训练数据集、同为 /16 patch、同一目标评测下的 B/16 与 L/16。L/16 更大,但该条件中准确率更低。图像局部先验可帮助解释为何卷积在较小训练条件下有效,但这张图不单独识别所有原因,也没有匹配每个模型的参数量与总计算。
来源:ViT v2,Figure 3 左列。
相关的完整阅读材料保留原有公式、引用和原始图解。
N14 · 扩大训练以后,同一对模型的排序变了
JFT-300M 列中 L/16 高于 B/16,修正了仅凭左列得出的扩展判断。该图换了数据集数量和组成,训练计算也不完全相等,因此不把全部增益归为纯样本数。
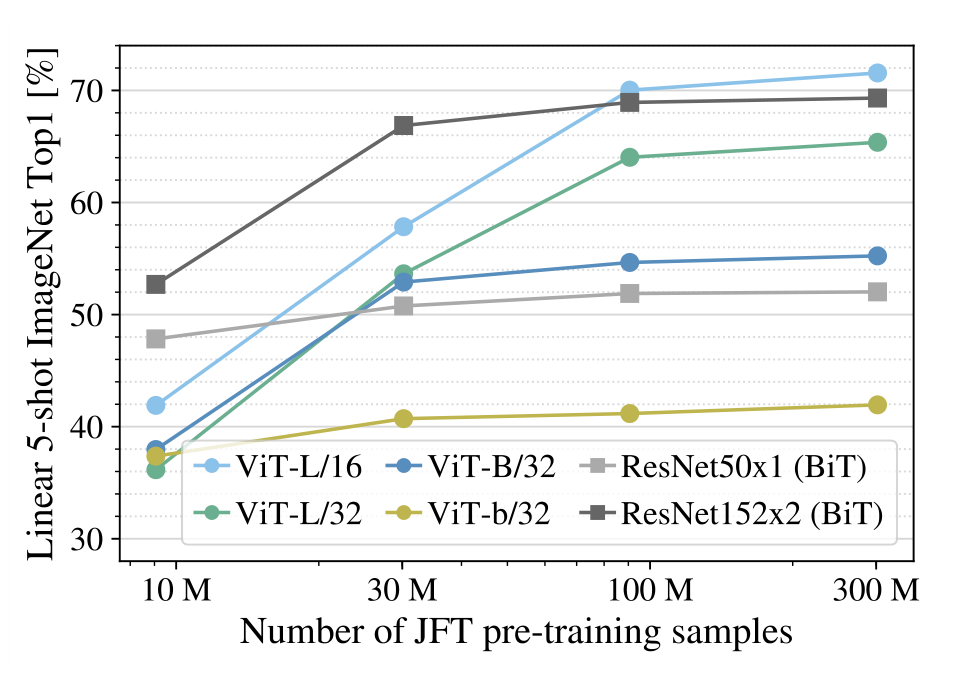
Figure 4 在同源 JFT 子集上补充研究规模变化,其 5-shot 指冻结表征后拟合线性分类器,并非语言模型的提示 ICL。
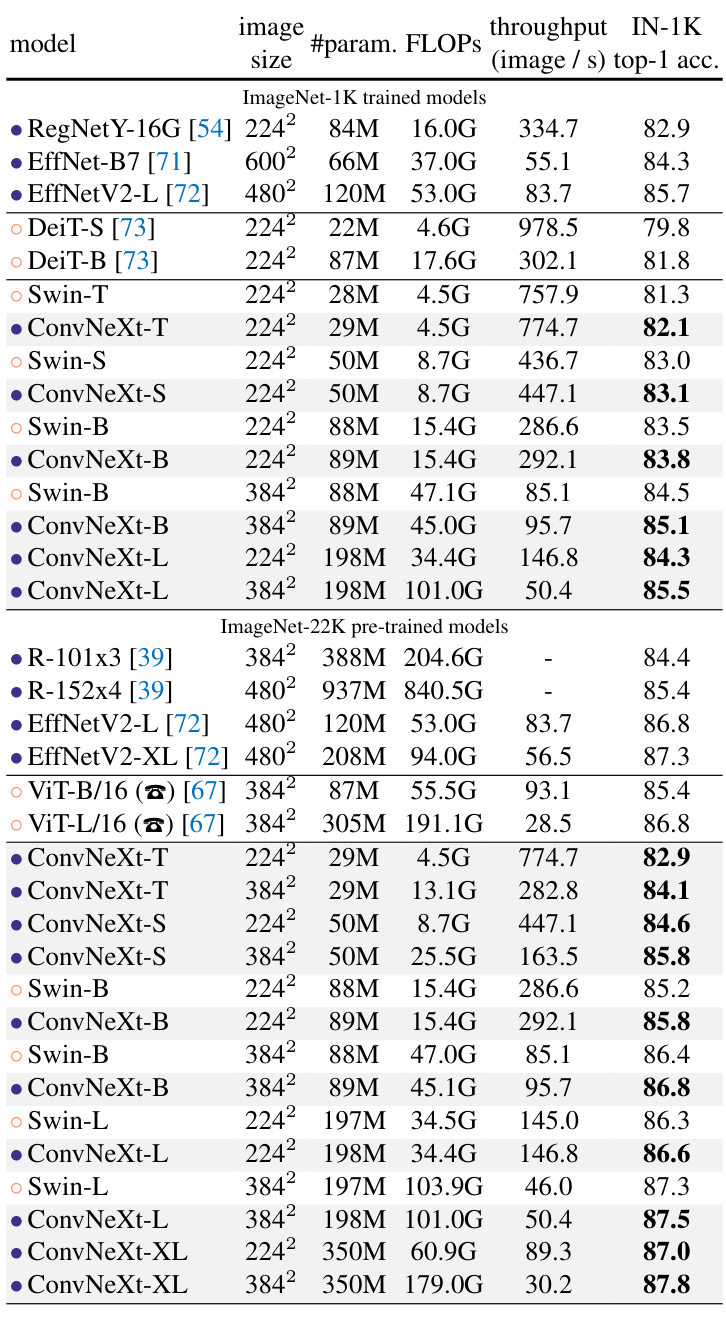
现代卷积同样可以从结构与训练配方获益;本段不主张卷积不能扩展。原图完整条件见视觉扩展正文。
来源:ViT v2,Figure 3/4;ConvNeXt,Table 1。
相关的完整阅读材料保留原有公式、引用和原始图解。
本页证据与条件
ViT v2 Figure3:带标签预训练、ImageNet微调后的独立评价