本页学习说明
GPT-1 Table5的MNLI列:Transformer w/ aux LM (full)为81.8,Transformer w/o pre-training为75.7,差6.1个百分点。两条路线都有下游监督学习;full还包含辅助语言模型目标,w/o aux LM一行为81.1。本页比较预训练消融,不是纯提示zero-shot,也不是相同总训练预算,不与Table2的MNLI-m/mm 82.1/81.4混用。
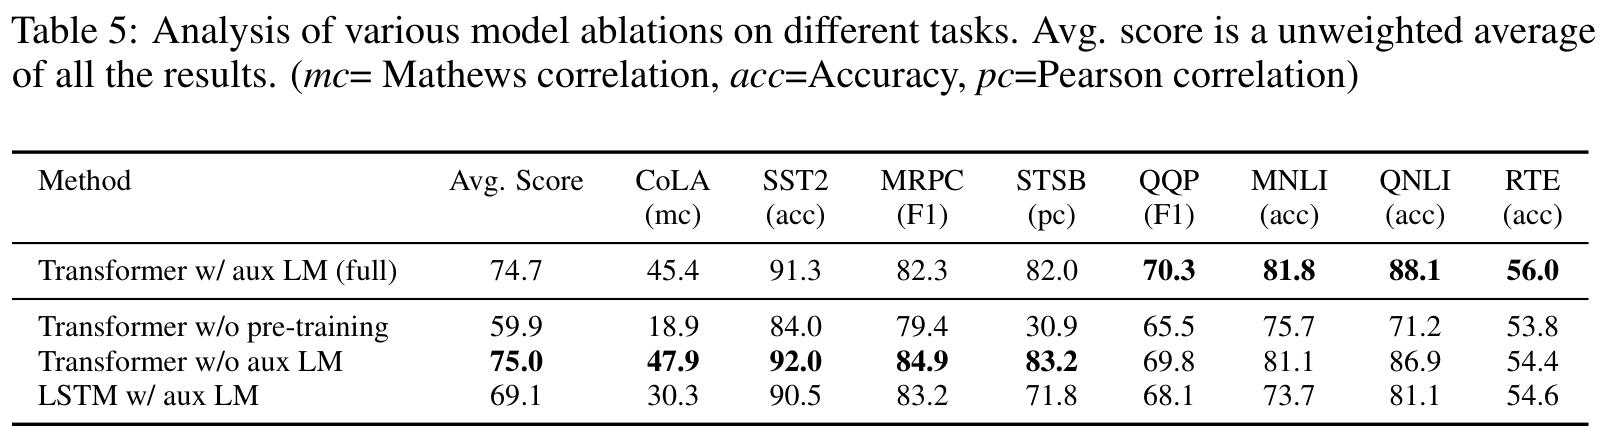
完整迁移比较。
来源与材料身份
- 原始入口:Table5,PDF物理第8页;§3.2–3.3说明下游监督微调与输入转换
阅读完整讲义